La IA lee tu página a trozos. Tres skills gratuitas muestran cuáles
Vectorscope, AI Search Audit Lite y AI Search Audit Full son Agent Skills de código abierto que se ejecutan en tu propio agente. Muestran qué conserva un recuperador de una página, qué descarta y qué reglas publicadas incumple, sin puntuación y sin enviarnos nada.
Traducido del original en inglés.
La respuesta corta
- what
- Tres Agent Skills de código abierto en la versión 2.106: Vectorscope, que muestra cómo lee un recuperador una página; AI Search Audit Lite, que enumera los problemas de una página; y AI Search Audit Full, que explica cada problema, audita hasta 50 páginas y guarda un historial.
- why
- Porque los asistentes de IA responden con pasajes, no con páginas, y la mayor parte de la pérdida ocurre antes de que un modelo lea una sola palabra. Las reglas clásicas de SEO y la preparación para la búsqueda con IA se solapan, pero no son la misma lista.
- who
- Profesionales de marketing que necesitan saber si una página se puede citar, SEO que auditan páginas con las reglas de Google, Bing y los rastreadores de IA, y desarrolladores que construyen o corrigen las páginas.
- where
- En GitHub con licencia MIT, instalables con un solo comando en Claude Code, Codex, opencode y otros agentes que cargan skills SKILL.md, o como zip para claude.ai.
- when
- Publicadas en octubre de 2026. Las ejecuciones de ejemplo citadas aquí se hicieron el 16 y el 17 de octubre de 2026, y cada cita se cotejó con su fuente el 17 de octubre de 2026.
- how
- Scripts deterministas de Node descargan, extraen, trocean y comprueban sin llamar a ningún modelo ni a ninguna API de embeddings; las partes de juicio las escribe el agente que ejecuta la skill, y el informe las marca como suyas. No se envía nada a GetLoopLoop.
Explicación sencilla
Cuando le haces una pregunta a un asistente de IA, no lee sitios web enteros. Primero un programa descarga la página, tira los menús y los botones, y corta el resto en trozos de más o menos una página de libro. Solo se queda con los primeros 26 trozos, y el asistente responde a partir de ellos. Estas tres herramientas gratuitas te enseñan los trozos de tu propia página: cuáles hay, qué partes no entraron en ninguno y qué reglas sencillas de Google y de las empresas de IA incumple la página. Funcionan en tu ordenador, con tu propio asistente de IA.
Pregunta a un asistente de IA por tu producto y no leerá tu página. Leerá unos cuantos trozos. Antes de que un modelo vea una palabra, un rastreador descarga el HTML, un limpiador tira lo que parece mobiliario y un troceador corta el resto en pasajes. Después un recuperador elige los pasajes que parecen respuestas. Lo que no sobrevive a esos pasos no se puede citar, por bueno que sea.
Creamos Vectorscope para hacer visible esa lectura, y este mes lo publicamos, junto con dos auditorías construidas sobre él, como Agent Skills de código abierto. Funcionan en tu propio agente, en tu ordenador, gratis. Los scripts no llaman a ningún modelo ni a ninguna API de embeddings, y no se envía nada a GetLoopLoop. A continuación: para qué sirve cada una, qué encontraron en páginas reales, las nuestras incluidas, y tres simulaciones con páginas sintéticas.
Por qué ahora
Las reglas para que un buscador muestre una página y las reglas para que un asistente de IA la cite han empezado a separarse, y la documentación publicada lo dice sin rodeos.
La guía de Google para AI Overviews y AI Mode los ata a la Búsqueda de siempre. Su página AI features and your website fija un único requisito técnico:
Para poder mostrarse como enlace de apoyo en AI Overviews o AI Mode, una página debe estar indexada y poder mostrarse en la Búsqueda de Google con un fragmento.
Google Search Central, AI features and your website (actualizada el 10 de diciembre de 2025)
La misma página es igual de directa sobre lo que no hace falta: ningún archivo especial, ningún marcado nuevo.
No necesitas crear nuevos archivos legibles por máquinas, archivos de texto para IA ni marcado para aparecer en estas funciones.
Google Search Central, AI features and your website
En junio Google añadió a sus actualizaciones de la documentación una nota sobre llms.txt: esos archivos «no son necesarios para la Búsqueda de Google», aunque se pueden mantener para otros sistemas. Y parte del marcado que antes daba un resultado enriquecido ya no lo da. El resultado enriquecido de preguntas frecuentes, para el que muchos sitios añadieron datos estructurados FAQPage, ya no existe:
Esta función dejará de aparecer en la Búsqueda de Google a partir del 7 de mayo de 2026.
Google Search Central, actualizaciones de la documentación, entrada del 8 de mayo de 2026
Mientras tanto, cada empresa de IA tiene varios rastreadores y cada uno hace un trabajo distinto. La documentación de OpenAI separa OAI-SearchBot, del que depende que un sitio pueda aparecer en las respuestas de búsqueda de ChatGPT, de GPTBot, que recoge datos de entrenamiento, y dice que «cada ajuste es independiente de los demás». Anthropic describe ClaudeBot, Claude-User y Claude-SearchBot del mismo modo, y Perplexity documenta PerplexityBot para la búsqueda y Perplexity-User para las peticiones que hace una persona.
Los sitios que se excluyan de OAI-SearchBot no se mostrarán en las respuestas de búsqueda de ChatGPT
OpenAI, Overview of OpenAI crawlers
Desactivar Claude-SearchBot en tu sitio impide que nuestro sistema indexe tu contenido para la optimización de búsqueda
Anthropic, Does Anthropic crawl data from the web, and how can site owners block the crawler?
Así que una página puede aprobar una lista de SEO y seguir siendo invisible para un asistente, porque una línea de robots.txt bloquea precisamente al rastreador que responde a las personas. Y puede cumplir todas las reglas de rastreo y aun así perder su mejor párrafo más allá del punto en que el recuperador deja de leer. Las dos listas se solapan; no son la misma lista. Las skills comprueban ambas, en local.
Un asistente cita un pasaje, no una página
Abajo está el proceso que reproduce Vectorscope, con los recuentos reales de caracteres de las tres ejecuciones de ejemplo de la skill del 17 de octubre de 2026: nuestra página de Vectorscope, la guía de MDN sobre la caché HTTP y el artículo de Wikipedia sobre grandes modelos de lenguaje.
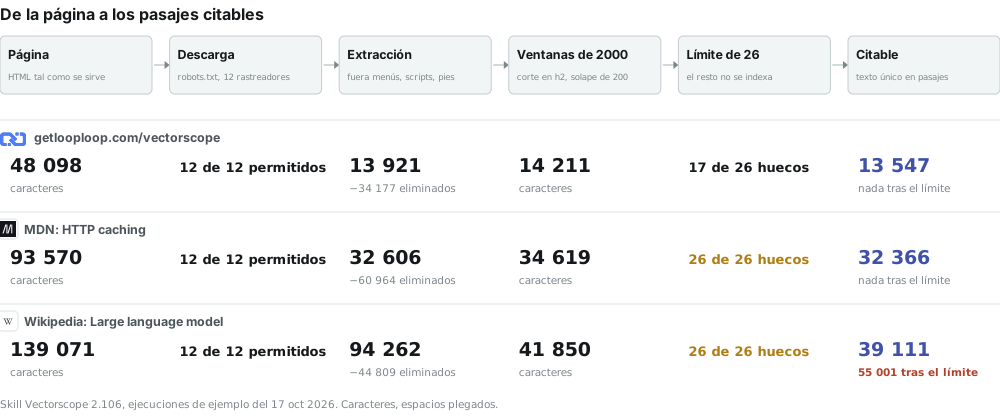
La mayor parte de lo que descarga un rastreador no es texto: en nuestra página, 32 534 de los 34 177 caracteres eliminados eran scripts y estilos. Lo que conserva el limpiador se corta por los encabezados h2 en ventanas de hasta 2000 caracteres, con 200 de solape, y se indexan como mucho 26 pasajes por página. MDN llena todos los huecos y termina justo ahí. Wikipedia llena todos los huecos y sigue otros 55 001 caracteres que ningún pasaje recoge.
El 26 es el límite de Vectorscope, no una cifra que publique ningún asistente. Un límite fijo y conocido vuelve medible la pregunta: ¿qué parte de esta página no alcanzaría nunca un recuperador con límite? (Más en el glosario: encaje con la recuperación y optimización para motores generativos.)
Vectorscope: cómo lee un recuperador una página
Qué hace. La skill Vectorscope aplica a cualquier URL pública exactamente la misma descarga, extracción, troceado y límite de 26 pasajes que el producto, comprueba robots.txt para doce rastreadores, de GPTBot y OAI-SearchBot a Claude-SearchBot, PerplexityBot, Google-Extended y CCBot, con las reglas de RFC 9309, y hace comprobaciones de estructura: respuestas de FAQ que perdieron su pregunta, pasajes que empiezan a media frase, líneas de menú dentro del texto, secciones escuálidas, una misma afirmación en todas partes, canonical, JSON-LD y meta description.
En qué se diferencia de la herramienta web. El Vectorscope web agrupa los pasajes por sus embeddings. La skill no llama a ningún embedding, así que el agente que la ejecuta lee los pasajes y los agrupa por tema, y el informe lo dice en cada grupo.
Para quién. Para quien escribe y quiere saber si los párrafos clave de una página llegan siquiera a un pasaje, para los SEO que explican por qué una página larga rinde poco en las respuestas de IA y para los desarrolladores que quieren ver qué le hace su marcado al texto.
Qué muestra el informe. Un único archivo HTML autónomo, en inglés o en ucraniano. Cada número lleva una etiqueta: medido, derivado (con una fórmula fija) o juicio (del agente), y un «?» a su lado abre la fórmula. Una sección plegada, Adónde va el texto, sigue los caracteres desde el HTML bruto hasta los pasajes: qué eliminó el limpiador, elemento por elemento, y cuánto de cada sección llegó a un pasaje. Después viene la parte del agente: grupos por tema, una prueba de 5 a 10 preguntas típicas con las palabras exactas que un recuperador podría citar, y un plan de reescritura con el texto de antes y de después. El modo comparación pone de 2 a 5 páginas en una sola tabla de temas.
Esta es la sección plegada del artículo de Wikipedia sobre grandes modelos de lenguaje, leído el 17 de octubre de 2026.
Pruébelo en una página propia
Vea qué encuentra Vectorscope en una página suya
Todo lo anterior se puede medir en su propio trabajo, y la comprobación lleva cerca de un minuto. Pegue una dirección y lea lo que vuelve.
Abrir VectorscopeGratis · sin cuenta · una cada vez
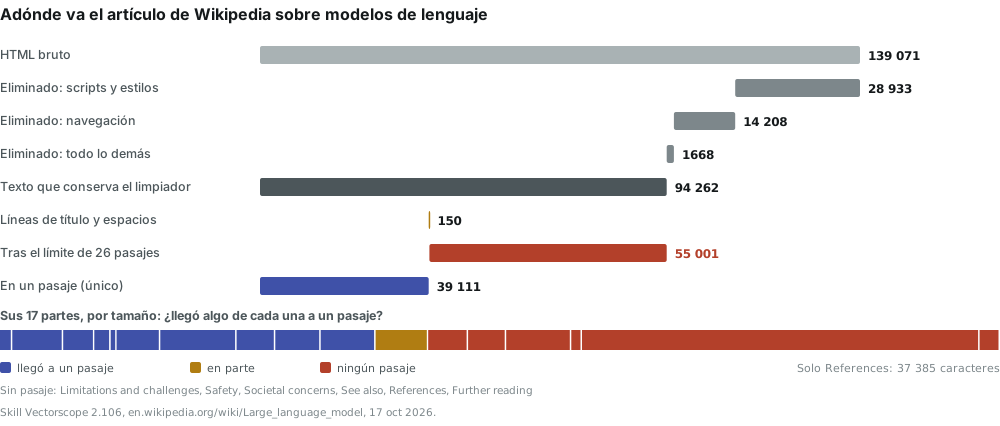
Conviene leer esta figura con justicia, porque una cifra como «55 001 caracteres perdidos» es fácil de exagerar. De las seis partes que no llegan a ningún pasaje, References tiene 37 385 caracteres por sí sola, y nadie necesita que un recuperador cite una lista de referencias. Pero tres son prosa: Limitations and challenges, Safety y Societal concerns, 13 448 caracteres entre las tres, y Evaluation llega a un pasaje con 3801 de sus 4952. Un recuperador con límite que leyera este artículo en orden sabría mucho de cómo se construyen los modelos de lenguaje y nada de lo que falla en ellos. Para hallazgos así existe la herramienta: no una nota, sino un lugar.
Nuestra propia página de Vectorscope, leída el mismo día, necesita 17 pasajes y no pierde nada por el límite. Pero tampoco está limpia. La skill señala dos pasajes que empiezan a media frase, seis líneas de menú dentro del texto (las etiquetas de los pasos del propio proceso, de «1. Fetched» a «5. Grouped»), una sección de 139 caracteres demasiado corta para sostenerse sola y una frase repetida en tres grupos de temas. Lo dejamos en el ejemplo a propósito.
AI Search Audit Lite: una página frente a las reglas publicadas
Qué hace. Lite comprueba una página pública con las reglas que publican Google, Bing y las empresas de IA, con la lectura de Vectorscope al lado: robots.txt para rastreadores de búsqueda y de IA, noindex y controles de fragmento, el sitemap; una lista de Google y Bing de 35 casillas, desde la longitud del title y el orden de los encabezados hasta enlaces rotos, imágenes, variantes de URL y cabeceras de respuesta; datos estructurados frente a las propiedades que enumera Google, con la fecha de retirada de los resultados enriquecidos; versiones de idioma, descargando cada alternativa de hreflang para ver si enlaza de vuelta; y la presencia de señales E-E-A-T, es decir, si existen un autor, los enlaces «Sobre nosotros» y «Contacto» y los datos de la organización, no un juicio sobre la experiencia que hay detrás.
Tres lecturas que solo una IA puede hacer. El agente que ejecuta la skill escribe de 8 a 12 preguntas que la gente hace sobre el tema, y el script comprueba cada una contra un pasaje con una cita literal. Después el modelo del agente responde cinco preguntas de comprador sobre la marca con su propio conocimiento y dice qué cree sobre la valoración de la marca en doce plataformas de reseñas más una plataforma de control inventada: una valoración en una plataforma que no existe es una alucinación. Es la visión de un solo modelo, con su nombre; las versiones web de Brandscope y Reviewscope preguntan a tres asistentes.
Qué no hace. Cada problema es una etiqueta corta, una gravedad y un lugar en un mapa de la página. Ni puntuación ni consejos. Sobre una lista de errores con pruebas dos personas pueden ponerse de acuerdo; una puntuación invita a discutir los pesos.
Para quién. Para quien tiene que responder «¿hay algo roto en esta página?» y pasar la lista a quien lo arregle.
Lite incluye cinco ejecuciones reales del 17 de octubre de 2026. Tres son páginas nuestras.
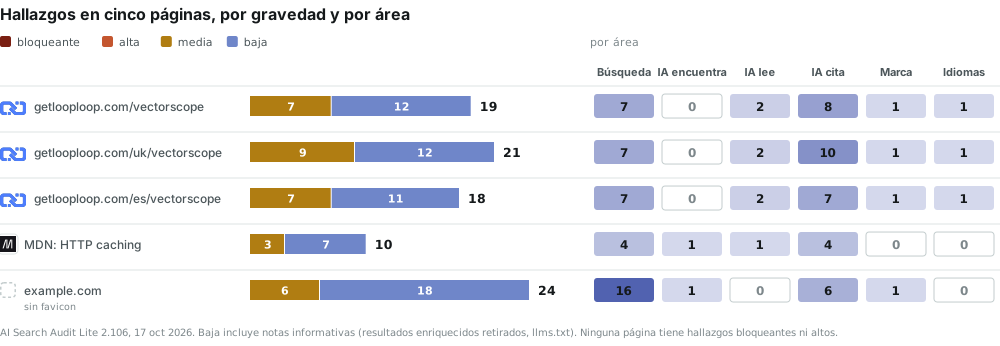
Nuestra página de Vectorscope en inglés tiene 19 hallazgos, ninguno bloqueante. Los dos más concretos son incómodos de la forma útil: dos enlaces a artículos que devuelven 404 y un marcado SoftwareApplication sin los campos que Google exige para ese tipo. La página aún lleva marcado FAQPage y HowTo para resultados enriquecidos que Google ya no muestra, y Lite lo da como nota informativa, no como error. Dos de las doce preguntas que escribió el agente no tienen respuesta en ninguna parte de la página. Y el modelo que hizo la auditoría, Claude Opus 5.5 en Claude Code, no conocía GetLoopLoop por sí mismo y lo dijo: la auditoría lo registra como brand_unknown, que es el resultado honesto para un producto joven y una razón para que la página responda lo que un modelo no sabe.
example.com, el dominio reservado para documentación, tiene más hallazgos que nadie, 24, casi todos por la ausencia de lo que tendría un sitio real: sin h1, sin descripción, sin favicon, variantes http y www que no redirigen. MDN tiene los menos, 10, y sus hallazgos medios tratan de la lectura, no de las reglas: seis pasajes empiezan a media frase.
AI Search Audit Full: la explicación, el sitio y el historial
Full ejecuta todas las comprobaciones de Lite y añade lo que un especialista necesita para actuar.
Tres capas por problema. Qué falla, en palabras sencillas y sin consejos. Qué dice la regla, una cita literal breve de la fuente oficial con su enlace y la fecha de comprobación, o una nota de que el umbral es de la propia skill cuando nadie publica uno. Y una dirección de corrección, escueta y técnica, plegada en los detalles para especialistas. La versión 2.106 lleva 83 citas, cada una cotejada palabra por palabra con su página el 17 de octubre de 2026.
Hasta 50 páginas. Desde una lista de URL o un sitemap, de una en una, con al menos un segundo entre ellas y solo donde robots.txt lo permite. El informe del sitio añade los problemas repetidos entre páginas y las comprobaciones que solo un conjunto de páginas permite: titles duplicados, páginas huérfanas, profundidad de enlaces, pares hreflang, cadenas de canonical.
Antes/después e historial. --compare old-export.json da los hallazgos corregidos, nuevos y sin cambios. Además, cada ejecución se guarda como instantánea en tu ordenador, así que cada informe muestra qué cambió desde la anterior, hasta el nivel de los pasajes.
El ejemplo es una auditoría de tres páginas de getlooploop.com: la página de Vectorscope en inglés, ucraniano y español.
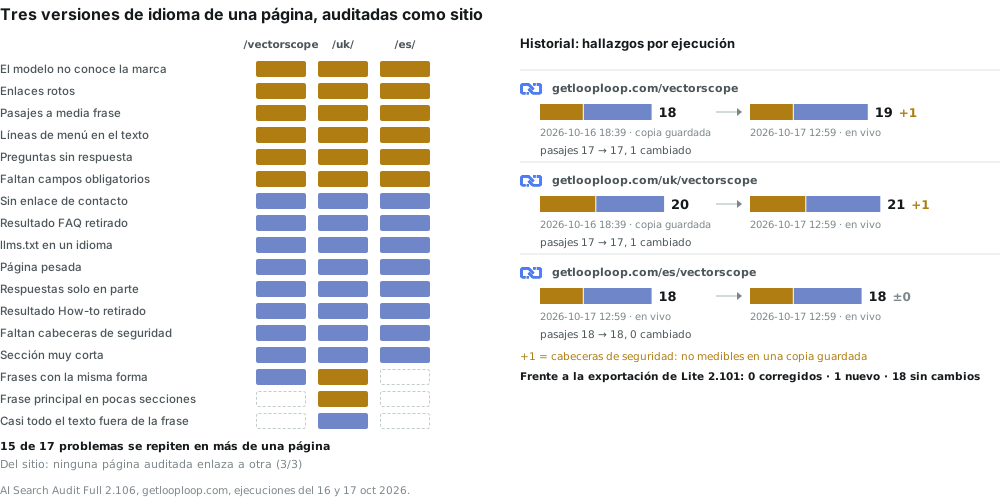
Quince de los diecisiete tipos de problema se repiten en más de una página, y ahí está el valor práctico de un informe de sitio: un problema que aparece en todas las versiones de idioma es una corrección en una plantilla, no tres tickets. La comprobación de sitio encontró algo que ninguna auditoría de una sola página puede ver: ninguna de las tres versiones enlaza a otra, así que cada una es huérfana dentro del conjunto auditado. (La propia skill añade la salvedad: puede que alguna página fuera del conjunto la enlace.)
El historial pide una lectura atenta. Entre las dos ejecuciones /vectorscope pasó de 18 hallazgos a 19, y nada empeoró: la primera leyó una copia guardada el día anterior, un archivo guardado no tiene cabeceras de respuesta HTTP, así que la comprobación de cabeceras se dio como no medida; la ejecución en vivo las midió y encontró que faltaban tres cabeceras de seguridad. La deriva muestra que las palabras pasaron de 2463 a 2469 y el único pasaje de los 17 que cambió. La comparación con una exportación de Lite 2.101 de la misma página dice lo mismo a su manera: 0 corregidos, 1 nuevo, 18 sin cambios, y el nuevo es la comprobación que añadió la 2.102.
Sobre el marcado FAQ de la página, la explicación dice que el marcado no hace daño pero ya no consigue el resultado para el que se añadió, cita las actualizaciones de la documentación de Google con el enlace y la fecha de comprobación, y da al especialista una dirección: nada obligatorio para Google; mantenlo si otro consumidor lo lee, o quítalo para aligerar la página.
Cuál ejecutar
Las tres skills comparten un núcleo. Lite y Full llevan el código de lectura de Vectorscope sin cambios, así que un recuento de pasajes o una cifra tras el límite significan lo mismo en los tres informes. Se diferencian en la pregunta que responden.
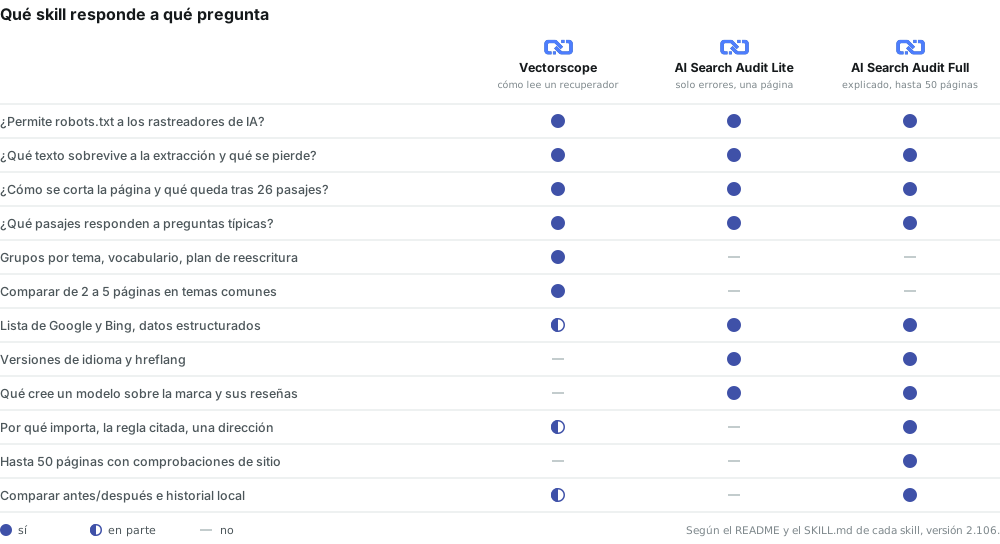
- Quien lleva marketing o contenidos y tiene una página que importa necesita Vectorscope: qué párrafos llegan a un pasaje, qué preguntas responde la página con palabras citables y cómo reescribir las débiles.
- Un SEO necesita Lite para la lista y Full para el informe: la regla citada de su fuente zanja el «¿quién lo dice?», y el informe de sitio convierte cincuenta páginas de hallazgos en unas pocas correcciones de plantilla.
- Un desarrollador recibe las direcciones de corrección de Full y la tabla de eliminaciones de Vectorscope, que nombra cada elemento eliminado, su ruta CSS y sus caracteres.
Tres simulaciones con páginas sintéticas
Las páginas reales muestran lo que encuentran las herramientas; las sintéticas, cómo se comportan, porque se puede cambiar una sola cosa y ver aparecer o desaparecer un hallazgo. Escribimos pequeñas páginas HTML sobre un tema ficticio, el mantenimiento de la bicicleta en casa, en el dominio reservado example.com, y pasamos cada una por AI Search Audit Lite 2.106 en modo copia guardada (--html para la página, --robots para robots.txt): nada se descarga, no se llama a ningún modelo, las mismas cifras en cualquier máquina. El texto sale de plantillas de frases, y la herramienta lo nota: cada página recibe un hallazgo repeated_sentence_shape, que es correcto y se queda en los recuentos.
1. Una guía de 40 secciones frente al límite de 26 pasajes
Una página, 40 secciones h2 de unos 1400 caracteres cada una, de la presión de los neumáticos a la revisión antes de salir. Cada sección cabe en una ventana, así que la página necesita 42 pasajes: uno para el título, uno para la entradilla y uno por sección.
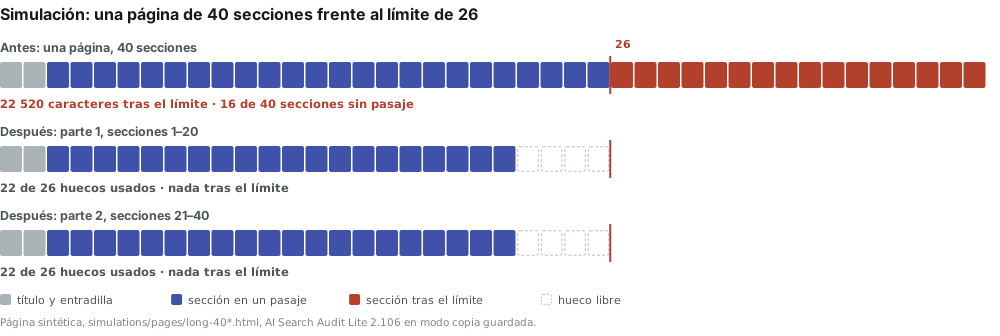
El límite cortó la guía tras la sección 24. De la 25 a la 40, de Saddle setback a A pre-ride check, no llegan a ningún pasaje: 22 520 de los 56 789 caracteres que conservó el limpiador. Lite lo da como su único hallazgo alto, cap_overflow, y su veredicto (el informe está en inglés y ucraniano) dice «1 problem hides text from AI». Dividida en dos páginas de 20 secciones, cada parte usa 22 de 26 huecos, nada queda tras el límite y el hallazgo alto desaparece: 8 hallazgos antes, 7 por parte después; el resto son el hallazgo de las plantillas y el marcado que le falta a una página sintética. Dividir no es la única solución: subir las secciones por las que de verdad pregunta la gente cambia cuáles 24 entran. En una página larga, el orden es una decisión sobre lo que un recuperador con límite no leerá nunca.
2. Un robots.txt que bloquea al rastreador equivocado
Una página corta y normal, ejecutada dos veces con dos archivos robots.txt. El primero bloquea a dos rastreadores y deja pasar a todos los demás:
User-agent: OAI-SearchBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: *
Allow: /| robots.txt | Hallazgos | Bloqueantes | Qué dice la auditoría |
|---|---|---|---|
| Bloquea OAI-SearchBot y ClaudeBot | 8 | 1 | OAI-SearchBot bloqueado (bloqueante); ClaudeBot bloqueado (baja) |
| Deja pasar a todos | 6 | 0 | Nada sobre rastreadores |
Los dos bloqueos no pesan lo mismo, y de eso se trata. Bloquear OAI-SearchBot deja la página fuera de las respuestas de búsqueda de ChatGPT, así que Lite lo marca como bloqueante y su veredicto dice «1 problem blocks search or AI». Bloquear ClaudeBot solo detiene a un rastreador de entrenamiento: el rastreador de búsqueda de Anthropic, Claude-SearchBot, tiene su propio token y el grupo * lo sigue dejando pasar. Por eso Lite lo da como bajo, una decisión que el propietario puede haber tomado a propósito. Cada hallazgo enlaza a la página de rastreadores del proveedor, así que quien lee puede comprobar la diferencia por sí mismo.
3. Respuestas de FAQ que pierden su pregunta
Seis preguntas y respuestas en un acordeón. En la primera versión cada pregunta es la etiqueta de un <button> que abre su panel, un patrón habitual. En la segunda, cada pregunta es el <summary> de un elemento <details>. La página visible es la misma.
| Marcado | Hallazgos | Altos | Caracteres eliminados | Qué contiene el pasaje |
|---|---|---|---|---|
| Preguntas en <button> | 4 | 1 | 402 | 6 respuestas, 0 preguntas |
| Preguntas en <summary> | 3 | 0 | 146 | 6 respuestas con sus preguntas |
El limpiador de un recuperador elimina los botones, porque en la mayoría de las páginas un botón es mobiliario: «Suscribirse», «Aceptar cookies», «Siguiente». Aquí esa regla se lleva las preguntas. La diferencia de caracteres eliminados, 256, es exactamente la longitud de las seis preguntas. Queda un pasaje de respuestas que empiezan por «Yes, if your bike has carbon parts» y «No, not for long», sin nada que diga a qué responden. La comprobación lost_faq_questions de la skill lo detecta como alto: seis inicios de respuesta y ningún signo de interrogación en el pasaje. Con las preguntas en <summary>, el hallazgo desaparece.
También quisimos simular un hreflang que no enlaza de vuelta, y lo dejamos fuera. Esa comprobación descarga cada alternativa, el modo copia guardada no descarga nada y la skill rechaza a propósito las direcciones locales, así que la simulación habría sido nuestro script, no la skill.
Instalar y ejecutar
Cada skill necesita Node 20.18 o posterior y ningún npm install: los scripts vienen empaquetados. Con la CLI de skills, un solo comando instala una skill para Claude Code, Codex, opencode y otros agentes que cargan skills SKILL.md:
npx skills add Olexan-art/getlooploop-skills --skill vectorscope
npx skills add Olexan-art/ai-search-audit
npx skills add Olexan-art/ai-search-audit-full
Después pídeselo a tu agente con palabras normales: «run vectorscope on https://example.com/page» o «an AI search audit of https://example.com/page». Para claude.ai y la aplicación de escritorio de Claude, descarga el zip de la versión (vectorscope.zip, ai-search-audit.zip o ai-search-audit-full.zip), activa la ejecución de código y súbelo en Customize > Skills sin descomprimirlo. El entorno aislado necesita acceso de red al sitio que lee; cada README indica los ajustes.
Los repositorios, todos con licencia MIT: getlooploop-skills para Vectorscope, ai-search-audit para Lite y ai-search-audit-full para Full. La configuración también está en Agent Skills para equipos de SEO, GEO y marketing. Por debajo, el agente ejecuta dos scripts, con sus propios archivos de juicio en medio:
node dist/read.mjs https://example.com/page --out reading.json
# el agente escribe questions.json, brand.json y reviews.json
node dist/audit.mjs reading.json --questions questions.json \
  --brand brand.json --reviews reviews.json --html report.html

# sin red: auditar una copia guardada
node dist/read.mjs https://example.com/page --html page.html \
  --robots robots.txt --out reading.json

# solo Full: hasta 50 páginas y luego un informe de sitio
node dist/read.mjs --urls urls.txt --out-dir readings
node dist/audit.mjs --site readings/site.json --questions-dir questions --out-dir report
Lo que no hacen
- Ninguna puntuación. Ninguna de las tres clasifica una página ni le pone una nota sobre 100. Informan de hallazgos, cada uno con su prueba y la regla en que se apoya.
- Ninguna predicción. No dicen qué responderán ChatGPT, Gemini o Perplexity sobre ti. Las lecturas de marca y de reseñas son el conocimiento de un modelo en su fecha de entrenamiento, etiquetadas con su nombre, y no una medición de ningún asistente.
- Ninguna detección de texto escrito por IA. Las comprobaciones de estilo cuentan frases hechas y formas de frase repetidas, con su posición. Son señales para quien edita, no un veredicto sobre quién escribió la página.
- Las capas de juicio son la lectura de un agente. Los grupos por tema, las preguntas, los veredictos sobre si un pasaje las responde y el plan de reescritura los escribe el agente que ejecuta la skill. Los scripts los validan (cada cita debe ser literal de su pasaje) y el informe los marca, pero otro modelo podría agrupar los mismos pasajes de otra forma.
- Ni datos de campo ni estado en el índice. Core Web Vitals y «¿está esta página en el índice de Google?» siempre figuran como no medidos: necesitan datos de usuarios reales y Search Console.
- Solo páginas públicas. Sin inicio de sesión, sin cookies, sin direcciones locales ni privadas. Cada límite (30 enlaces, 20 imágenes, 10 versiones de idioma, 50 páginas) se nombra en el informe y ninguno se aplica en silencio.
Dónde va más allá el producto en vivo
Las skills responden qué es una página hoy para una máquina que la lee. No pueden decir qué responden de verdad los asistentes que usa la gente ni cómo cambia eso. Eso es lo que hace GetLoopLoop: pregunta a asistentes reales, de forma programada, lo que preguntan tus compradores y registra qué marcas y páginas citan, para que veas tu cuota de respuestas a lo largo de semanas y no la opinión de un modelo una sola vez. El Vectorscope web añade el mapa basado en embeddings que la skill deja fuera a propósito, y Brandscope y Reviewscope preguntan a tres asistentes en lugar de a uno. Cómo medimos está en la metodología.
Pero empieza por la página. Ejecuta una de las skills sobre la página que más te importa, mira adónde va su texto y corrige lo primero que encuentre. A juzgar por nuestras propias páginas, algo habrá.
El producto
Véalo en cada página, cada día
Una lectura dice dónde está una página hoy. El producto hace las mismas preguntas a los mismos asistentes de forma continua, así que un cambio es algo que se le cuenta y no algo que tenga que ir a buscar.
Pedir una invitaciónSolo por invitación mientras mantenemos honestas las lecturas
Sobre este tema
¿Está mi página lista para la búsqueda con IA?
Cada día Rastreos con la lectura de Vectorscope junto a cada página, comprobada de nuevo tras cada corrección. Cómo funciona el producto
Autor
Olexandrautor
Más de 15 años en marketing y SEO. Decenas de productos, sobre todo el mercado estadounidense. Investigación y medición.
LinkedInPass it on
Read in your language
Opens a browser translation of this English article. The original source stays in English.