01 Qué le pasa a una página antes de que un asistente de IA pueda citarla
Antes de que un asistente de IA cite una página, una máquina tiene que descargarla, reducirla a texto, cortar ese texto en pasajes y guardar algunos; después el asistente recupera pasajes, no páginas. Esa es la forma de la generación aumentada por recuperación tal como se bautizó en 2020: un recuperador encuentra pasajes en un índice y un generador escribe a partir de ellos [16]. El artículo original dividió Wikipedia en pasajes de 100 palabras antes de indexar nada [16].
La descarga la hacen rastreadores con nombre que publican para qué sirven. OpenAI separa el bot que reúne datos de entrenamiento del que encuentra páginas para la búsqueda de ChatGPT y del que abre una página que pidió un usuario [9]; Anthropic y Perplexity hacen las mismas distinciones con sus bots [10] [11]. Google indica que, para aparecer en sus funciones de IA, una página tiene que estar indexada y ser apta para mostrarse con fragmento [1], y Bing, que Copilot se apoya en el mismo rastreo e indexación que su buscador [14].
Lo que el rastreador conserva es texto. Googlebot ejecuta JavaScript en una fase posterior [7], pero cuando Vercel midió su propia red en diciembre de 2024, los grandes rastreadores de IA descargaban archivos JavaScript sin ejecutarlos [8], y Common Crawl indica que su CCBot tampoco ejecuta JavaScript [12]. Las palabras que solo existen después de ejecutar un script, para esos rastreadores, no existen.
- Descarga Un GET del HTML, como un rastreador. No se ejecuta ningún script.
- Texto Sin menús, pies ni marcado; queda el texto legible.
- Pasajes Corte en cada h2 y luego en ventanas de unos 2000 caracteres.
- Límite Se guardan 26 pasajes como máximo. Lo demás nunca se almacena.
- Recuperación Una pregunta se compara con pasajes, nunca con la página.
El corte y el límite de 26 pasajes son reglas de nuestro Vectorscope gratuito y de esta skill. Ningún asistente publica su propio límite de pasajes; 26 es un modelo de trabajo de un límite, no una cifra tomada de ninguno de ellos.
02 Por qué cada pasaje tiene que entenderse solo
Un pasaje que necesita el anterior para tener sentido no se puede citar, porque el recuperador lo entrega solo. Anthropic, al explicar la recuperación contextual, describe justo ese fallo: al dividir un documento en fragmentos, un fragmento suelto puede perder el contexto que decía de qué trataba [18]. La guía de Pinecone enuncia la regla desde el otro lado: si un fragmento se entiende sin el texto que lo rodea, también lo entenderá el modelo [19].
También funciona sin conexión. El precio de esto empieza en el segundo plan y se puede desactivar por proyecto.
¿El editor funciona sin conexión? Sí: el editor de escritorio funciona sin conexión. El modo sin conexión se incluye desde el segundo plan y se desactiva por proyecto.
La posición importa incluso después de recuperar. Liu y sus coautores encontraron que los modelos de lenguaje a menudo aprovechan mejor la información cuando está al principio o al final de un contexto largo, y bastante peor cuando está en medio [17]. Una página no elige dónde cae su pasaje; sí puede hacer que lleve su propio tema.
La mayoría de los flujos cortan primero por tamaño. El valor por defecto habitual en las herramientas de RAG es un tamaño fijo con solape, cortando por párrafos y saltos de línea cuando se puede [20]. Una ventana cortada así no sabe dónde termina tu respuesta.
Una advertencia honesta: Google indica que su Búsqueda no necesita el contenido dividido en trozos pequeños, porque sus sistemas encuentran solos la parte relevante de una página [2]. Una skill de Claude Code para búsqueda con IA no cambia eso, y esta no lo intenta. Trata de los recuperadores que guardan pasajes, y Bing, por ejemplo, indica que una URL tiene más probabilidad de elegirse para fundamentar y citar cuando su contenido se entiende solo [14].
03 Qué hace la skill, paso a paso
Una skill es una carpeta con un archivo de instrucciones SKILL.md que carga un agente. Claude Code encuentra las skills en tus carpetas personal y de proyecto, usa una cuando procede y te deja llamarla por su nombre, aquí /vectorscope [21]; otros agentes cargan la misma carpeta desde sus propios directorios de skills, que aparecen más abajo. Como skill de Claude Code para búsqueda con IA, Vectorscope reparte el trabajo entre dos scripts con reglas fijas y los pasos que son criterio del agente, a cargo del modelo con el que funciona tu agente; en Claude Code es Claude.
-
Leer la página
dist/read.mjsdescarga la URL con un GET simple y lee el robots.txt del sitio, rechaza direcciones privadas y locales, extrae el texto visible, lo corta en cada h2 y luego en ventanas de unos 2000 caracteres con 200 de solape, aplica el límite de 26 pasajes y marca los pasajes que parecen enlaces relacionados o letra pequeña. Con--renderabre además la página en un Chrome, Chromium o Edge local con un perfil desechable e indica cuántas palabras existen solo después de ejecutar JavaScript; la lectura en sí sigue siendo la descarga simple. -
Agrupar los pasajes
El agente lee cada pasaje completo y escribe
groups.json: seis grupos por tema como máximo, cada uno con un nombre en el idioma de la página. Es un criterio —la herramienta web agrupa con embeddings y la skill, leyendo— y el siguiente script rechaza una agrupación que deje fuera un pasaje o cuente uno dos veces. -
Escribir el informe
dist/lens.mjscomprueba la agrupación, ejecuta todas las comprobaciones y escribe un informe HTML autónomo, Markdown y JSON; el informe siempre se muestra, no solo se nombra. Cada sección y cada número llevan una etiqueta —medido por el analizador, derivado por una fórmula fija o criterio del agente—, y un «?» junto a cada número abre su fórmula, unidad, umbral y límites. El panel informativo de arriba explica las etiquetas y nombra el modelo que juzgó. Selector EN | UK, dos temas y una política de seguridad de contenido que bloquea cualquier petición de red. -
Mostrar adónde va el texto
Una cascada de caracteres sigue la página desde el HTML bruto hasta los pasajes: lo que quitó el limpiador, lo que quedó, lo que llegó a pasajes y lo que quedó fuera del límite. Una tabla lista qué quitó el limpiador y por qué —el elemento, su ruta CSS, sus caracteres, cómo empieza su texto— y un mapa de secciones muestra cuánto de cada h2 llegó a un pasaje. Lo que queda fuera del límite se cuenta desde el texto único de los pasajes: 55 001 caracteres en el ejemplo de Wikipedia, donde restar todo lo guardado, solapes e introducción incluidos, da 52 973.
El informe también muestra el vocabulario propio de la página, frases primero: de dos a cuatro palabras que la página escribe juntas en al menos dos pasajes, y después palabras sueltas del relato que ninguna frase usó ya. Es lo que dice la página, no demanda de búsqueda; para ver cómo pregunta la gente está la prueba con preguntas.
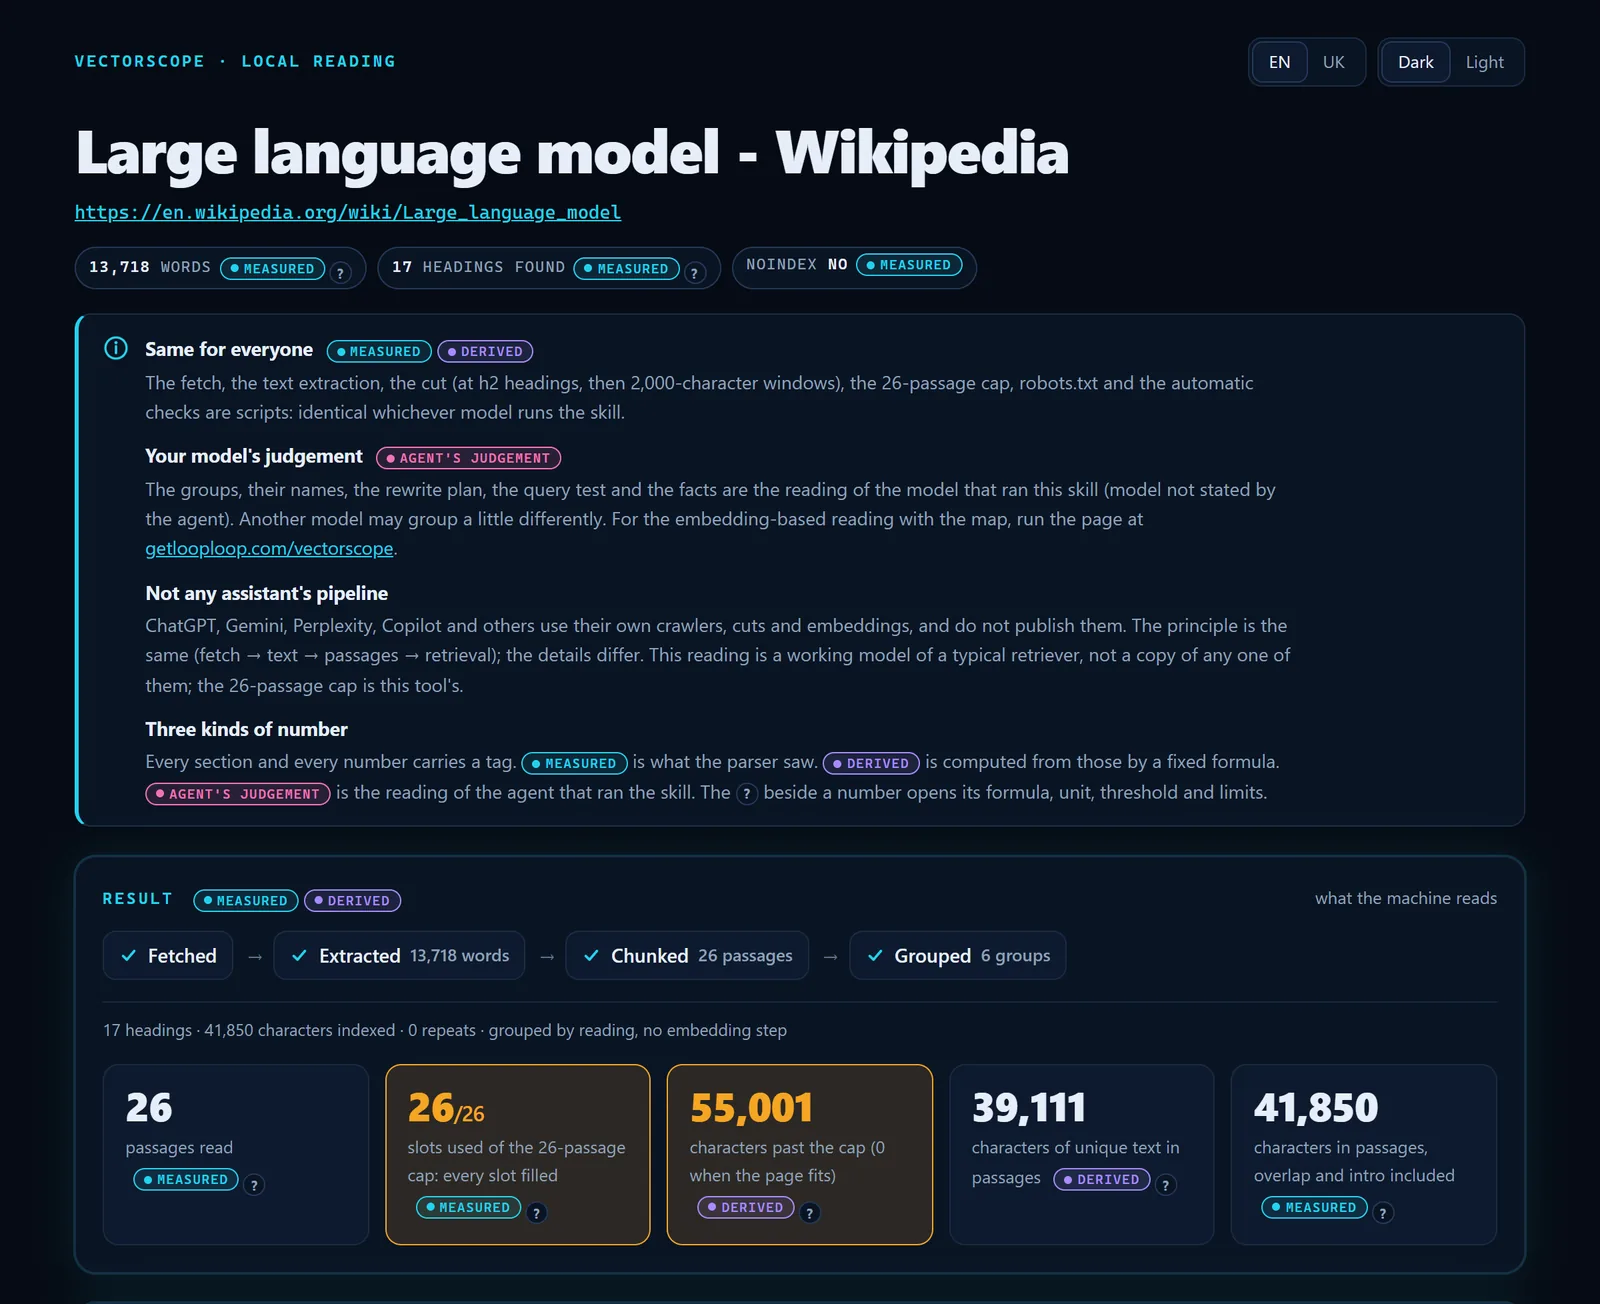
- Una etiqueta junto a cada número: medido, derivado o criterio del agente.
- El panel informativo explica cada etiqueta.
- 55 001 caracteres fuera del límite, contados desde el texto único.
- Texto único en pasajes, junto al total con solapes e introducción.
- El «?» abre cómo se calcula un número.
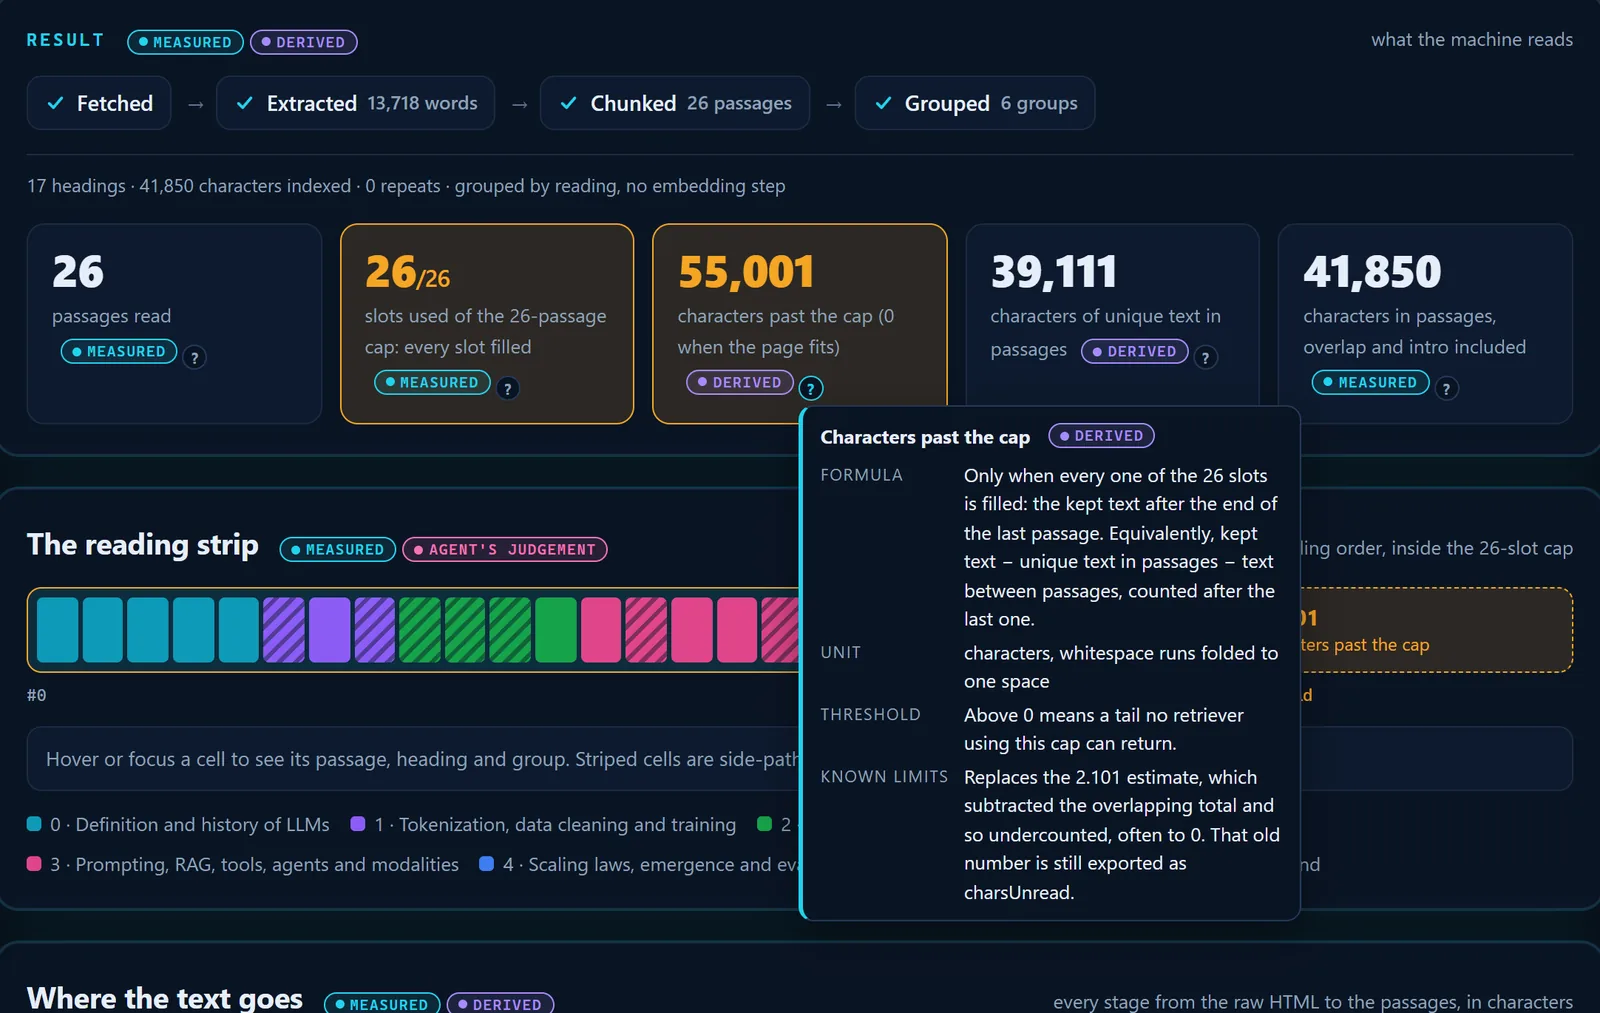
- El «?» junto al número.
- La fórmula, en palabras.
- Límites conocidos, incluido lo que hacía el recuento anterior.
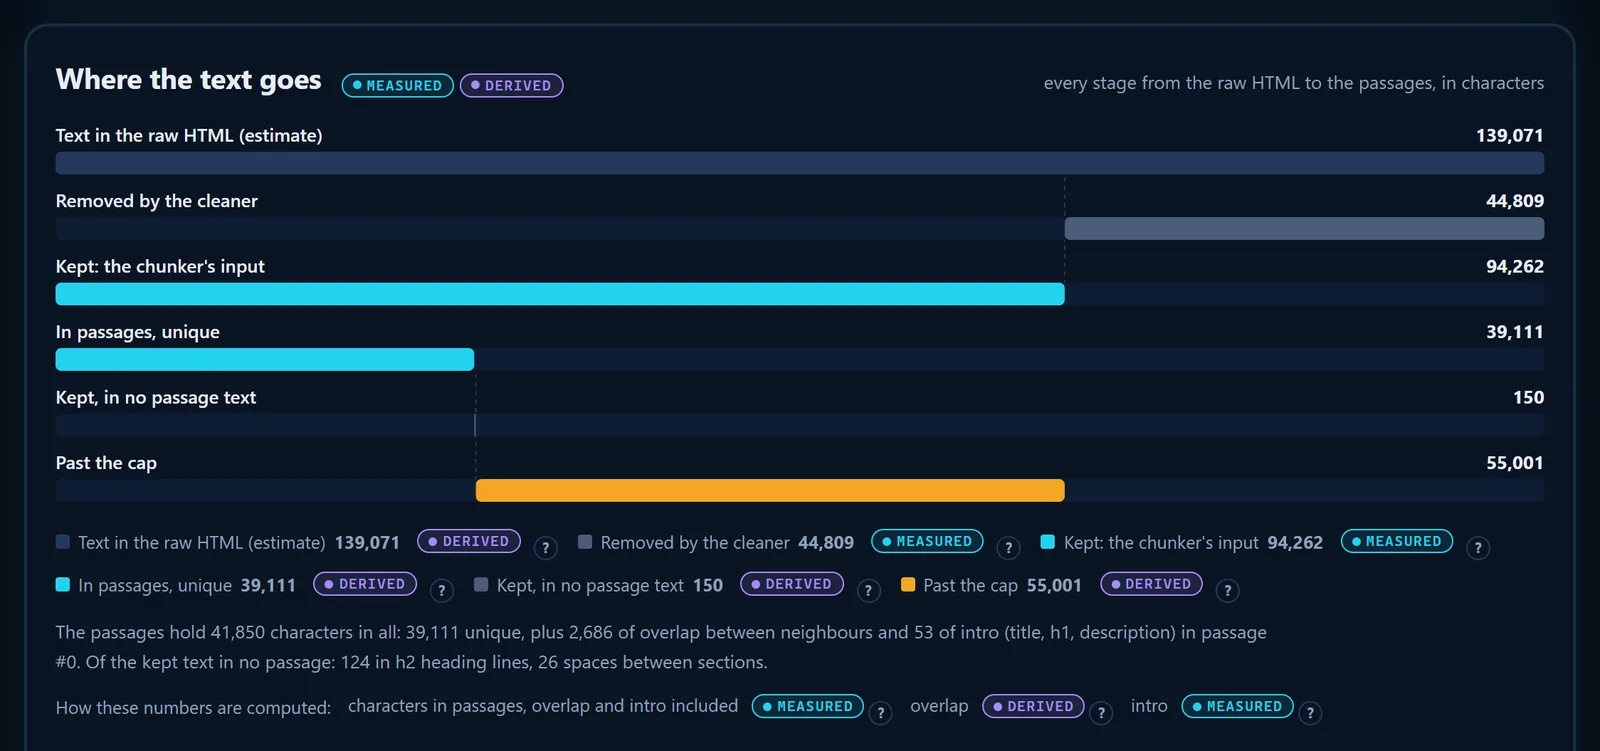
- Lo que quitó el limpiador: scripts, estilos, navegación.
- Texto único que llegó a un pasaje.
- Fuera del límite: conservado, pero sin pasaje.
- El total de los pasajes dividido en único, solape e introducción.
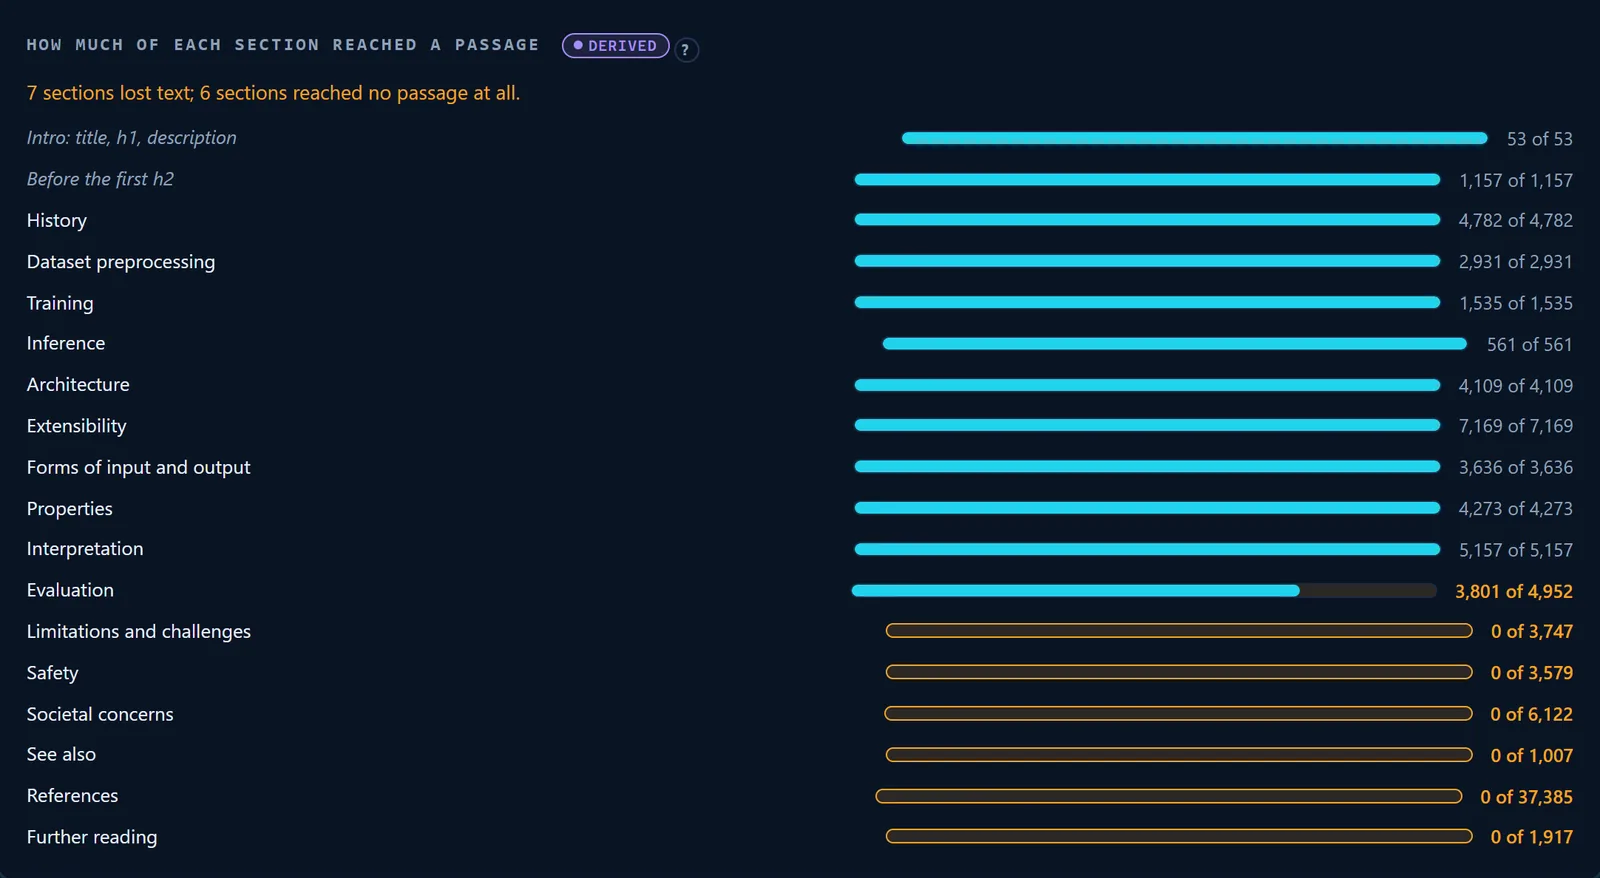
- Secciones que perdieron texto y secciones que no llegaron a ninguno.
- Una sección que el límite cortó por la mitad.
- Secciones fuera del límite: 0 caracteres guardados.
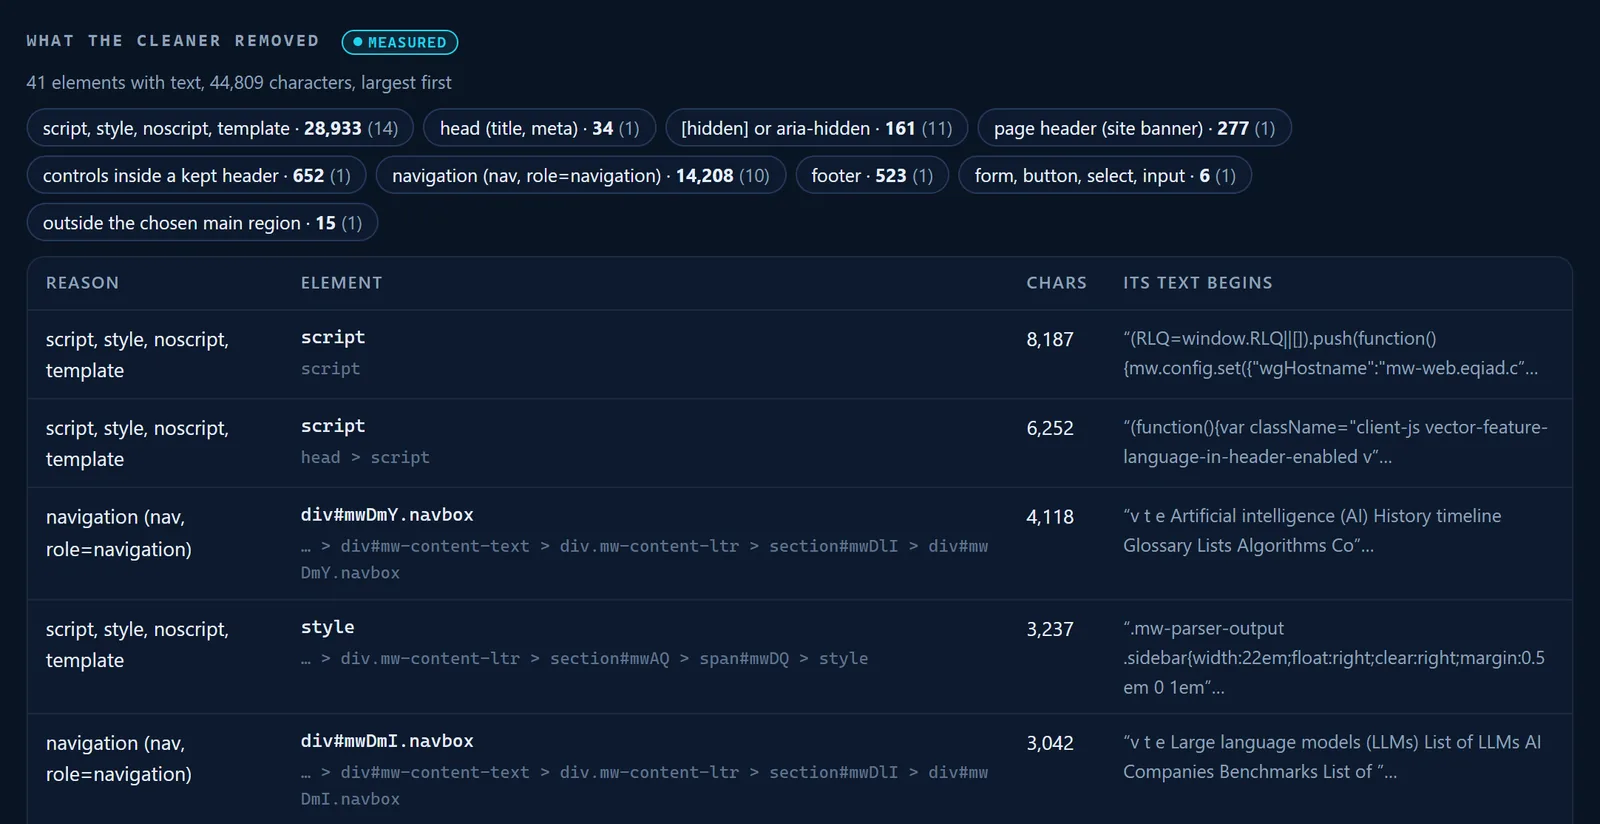
- Caracteres quitados por motivo.
- El elemento y su ruta CSS.
- Sus caracteres y cómo empieza su texto.
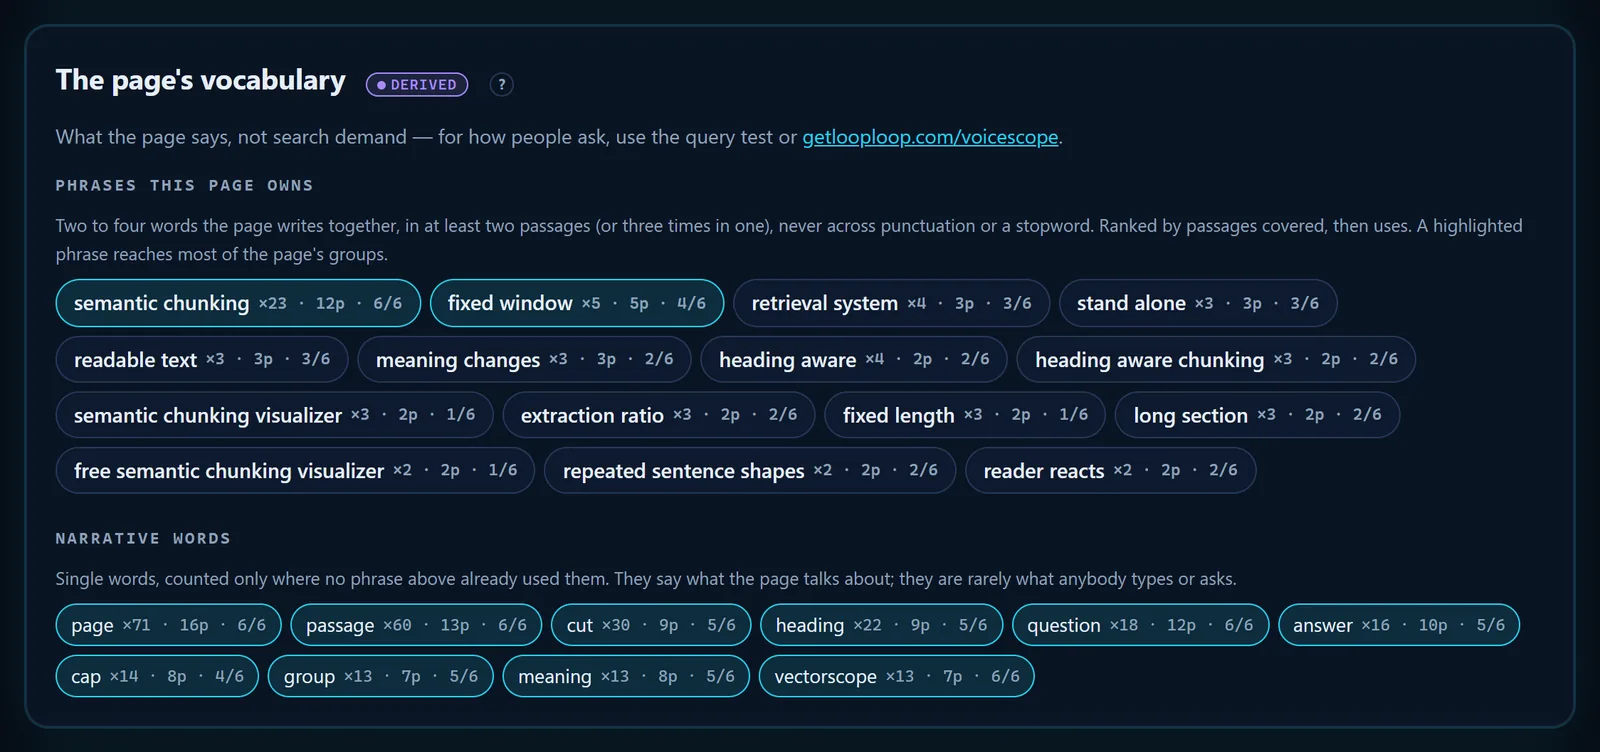
- Derivado: contado por una regla fija, no juzgado.
- Lo que dice la página, no demanda de búsqueda.
- Una frase propia: usos, pasajes, grupos alcanzados.
- Palabras del relato: sueltas, que ninguna frase usó ya.
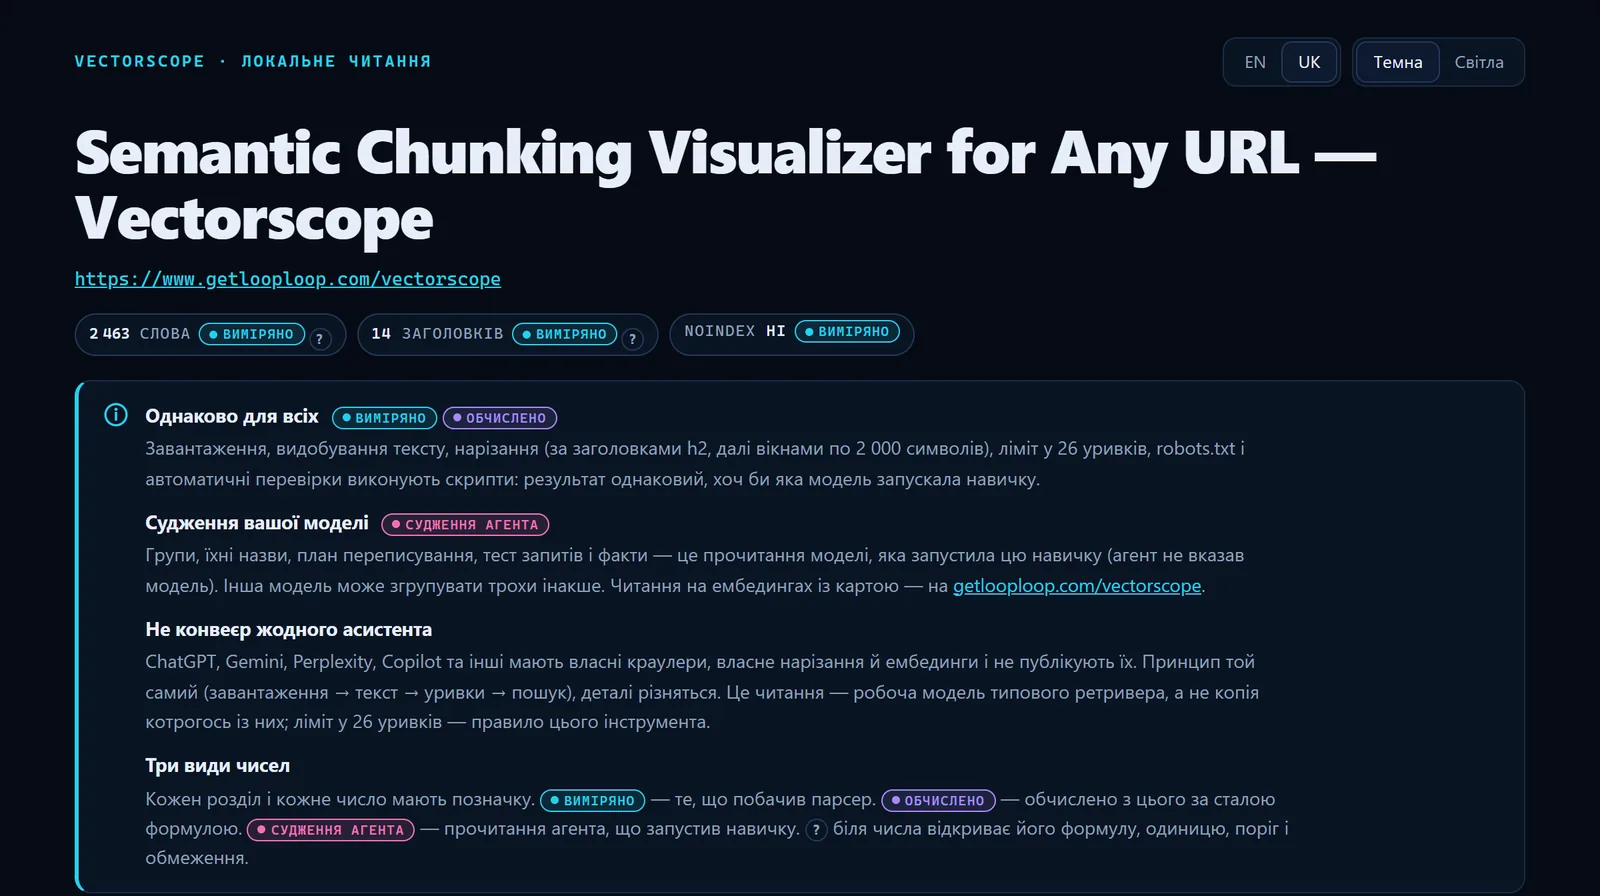
- El selector de idioma de la interfaz.
- Las etiquetas y explicaciones, en ucraniano.
- El título de la propia página no se traduce.
04 Las comprobaciones automáticas y por qué importa cada una
Tras la lectura, la skill de Claude Code para búsqueda con IA ejecuta sus comprobaciones sin ningún criterio de por medio: cada hallazgo tiene un código, una gravedad, los pasajes en que se basa y la evidencia, y cada umbral es una constante con nombre en el código de la skill. El informe las ordena por gravedad, y el acceso de los rastreadores va primero, porque un rastreador bloqueado vuelve irrelevante todo lo demás.
-
Rastreadores que responden a la gente, bloqueados en robots.txt
ai_search_blockedLa skill lee /robots.txt en el origen de la página y lo interpreta como describe la RFC 9309 para doce rastreadores. Si un rastreador de búsqueda o de visitas pedidas por un usuario —OAI-SearchBot, ChatGPT-User, Claude-SearchBot, Claude-User, PerplexityBot, Perplexity-User, Googlebot o Bingbot— tiene el paso prohibido, el informe lo dice antes que nada; el propio consejo de Google para sus funciones de IA empieza por no bloquear al rastreador [5]. robots.txt es una petición que se pide respetar a los rastreadores, no un control de acceso [13], y cada operador documenta sus propios agentes [9] [10] [11]; los accesos en nombre de un usuario son otro caso, porque OpenAI indica que las reglas de robots.txt pueden no aplicarse a ChatGPT-User y Perplexity, que Perplexity-User en general las ignora. Un robots.txt que responde 5xx o no responde se marca como
robots_unreachable. -
Solo bloqueados los rastreadores de entrenamiento
ai_training_blockedBloquear GPTBot, ClaudeBot, Google-Extended o CCBot suele ser deliberado y no impide que un asistente cite la página hoy, así que es un hallazgo de gravedad baja. Google indica que Google-Extended no afecta a la inclusión en su Búsqueda [4], y robots.txt controla el rastreo, no si una página aparece en los resultados [3]; el CCBot de Common Crawl lee primero robots.txt [12].
-
La página pide no ser indexada
noindexUn meta robots noindex significa que los índices de búsqueda de los que responden los asistentes descartarán la página. Las funciones de IA de Google solo muestran páginas indexadas y aptas para fragmento [1].
-
Texto que solo existe después de JavaScript
js_dependentCon
--renderse marca una página en la que JavaScript añade un 50% de palabras o más (y al menos 150). Cuando Vercel midió su red en diciembre de 2024, los grandes rastreadores de IA descargaban archivos JavaScript sin ejecutarlos [8], así que leen la cifra menor. -
Texto fuera del límite de 26 pasajes
cap_overflowLas 26 casillas están llenas y sobra texto. Lo que viene después del pasaje 26 este flujo nunca lo guarda, así que ninguna pregunta puede recuperarlo. El límite es nuestro, no de ningún asistente.
-
Respuestas de FAQ que perdieron su pregunta
lost_faq_questionsTres o más frases empiezan por «Sí.» o «No.» y la página tiene menos signos de interrogación que la mitad de ellas: las preguntas estaban en botones o acordeones que no sobrevivieron a la extracción, y cada respuesta perdió su dirección. Google retiró los resultados enriquecidos de FAQ en mayo de 2026 [6], así que el marcado nunca fue lo importante: lo es el texto.
-
Un encabezado con más del 30% del texto
dominant_headingEl fragmentador solo corta en h2, así que una sección tan grande se corta solo por longitud; sus subtítulos son h3 o texto con estilo, y ninguno de los dos provoca un corte.
-
Pasajes que empiezan a mitad de frase
mid_sentence_startUn pasaje que empieza en minúscula o con un signo de puntuación lo cortó la ventana de 2000 caracteres. Empieza sin su sujeto: el fallo descrito en la sección sobre pasajes que se entienden solos [18].
-
Navegación dentro del contenido
nav_in_contentCuatro o más líneas seguidas de una o dos palabras dentro del texto principal: menús, listas de etiquetas o tablas de rótulos se convirtieron en texto de pasajes y gastaron pasajes. Google pide que el contenido importante esté disponible como texto [1]; el adorno que se lee como texto se gasta como contenido.
-
Secciones demasiado finas
thin_sectionUn encabezado con menos de 150 caracteres debajo es demasiado corto para responder algo por sí solo.
-
Avances recortados
truncated_teaserLas líneas que terminan en «…» o «...» (salvo muestras de código) le dan a un recuperador media afirmación; tres o más suben la gravedad a media.
-
La misma afirmación en todas las secciones
repeated_claimLa misma frase de cuatro palabras —con gramática, no código— en al menos la mitad de los grupos. La repetición gasta pasajes en lo que ya se dijo.
Después, el marcado: un canonical ausente, relativo, duplicado o que apunta a otra URL; JSON-LD que no se puede analizar o que falta; y una meta description ausente, de menos de 70 o de más de 160 caracteres, porque el fragmentador pone la descripción en el pasaje #0.
Primero robots.txt: qué rastreadores de IA pueden leer la página
La tabla es el veredicto de robots.txt de una ejecución real de la skill sobre la propia página del Vectorscope web: doce rastreadores, cada uno con la regla que decidió. En esta página todos están permitidos.
| Rastreador | Empresa | Para qué sirve | Esta página | Regla decisiva |
|---|---|---|---|---|
OAI-SearchBot | OpenAI | respuestas de búsqueda | permitido | Allow: /vectorscope |
ChatGPT-User | OpenAI | una visita pedida por un usuario la empresa indica que robots.txt puede no aplicársele | permitido | Allow: /vectorscope |
GPTBot | OpenAI | datos de entrenamiento | permitido | Allow: /vectorscope |
Claude-SearchBot | Anthropic | respuestas de búsqueda | permitido | Allow: /vectorscope |
Claude-User | Anthropic | una visita pedida por un usuario | permitido | Allow: /vectorscope |
ClaudeBot | Anthropic | datos de entrenamiento | permitido | Allow: /vectorscope |
PerplexityBot | Perplexity | respuestas de búsqueda | permitido | Allow: /vectorscope |
Perplexity-User | Perplexity | una visita pedida por un usuario la empresa indica que robots.txt puede no aplicársele | permitido | Allow: /vectorscope |
Google-Extended | entrenamiento y fundamentación de Gemini | permitido | Allow: /vectorscope | |
Googlebot | índice de búsqueda del que responden los asistentes | permitido | Allow: /vectorscope | |
Bingbot | Microsoft | índice de búsqueda del que responden los asistentes | permitido | Allow: /vectorscope |
CCBot | Common Crawl | corpus web abierto | permitido | Allow: /vectorscope |
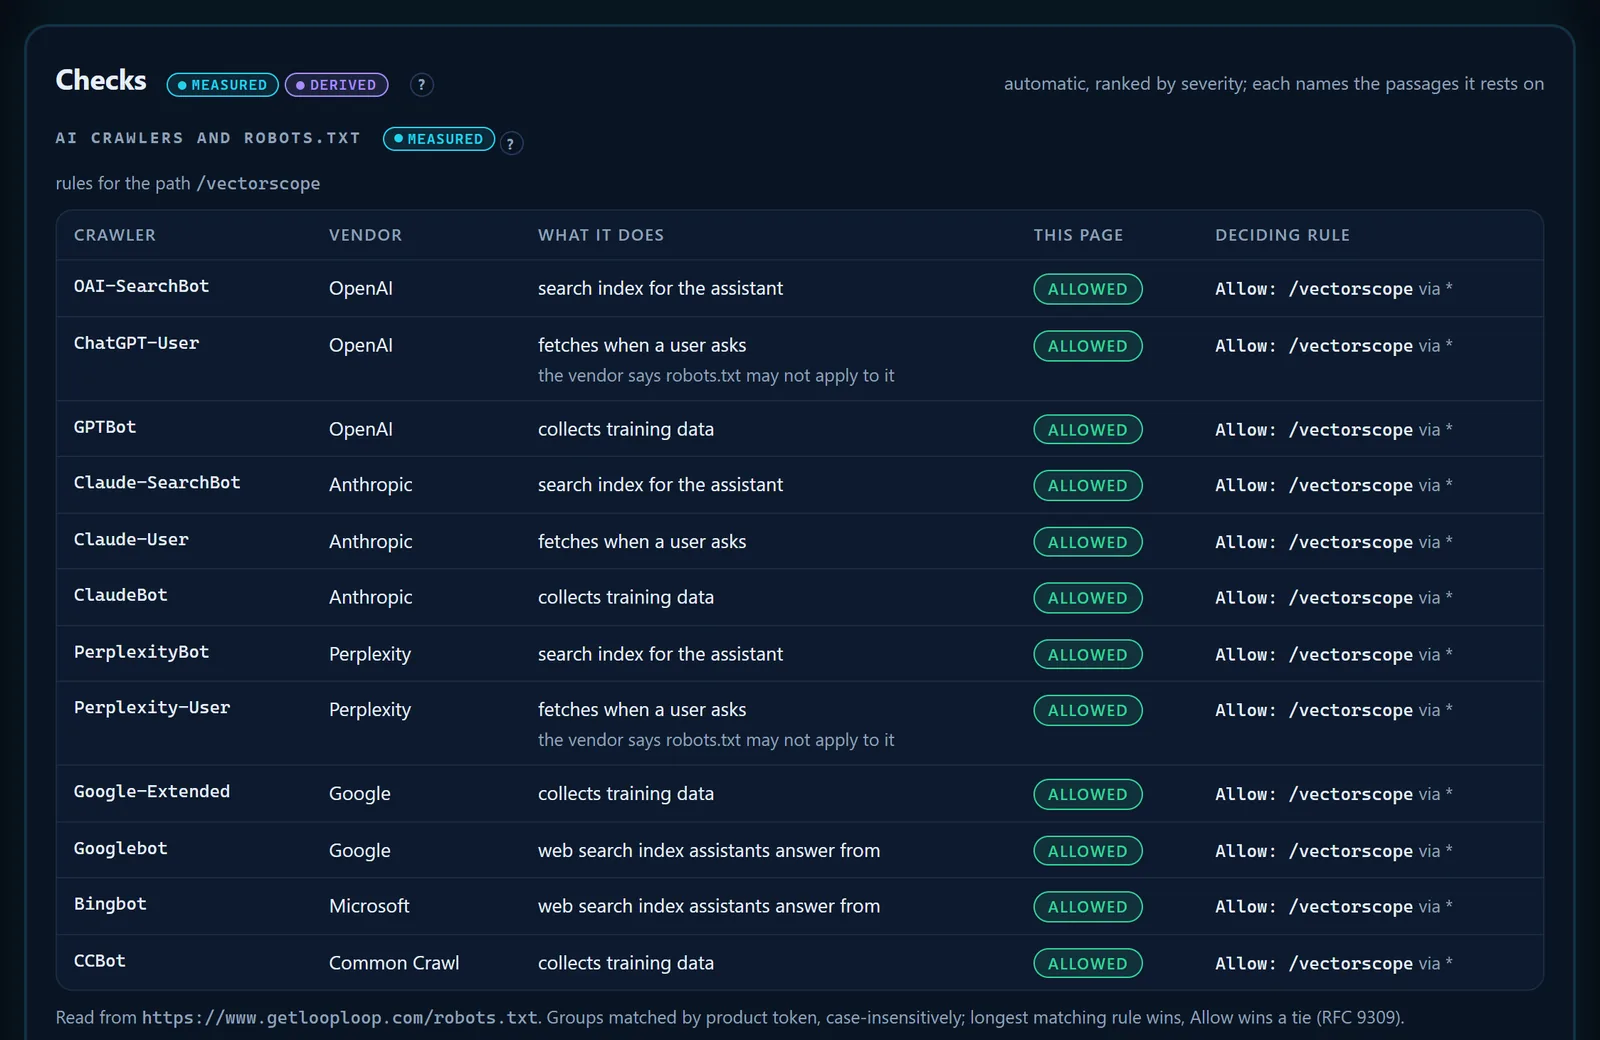
- Los rastreadores de visitas pedidas por un usuario llevan la advertencia de la propia empresa sobre robots.txt.
- El veredicto para la ruta de esta página.
- La regla que decidió y el grupo del que salió.
- De dónde se leyó el archivo y con qué reglas se interpretó (RFC 9309).
05 De la lectura a la reescritura: prueba con preguntas, plan, comparación, antes y después
La lectura dice qué falla; el resto de la skill de Claude Code para búsqueda con IA ayuda a arreglarlo y muestra si el arreglo funcionó. La prueba con preguntas y el plan son criterio del agente, y el script comprueba ambos: una cita tiene que copiarse literalmente del pasaje que cita o la ejecución se rechaza indicando el elemento.
Una prueba con preguntas
El agente escribe de 5 a 10 consultas típicas —las tuyas si las das y, si no, las preguntas que una persona escribiría a un asistente, incluida al menos una que la página probablemente no responde—. Para cada una indica el único pasaje que debería devolver un recuperador, un veredicto (completa, parcial o sin respuesta), si las palabras se entienden citadas solas y las palabras exactas que responden.
Un plan de reescritura
Arreglos por orden de prioridad, cada uno ligado a un código de comprobación y a los pasajes en que se basa, con reescrituras «antes → después» de los pasajes más débiles. El orden sigue lo que más cambia la recuperación: rastreadores bloqueados y noindex, después texto fuera del límite, después pasajes que perdieron su pregunta o su tema, después secciones finas o fragmentadas y, por último, el marcado. Una reescritura no puede añadir afirmaciones que la página no hace.
Modo comparación
Lee de 2 a 5 páginas en una ejecución. El agente escribe primero un diccionario de temas común, para que los grupos coincidan entre páginas; el informe muestra una tabla de temas × páginas, huecos de temas (temas que las demás cubren y una no), huecos de datos (datos que solo da una página) y quién gana cada consulta. La skill compara las páginas que indicas y tiene la instrucción de no ofrecer por su cuenta una comparación con la página de una empresa concreta.
Antes y después
Guarda la lectura anterior. Cuando la página cambie, vuelve a leerla y pasa --baseline old-reading.json al informe, con --baseline-groups si guardaste la agrupación anterior: muestra qué pasajes no cambiaron, cambiaron, se añadieron o desaparecieron, el estado del límite antes y ahora, y de qué grupos anteriores salen los nuevos. Tras un cambio real, IndexNow puede avisar a los buscadores participantes de que la URL cambió [15].
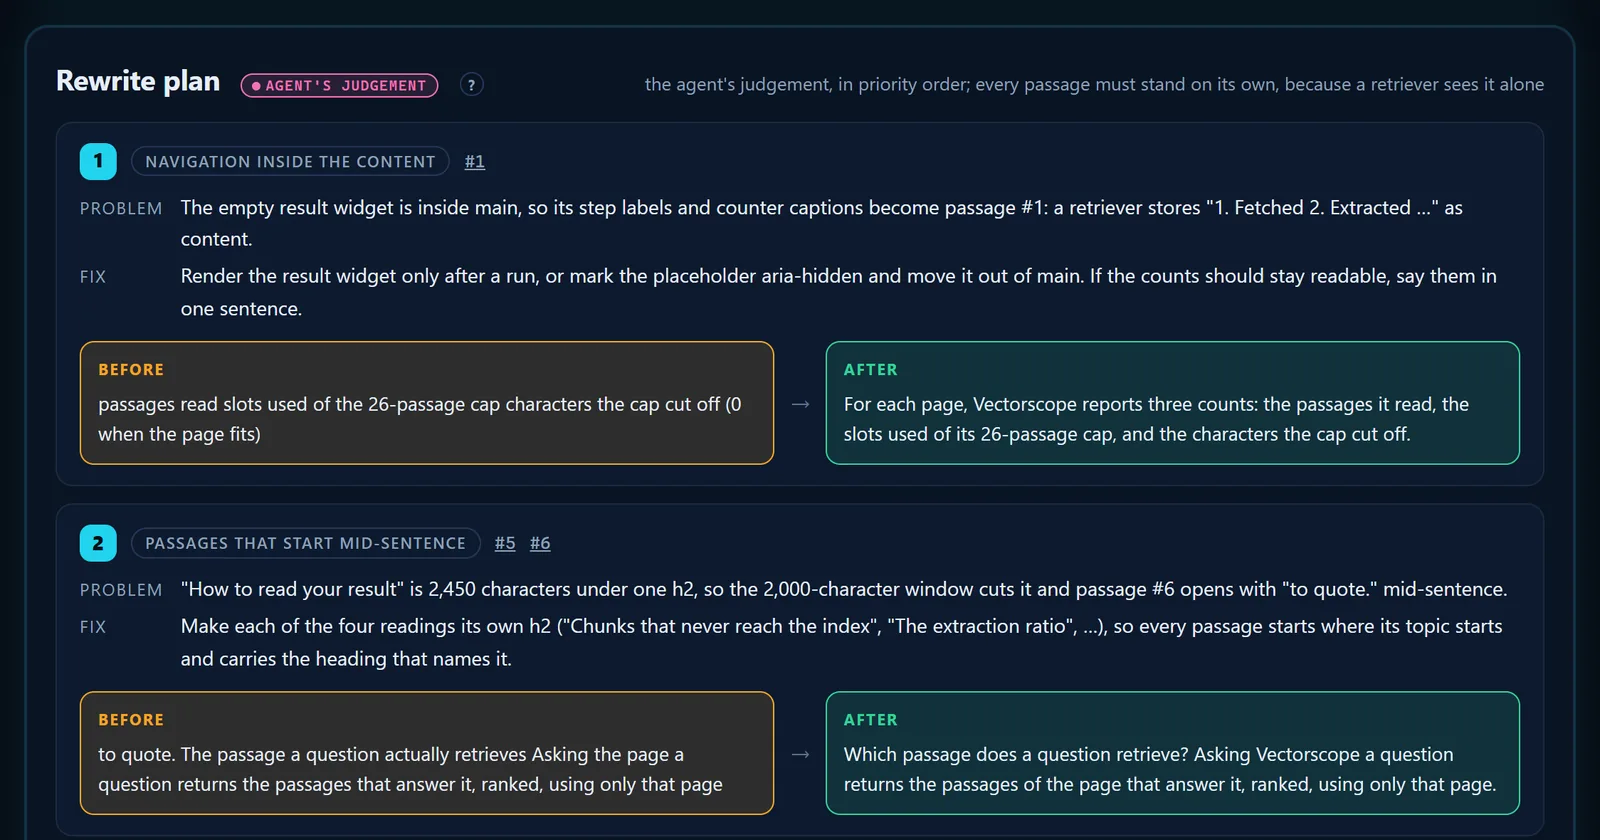
- Marcado como criterio del agente.
- La comprobación a la que responde y sus pasajes.
- Antes: el texto del pasaje, copiado literalmente.
- Después: la reescritura, que nombra su tema para entenderse sola.
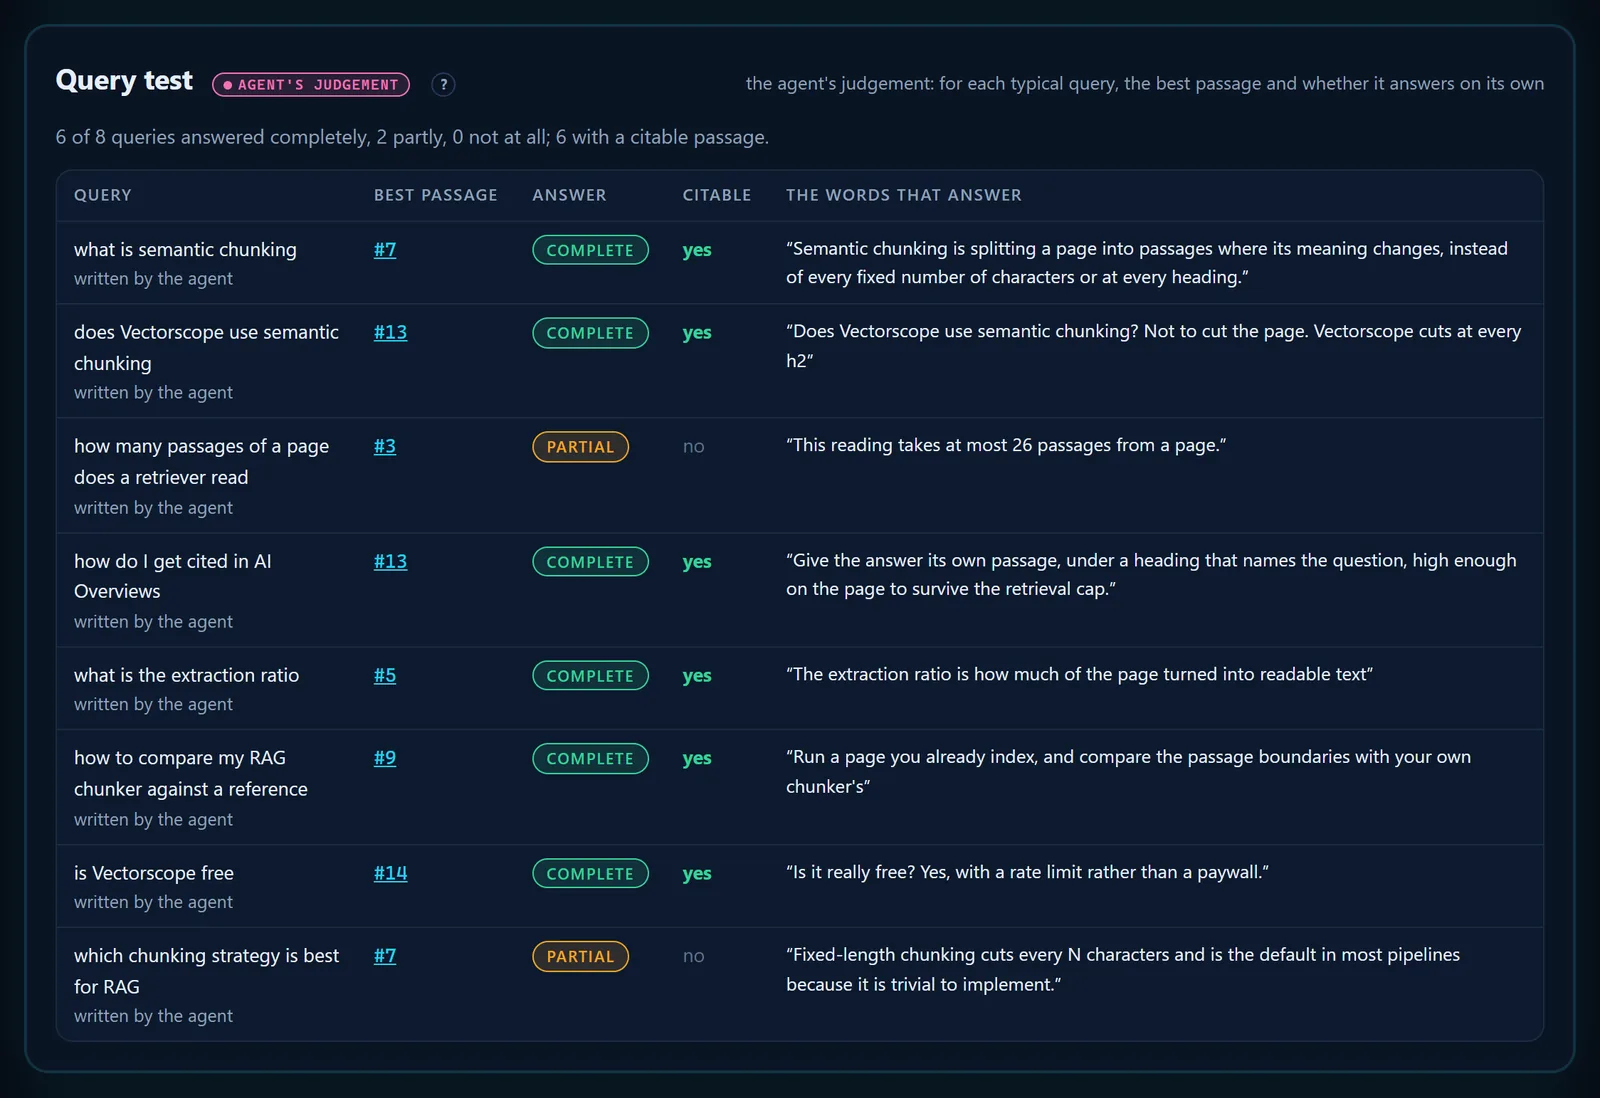
- Marcado como criterio del agente.
- El resumen: respondidas por completo, en parte, sin respuesta y citables.
- El veredicto: completa, parcial o sin respuesta.
- Las palabras exactas que responden, comprobadas contra el pasaje.
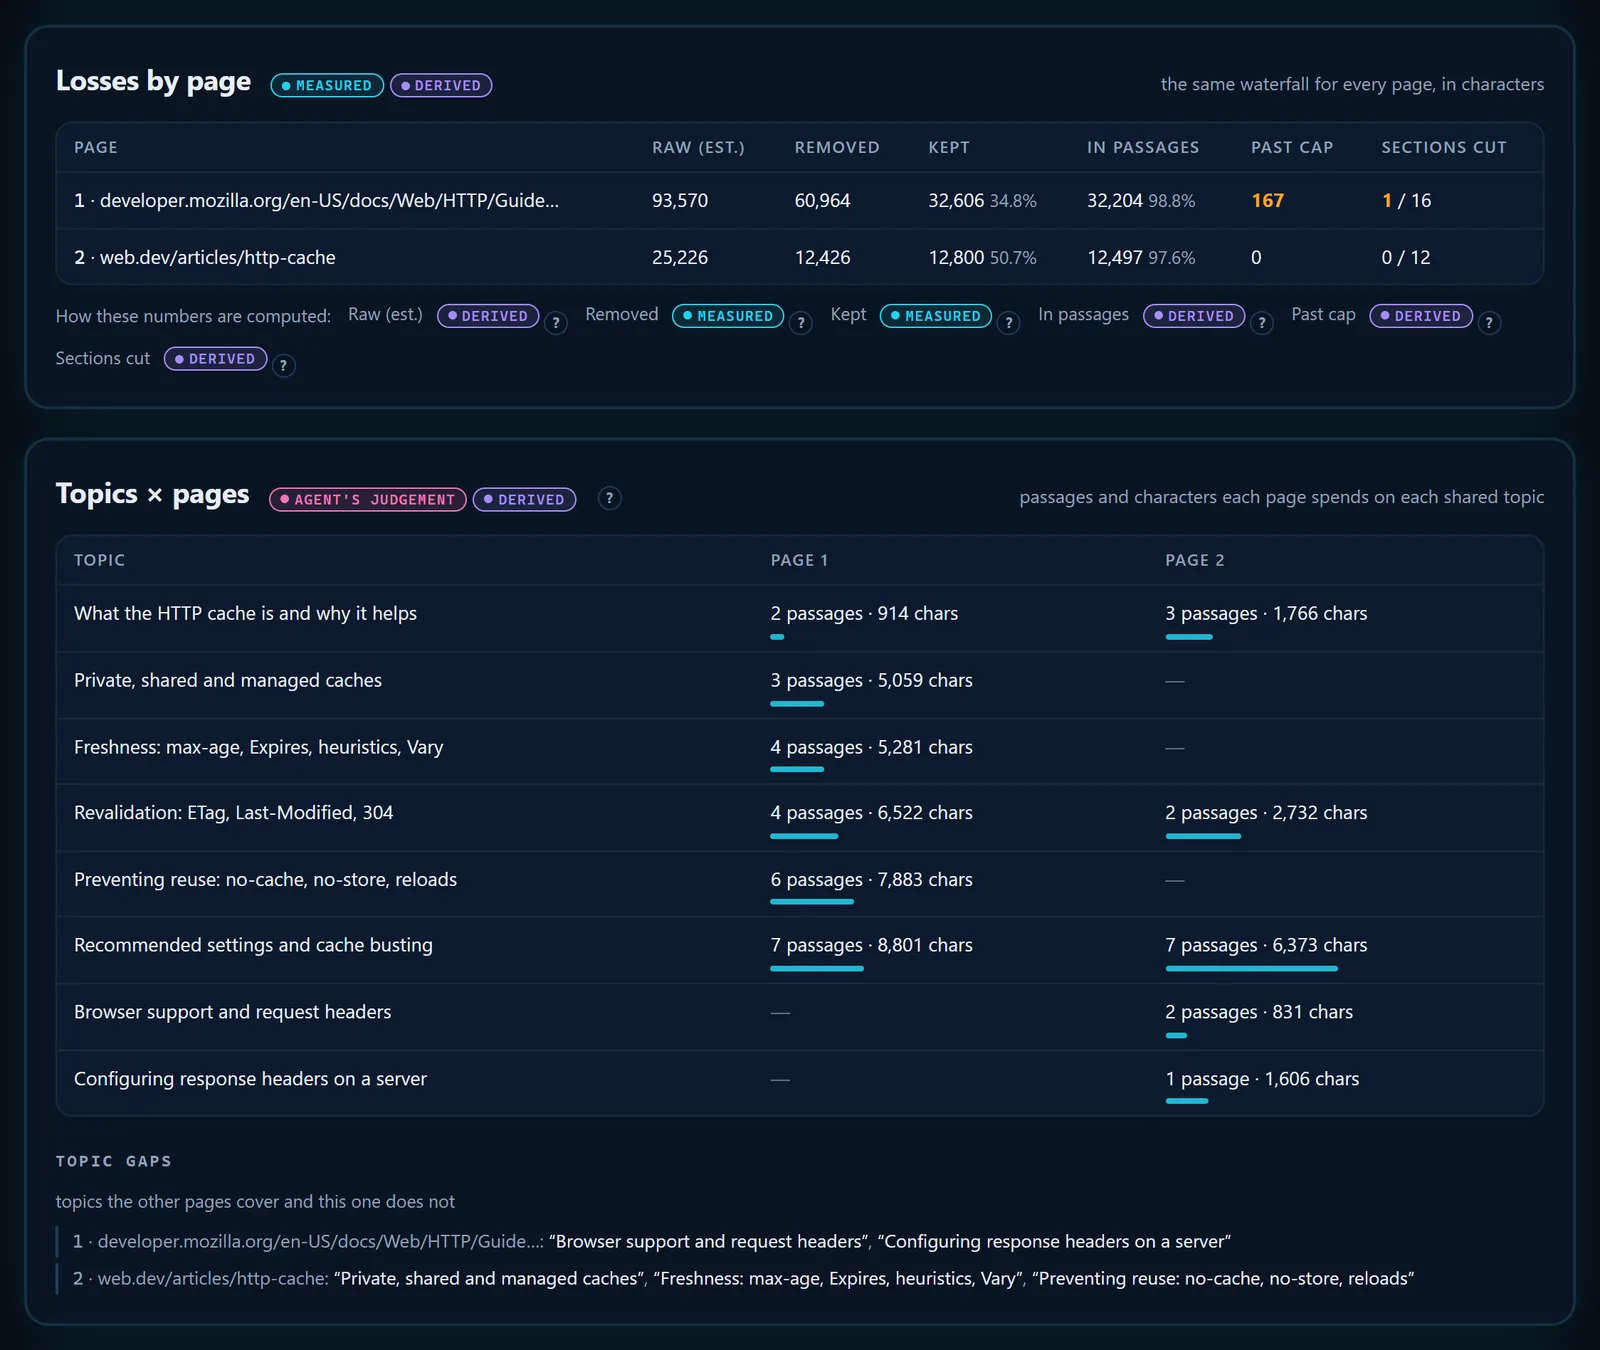
- Así era en la 2.102: MDN perdía 167 caracteres fuera del límite. La 2.103 corrigió el corte que lo causaba (un h3 que repetía un h2 partía una sección) y ahora la página cabe.
- Pasajes y caracteres que cada página dedica a un tema.
- Un tema que una página cubre y la otra no.
- Los huecos de temas, página por página.
06 Dos páginas reales, leídas por la skill
Esta skill de Claude Code para búsqueda con IA trae dos ejecuciones como ejemplo. El artículo de Wikipedia sobre modelos de lenguaje grandes llena las 26 casillas y deja 55 001 caracteres fuera del límite, contados desde el texto único de sus pasajes; la 2.101 restaba también los solapes y daba 52 973. La página de Vectorscope necesita 17 pasajes y no pierde nada. Cada cifra de abajo sale del JSON de esas dos ejecuciones con la skill 2.102; no hay nada estimado.
- pasaje
- casilla libre
Veintiséis casillas, una por pasaje guardado, en orden de lectura; un hueco marca un cambio de grupo y una casilla con solo contorno es una que la página no necesitó. Las celdas cuentan pasajes, no caracteres: los caracteres están en el último gráfico.
Las secciones largas se cortan en ventanas que se detienen cerca de los 2000 caracteres; las barras cortas son finales de sección y las primeras líneas de la página.
- en pasajes
- fuera del límite
El texto de los pasajes se cuenta una vez, sin los solapes de 200 caracteres ni la introducción, así que las dos barras suman el texto conservado de la página, menos las líneas de encabezado que no están en ningún pasaje.
Fuente: las ejecuciones de ejemplo de la skill examples/wikipedia-llm.json y examples/getlooploop-vectorscope.json, skill 2.102, generadas el 16 de octubre de 2026.
Las cifras en una tabla
| Página | Palabras | Pasajes | Caracteres guardados, con solapes | De ellos, únicos | Caracteres fuera del límite |
|---|---|---|---|---|---|
| Wikipedia — Large language model | 13.718 | 26 / 26 | 41.850 | 39.111 | 55.001 |
| getlooploop.com/vectorscope | 2463 | 17 / 26 | 14.211 | 13.547 | 0 |
07 Funciona con tu agente: Claude Code, claude.ai, Codex, opencode, Hermes
Esta skill de Claude Code para búsqueda con IA es una sola carpeta —un SKILL.md y scripts de Node— y cada agente ejecuta desde ella los mismos comandos, así que lee el modelo del propio agente. Claude Code es el agente en el que se creó y el que da nombre a esta página, pero los scripts no dependen de él. Esta página describe la versión 2.103 (sus capturas son de la 2.102); las versiones cuentan en milésimas (2.101, 2.102, 2.103 …), así que el primer número solo cambia con un cambio incompatible. Cada agente encuentra las skills en su propio sitio:
| Agente | Dónde busca las skills |
|---|---|
| claude.ai, Claude desktop | vectorscope.zip, subido en Customize > Skills [26] |
| Claude Code | ~/.claude/skills/ (personal) · .claude/skills/ (proyecto) [21] |
| OpenAI Codex | ~/.agents/skills/ (usuario) · .agents/skills/ (repositorio) [22] |
| opencode | ~/.config/opencode/skills/ · .opencode/skills/, y también las carpetas de Claude Code y Codex [23] |
| Hermes Agent | ~/.hermes/skills/ y las carpetas del proyecto cuando confías en el repositorio [24] |
| Cualquier otro agente | apunta su archivo de instrucciones, como AGENTS.md, a skills/vectorscope/SKILL.md |
GLM es una familia de modelos, no un agente: el GLM Coding Plan de Z.ai funciona dentro de agentes de programación, y su documentación nombra entre ellos Claude Code, Codex y OpenCode [25]. Instala la skill para el agente en el que usas GLM, y la lectura la hará GLM.
Los comandos completos de instalación para cada agente están en el README de la skill
08 Cómo instalarla: claude.ai, la app de escritorio, Claude Code
Esta skill de Claude Code para búsqueda con IA necesita Node 20.18 o posterior y ningún npm install: sus scripts vienen empaquetados en dist/, así que los ejecuta node tal cual, incluso donde se bloquea instalar paquetes.
-
claude.ai o la app de escritorio de Claude: sube el zip
Descarga
vectorscope.zipde la versión y no lo descomprimas. Activa la ejecución de código, que las skills necesitan [26], y luego Customize > Skills > + > Create skill > Upload a skill. -
Deja que el entorno aislado llegue a la página
En Free, Pro y Max activa Allow network egress; en Team y Enterprise un propietario permite gestores de paquetes y dominios concretos, con el dominio del sitio en la lista [27]. Si el ajuste no puede permitirlo, se detiene con
REFUSED unreachable: usa Claude Code. -
Pegar un enlace no es instalarla
Claude no descarga ni ejecuta código de un enlace pegado en el chat, porque el contenido descargado puede traer instrucciones que nadie revisó [28]; como mucho imita los pasos, y esas cifras no son las de la herramienta.
-
Claude Code y otros agentes: clona
En cualquier lugar de tu equipo.
shellgit clone https://github.com/Olexan-art/getlooploop-skills.git -
Copia la skill en tu carpeta de skills
~/.claude/skills/la hace tuya en todos los proyectos;.claude/skills/dentro de un repositorio, solo de ese proyecto.macOS, Linux, Git Bashmkdir -p ~/.claude/skills && cp -r getlooploop-skills/skills/vectorscope ~/.claude/skills/vectorscope -
La misma copia en PowerShell
En Windows sin Git Bash.
PowerShellNew-Item -ItemType Directory -Force "$HOME\.claude\skills" | Out-Null Copy-Item -Recurse getlooploop-skills\skills\vectorscope "$HOME\.claude\skills\vectorscope" -
Pídeselo a tu agente
Escribe
/vectorscope https://example.com/pageen Claude Code, o pídelo con tus palabras en cualquier agente. Termina con el informe HTML a la vista: un archivo para descargar en claude.ai, abierto o publicado en Claude Code.
09 Lo que la skill no hace
Una skill de Claude Code para búsqueda con IA solo puede mostrar lo que recibe un recuperador. Todo lo que vaya más allá sería una afirmación que no puede comprobar, así que no la hace.
- Sin puntuación. La página no recibe nota, puesto ni porcentaje de «preparación para la IA».
- Sin detección de IA. No dice si la página la escribió una persona o un modelo.
- Sin predicción de respuestas. No puede decir qué dirá de ti un asistente ni si alguno tiene hoy la página en su índice.
- No sustituye el flujo propio de un asistente. Los grupos, los veredictos y el plan son la lectura del agente, no una agrupación por embeddings, y el panel informativo del informe nombra el modelo que los juzgó; dos modelos pueden valorar una página de forma algo distinta. La descarga, el corte, el límite y las comprobaciones son reglas fijas y no varían.
- Sin cifras hechas a mano. Donde los scripts no pueden ejecutarse —sin Node, sin ejecución de código, sin red—, el agente lo dice y se detiene en vez de contar la página por su cuenta.
- Una URL pública por lectura, hasta cinco en modo comparación, leída como un visitante anónimo: sin inicio de sesión, sin cookies, sin Accept-Language. JavaScript solo se ejecuta con
--render, y la lectura en sí sigue siendo la descarga simple.

- Los scripts descargaron la página y su robots.txt, no enviaron nada y no llamaron a ningún modelo.
- Enlaces a GetLoopLoop y a su autor.
10 Cómo se relaciona con el Vectorscope web gratuito
El Vectorscope web y la skill de Claude Code para búsqueda con IA comparten la descarga, la extracción, el corte y el límite. Se diferencian en quién lee los pasajes: la herramienta web genera el embedding de cada pasaje, los agrupa por similitud medida y dibuja el mapa; la skill entrega los pasajes a tu agente y no hace ninguna llamada a embeddings, y eso es también lo que le permite valorar consultas y escribir un plan.
| La skill, en tu agente | Vectorscope web | |
|---|---|---|
| Descarga, extracción, corte, límite de 26 | Mismas reglas | Mismas reglas |
| Agrupación | El agente lee y agrupa | Embeddings, agrupación por enlace promedio |
| Mapa semántico | No | Sí |
| Tabla de robots.txt para rastreadores de IA y comprobaciones automáticas | Sí | No |
| Prueba con preguntas y plan de reescritura | Sí, del agente | Una pregunta cada vez, por similitud |
| Comparar páginas | De 2 a 5 páginas | Una URL cada vez |
| Dónde se ejecuta | En tu agente: tu equipo o el entorno aislado de claude.ai | En nuestro servidor, en el navegador |
| Límite | Ninguno nuestro | Unas pocas ejecuciones por visitante |
11 Preguntas sobre la skill
¿Esta skill de Claude Code para búsqueda con IA es gratuita?
Sí. La skill es de código abierto con licencia MIT. Sus scripts no llaman a modelos ni a embeddings; la lectura la hace el modelo con el que ya funciona tu agente, dentro de tu propia sesión.
¿Para quién es la skill Vectorscope?
Para quienes escriben páginas y para quienes construyen lo que las lee. Los equipos de contenido y SEO la usan antes de publicar para comprobar que la respuesta que justifica la página llega a un solo pasaje por encima del límite y que los rastreadores de IA pueden descargarla. Quienes construyen RAG la usan para contrastar su fragmentador.
¿La skill envía mi página a algún sitio?
No. Los scripts hacen dos peticiones GET —la página y su robots.txt— y no envían nada a ningún sitio; con --render, además, un navegador local abre la página. El propio informe bloquea cualquier petición de red.
¿26 pasajes es el límite que usan ChatGPT, Claude o Perplexity?
No. Veintiséis es el límite que aplican nuestro Vectorscope y esta skill. Ningún asistente publica un límite de pasajes.
¿Por qué una página que parece larga da solo unos pocos pasajes?
Normalmente porque su texto lo dibuja JavaScript. La lectura simple, como los grandes rastreadores de IA, no ejecuta scripts; ejecútala con --render para medir cuánto de la página existe solo después de JavaScript.
¿Puede decirme si mi página aparece en las respuestas de IA?
No. Muestra lo que un recuperador recibiría de una página. Que un asistente te cite es una medición en el tiempo sobre preguntas que tú eliges, y eso no lo responde la lectura de una página.
¿Funciona fuera de Claude Code?
Sí. claude.ai y la app de escritorio de Claude la aceptan como zip subido y la ejecutan en el entorno aislado de ejecución de código; Codex, opencode y Hermes Agent la cargan desde sus carpetas de skills; GLM la ejecuta a través de esos agentes. Los scripts son Node sin nada que instalar; el criterio es del modelo del agente.
12 Fuentes
Cómo comprobamos estas fuentes
Esta página explica una skill de Claude Code para búsqueda con IA, y cada una de sus afirmaciones sobre cómo se comporta un buscador, un rastreador o un recuperador está ligada a una fuente, y cada fuente se abrió y se leyó el 16 de octubre de 2026. Primero, la documentación primaria —los buscadores y los operadores de rastreadores describiendo sus propios sistemas—; después, el estándar; luego, la investigación revisada por pares, y por último, textos de proveedores sobre fragmentación cuando enuncian una regla práctica.
De cada una guardamos la frase exacta en la que se apoya la afirmación, con las palabras de la propia fuente, y va impresa bajo el enlace. Donde una fuente decía menos que un borrador de esta página, la frase de la página se recortó a lo que dice la fuente. La documentación de los rastreadores cambia; si una cita ya no coincide con su página, esa página ha cambiado y esta se actualizará.
Descargadas y citadas el 16 de octubre de 2026.
- [1] AI features and your website Google Search Central · 2025-12-10 · Buscador
To be eligible to be shown as a supporting link in AI Overviews or AI Mode, a page must be indexed and eligible to be shown in Google Search with a snippet, fulfilling the Search technical requirements. There are no additional technical requirements. … Making sure that important content is available in textual form
- [2] Optimizing your website for generative AI features on Google Search Google Search Central · 2026-07-10 · Buscador
“Chunking” content: There's no requirement to break your content into tiny pieces for AI to better understand it. Google systems are able to understand the nuance of multiple topics on a page and show the relevant piece to users.
- [3] Introduction to robots.txt Google Search Central · 2025-12-10 · Buscador
A robots.txt file tells search engine crawlers which URLs the crawler can access on your site. This is used mainly to avoid overloading your site with requests; it is not a mechanism for keeping a web page out of Google.
- [4] Google's common crawlers Google Crawling Infrastructure · 2026-10-15 · Operador de rastreador
Google-Extended does not impact a site's inclusion in Google Search nor is it used as a ranking signal in Google Search.
- [5] Top ways to ensure your content performs well in Google's AI experiences on Search Google Search Central Blog · 2025-05-21 · Buscador
This includes making sure that Googlebot isn't blocked, the page works (Google receives an HTTP 200 (success) status code), and the page has indexable content.
- [6] Latest Google Search documentation updates — FAQ rich result Google Search Central · 2026-05-08 · Buscador
Deprecating the FAQ rich result feature … This feature will no longer appear in Google Search starting May 7, 2026.
- [7] Understand the JavaScript SEO basics Google Search Central · 2026-03-04 · Buscador
Google processes JavaScript web apps in three main phases: Crawling, Rendering, Indexing
- [8] The rise of the AI crawler Vercel, with MERJ · 2024-12-17 · Sector
The data indicates that while ChatGPT and Claude crawlers do fetch JavaScript files (ChatGPT: 11.50%, Claude: 23.84% of requests), they don't execute them.
- [9] Overview of OpenAI Crawlers OpenAI · Operador de rastreador
Sites that are opted out of OAI-SearchBot will not be shown in ChatGPT search answers, though can still appear as navigational links. … Because these actions are initiated by a user, robots.txt rules may not apply.
- [10] Does Anthropic crawl data from the web, and how can site owners block the crawler? Anthropic · 2026-04-07 · Operador de rastreador
Claude-SearchBot navigates the web to improve search result quality for users. … Anthropic’s Bots respect “do not crawl” signals by honoring industry standard directives in robots.txt.
- [11] Perplexity Crawlers Perplexity · Operador de rastreador
PerplexityBot is designed to surface and link websites in search results on Perplexity. … Since a user requested the fetch, this fetcher generally ignores robots.txt rules.
- [12] Common Crawl FAQ — CCBot Common Crawl · Operador de rastreador
CCBot is an automated crawler, checking first the robots.txt … Currently, JavaScript is not executed and Cookies are not used.
- [13] RFC 9309: Robots Exclusion Protocol IETF · 2022-09 · Estándar
This document specifies the rules originally defined by the "Robots Exclusion Protocol" [ROBOTSTXT] that crawlers are requested to honor when accessing URIs. These rules are not a form of access authorization.
- [14] Bing Webmaster Guidelines Microsoft Bing · Buscador
Bing and Copilot search experiences rely on the same core crawling, indexing, and ranking foundation as traditional search. … URLs are more likely to be selected for grounding queries and citations when content stands on its own.
- [15] IndexNow IndexNow (Microsoft Bing, Naver, Seznam.cz, Yandex, Yep) · Estándar
In its simplest form, IndexNow is a simple ping so that search engines know that a URL and its content has been added, updated, or deleted, allowing search engines to quickly reflect this change in their search results.
- [16] Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks Lewis et al., NeurIPS 2020 (arXiv:2005.11401) · 2020-05-22 · Investigación
the non-parametric memory is a dense vector index of Wikipedia, accessed with a pre-trained neural retriever. … Each Wikipedia article is split into disjoint 100-word chunks, to make a total of 21M documents.
- [17] Lost in the Middle: How Language Models Use Long Contexts Liu et al., TACL 2024 (arXiv:2307.03172) · 2023-07-06 · Investigación
performance is often highest when relevant information occurs at the beginning or end of the input context, and significantly degrades when models must access relevant information in the middle of long contexts
- [18] Introducing Contextual Retrieval Anthropic · 2024-09-19 · Sector
In traditional RAG, documents are typically split into smaller chunks for efficient retrieval. While this approach works well for many applications, it can lead to problems when individual chunks lack sufficient context.
- [19] Chunking Strategies for LLM Applications Pinecone · 2025-06-28 · Sector
As a rule of thumb, if the chunk of text makes sense without the surrounding context to a human, it will make sense to the language model as well.
- [20] Splitting recursively — text splitter guide LangChain · Herramientas
It tries to split on them in order until the chunks are small enough. The default list is ["\n\n", "\n", " ", ""]. … chunk_overlap: Target overlap between chunks.
- [21] Extend Claude with skills Claude Code Docs (Anthropic) · Herramientas
Skills extend what Claude can do. Create a SKILL.md file with instructions, and Claude adds it to its toolkit. Claude uses skills when relevant, or you can invoke one directly with /skill-name.
- [22] Build skills OpenAI (ChatGPT Learn — Codex) · Herramientas
Codex reads skills from repository, user, admin, and system locations. … For repositories, Codex scans `.agents/skills` in every directory from your current working directory
- [23] Agent Skills OpenCode · Herramientas
Create one folder per skill name and put a `SKILL.md` inside it. OpenCode searches these locations: … `~/.config/opencode/skills/<name>/SKILL.md` … `.claude/skills/<name>/SKILL.md` … `.agents/skills/<name>/SKILL.md`
- [24] Skills System Nous Research (Hermes Agent) · Herramientas
All skills live in `~/.hermes/skills/` — the primary directory and source of truth.
- [25] GLM Coding Plan — Overview Z.ai · Herramientas
The plan can be applied to agent tools such as ZCode, Claude Code, Codex, OpenCode, AutoClaw, and OpenClaw
- [26] Use skills in Claude Claude Help Center (Anthropic) · 2026-09-22 · Herramientas
Skills require the code execution environment to function. … Upload a ZIP file containing your skill folder.
- [27] Create and edit files with Claude Claude Help Center (Anthropic) · 2026-08-06 · Herramientas
To give Claude access to external data sources, toggle Allow network egress on … Allow network egress to package managers and specific domains: Claude can access package managers plus additional domains you specify.
- [28] Agent Skills Claude Platform Docs (Anthropic) · Herramientas
Depending on user/admin settings, Skills may have full, partial, or no network access. … Skills that fetch data from external URLs pose particular risk, as fetched content may contain malicious instructions.