

AI Search Audit Full: una auditoría SEO que cita sus reglas
Una Agent Skill gratuita y de código abierto que audita una página o hasta 50 para Google, Bing y los asistentes de IA, y respalda cada hallazgo con la regla en que se apoya, citada de su fuente. La pasamos por nuestro propio sitio; esto es lo que encontró y cómo leerlo.
Traducido del original en inglés.
La respuesta corta
- what
- AI Search Audit Full 2.111, una Agent Skill de código abierto: 122 códigos de problema revisados contra 83 citas literales de reglas y 39 reglas que marca como propias, un mapa de respuestas, un mapa de calor, un informe de sitio de hasta 50 páginas, comparaciones de antes y después y un historial local.
- why
- Porque un hallazgo de auditoría vale lo que vale el motivo que lo sostiene. Una lista de problemas sin la regla publicada invita a discutir; una lista con la regla citada y enlazada invita a arreglar.
- who
- Especialistas SEO que deben responder «¿quién lo dice?» a cada hallazgo, responsables de contenido cuyas páginas deberían citar los asistentes de IA y desarrolladores que reciben los tickets de arreglo.
- where
- En GitHub con licencia MIT. Funciona en Claude Code, Codex, opencode, Hermes Agent y otros agentes que cargan skills SKILL.md, o como zip en claude.ai y la aplicación de escritorio de Claude.
- when
- Publicada el 18 de octubre de 2026. La auditoría de ejemplo citada aquí leyó en vivo tres páginas de getlooploop.com el 17 de octubre de 2026; las citas de reglas se cotejaron con sus páginas ese mismo día.
- how
- Scripts de Node empaquetados descargan, leen y revisan las páginas sin llamar a ningún modelo ni a ninguna API de embeddings; el agente que ejecuta la skill escribe las partes de juicio, que el informe firma con su modelo. No se envía nada a GetLoopLoop.
Explicación sencilla
Antes de que Google o un asistente de IA muestre tu página tienen que salir bien tres cosas: hay que dejar entrar a su robot, la página tiene que decir con claridad qué es y las palabras tienen que sobrevivir a la lectura del robot. Esta herramienta gratuita revisa las tres en tu propio ordenador y hace una lista de lo que salió mal. De cada problema dice, con palabras sencillas, qué falla; luego copia la frase exacta del reglamento de Google o de otra fuente oficial que explica por qué; y luego da una pista para arreglarlo. Puede revisar una página o cincuenta, y recuerda las revisiones anteriores, así que la próxima vez te dirá qué mejoró.
Casi todas las auditorías terminan en una discusión. La herramienta dice que la página tiene un problema, alguien pregunta quién lo dice y la respuesta es una puntuación o la opinión de un proveedor. AI Search Audit Full está hecha al revés. Cada problema que señala lleva la regla en la que se apoya, citada palabra por palabra de la fuente que la publicó, con el enlace y la fecha en que se comprobó la cita. Donde nadie publica una regla, dice que el umbral es suyo.
Presentamos esta skill junto a Vectorscope y Lite en La IA lee tu página a trozos. Tres skills gratuitas muestran cuáles. Aquí vamos solo con Full, en la versión 2.111: qué revisa, qué encontró en nuestro propio sitio, las cuatro cosas que ganó desde aquel artículo y dónde están sus límites.
Qué revisa
Para que Google, Bing o un asistente de IA puedan mostrar o citar una página, se tienen que cumplir tres condiciones. Hay que dejar entrar al rastreador, en robots.txt y en las etiquetas robots de la propia página. La página tiene que decir qué es: título, descripción, canonical, datos estructurados, versiones de idioma. Y el texto tiene que sobrevivir a la lectura de la máquina: lo que conserva el limpiador, cómo se corta en pasajes y qué queda más allá del punto en que el recuperador deja de leer.
Full revisa las tres contra reglas publicadas y añade tres lecturas que solo puede hacer una IA: las preguntas que la gente haría sobre la página, cómo describe la marca el propio modelo del agente y qué cree sobre las reseñas de la marca. Esas lecturas aparecen marcadas en todas partes como estimación del modelo, con el nombre del modelo.
Su ejemplo en el repositorio es una auditoría de tres páginas de getlooploop.com: la página de Vectorscope en inglés, ucraniano y español, leídas en vivo el 17 de octubre de 2026.
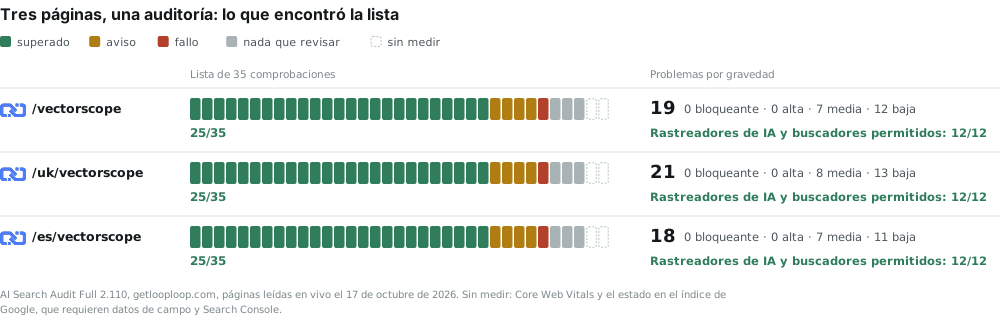
Primero lo importante, porque es la razón para auditar: nada bloquea estas páginas. Los doce rastreadores que revisa la skill, de Googlebot y Bingbot a OAI-SearchBot, Claude-SearchBot y PerplexityBot, tienen acceso. Ningún hallazgo es bloqueante ni alto. En cada página se superan sin reservas 25 de las 35 comprobaciones.
La única que falla es de las útiles. La comprobación de enlaces rotos encontró en el bloque «Seguir leyendo» dos enlaces que llevan a páginas 404: /notes/what-is-semantic-chunking y /notes/optimise-content-for-ai-search, en las tres versiones de idioma. No nos habíamos dado cuenta. Los dos artículos estaban previstos y nunca se escribieron; el 23 de octubre, mientras escribíamos esto, apuntamos el bloque a artículos que existen. Una auditoría que encuentra algo real en las páginas de sus propios autores, y consigue que se arregle el mismo día, está haciendo su trabajo.
Cada problema llega con su regla
Cada hallazgo de un informe de Full se abre en tres capas, escritas para tres lectores.
Qué falla es para un responsable o alguien que empieza: palabras sencillas, sin consejos. Para los enlaces rotos: «Los enlaces de la página llevan a una página de error. Quien los sigue llega a un callejón sin salida, y los buscadores eliminan esas direcciones de su índice».
Qué dice la regla es para quien pregunta «¿quién lo dice?»: una cita breve de la fuente oficial, su enlace y la fecha en que se comprobó. Para este mismo hallazgo cita la página de Google sobre los códigos de estado HTTP:
En el caso de la Búsqueda de Google, Google no indexa las URL que devuelven un código de estado 4xx, y las URL ya indexadas que devuelven un código de estado 4xx se eliminan del índice.
Google Crawling Infrastructure, HTTP status codes; cita de la skill, comprobada el 17 de octubre de 2026 (traducida del inglés)
La dirección del arreglo es para el desarrollador, breve y técnica, plegada dentro de «Detalles para especialistas» para que nunca estorbe en la capa sencilla: «Actualiza o quita los href que devuelven 4xx o 5xx; para los destinos movidos, un 301 a su nueva URL».
El mismo patrón explica hallazgos que ni siquiera son errores. Las páginas llevan marcado FAQPage, y la auditoría lo señala como bajo: el marcado «no hace daño, pero ya no consigue el resultado ampliado para el que se añadió», porque, en las palabras que cita del registro de cambios de la documentación de Google, «el resultado enriquecido de preguntas frecuentes ya no se muestra en los resultados de la Búsqueda de Google». La dirección del arreglo deja la elección clara: para Google no hace falta nada; mantenlo si otro consumidor lo lee, o quítalo para aligerar la página.
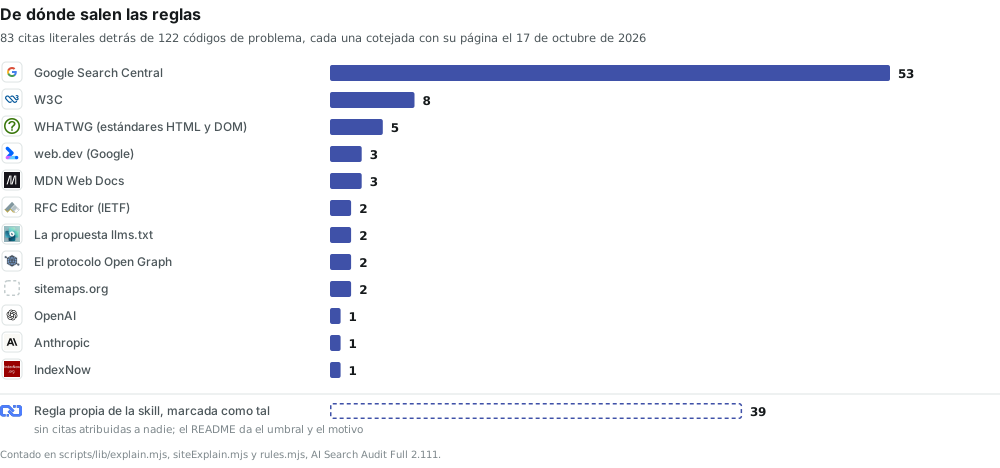
Contado en la propia tabla de reglas de la skill (explain.mjs y rules.mjs), 122 códigos de problema se apoyan en 83 citas y 39 reglas propias. Google Search Central aporta 53 de las citas, lo esperable en una auditoría para la búsqueda. El resto viene de los organismos de estándares (W3C, WHATWG, el RFC 9309 del IETF para robots.txt), de MDN y de las páginas de rastreadores de las propias empresas de IA: la cita de OpenAI es la que decide si un sitio puede aparecer siquiera en las respuestas de búsqueda de ChatGPT.
Las 39 reglas propias importan tanto como las 83 citas. Un pasaje que empieza a mitad de frase, una sección más corta que el umbral de la skill, un llms.txt que enumera un solo idioma en un sitio con tres: nadie publica una regla para esto, así que el informe dice «Regla de esta skill» y el README da el umbral. No se atribuye a Google nada que Google no haya escrito. Y las citas no son una foto tomada una vez: npm run verify-rules vuelve a descargar cada fuente y compara cada cita palabra por palabra.
El mapa de respuestas: qué preguntas puede responder la página
Nuevo desde nuestro primer artículo, el mapa de respuestas reúne en una tabla las preguntas que la gente haría sobre una página: si la página responde a cada una, una calidad sobre 100 y qué falta. Las preguntas y los veredictos son juicio del agente; la calidad es una suma fija que calcula el script, así que los mismos archivos dan siempre el mismo número. Una respuesta completa suma 50 y una parcial 25; una respuesta citable por sí sola, 25; una respuesta que abre su pasaje, medida por el script, los últimos 25. Una respuesta parcial nunca llega a 100.
Pruébelo en una página propia
Vea qué encuentra Voicescope en una página suya
Todo lo anterior se puede medir en su propio trabajo, y la comprobación lleva cerca de un minuto. Pegue una dirección y lea lo que vuelve.
Abrir VoicescopeGratis · sin cuenta · una cada vez
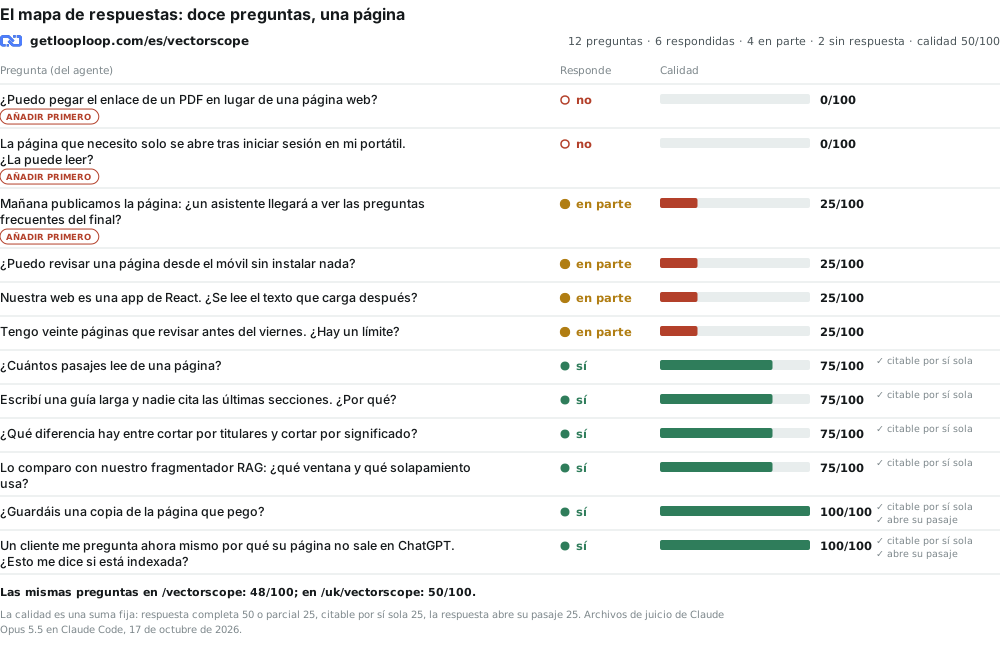
Leída desde abajo, la página está en buena forma: la mitad de las doce preguntas recibe una respuesta completa que se puede citar por sí sola, y dos, «¿guardáis una copia?» y «¿esto me dice si está indexada?», reciben una respuesta perfecta que abre su pasaje. Leída desde arriba, es un encargo de contenido. Nada en la página dice si funciona un enlace a un PDF ni qué pasa con una página tras un inicio de sesión, y la pregunta del día del lanzamiento sobre las preguntas frecuentes por debajo del corte solo se responde en parte. Las tres etiquetas «añadir primero» son los tres próximos párrafos que hay que escribir, ya ordenados.
La calidad es estricta a propósito. Cuatro respuestas completas se quedan en 75 porque la respuesta está en medio del pasaje y no al principio. Los asistentes citan pasajes, y la primera frase de un pasaje es la que más probablemente se cite, así que la puntuación premia la respuesta que va primero.
Calor: en qué parte de la página están los problemas
Una lista de diecinueve hallazgos no dice por dónde empezar. El mapa de la página sí: dibuja la página como un esquema, de <head> y robots.txt al pie, y fija cada hallazgo en el lugar donde se encontró. Desde 2.111 cada lugar se sombrea además por su calor, sus hallazgos ponderados por gravedad (bloqueante 8, alta 4, media 2, baja 1) frente al lugar más caliente. La cuadrícula de páginas y problemas del informe de sitio se sombrea igual.
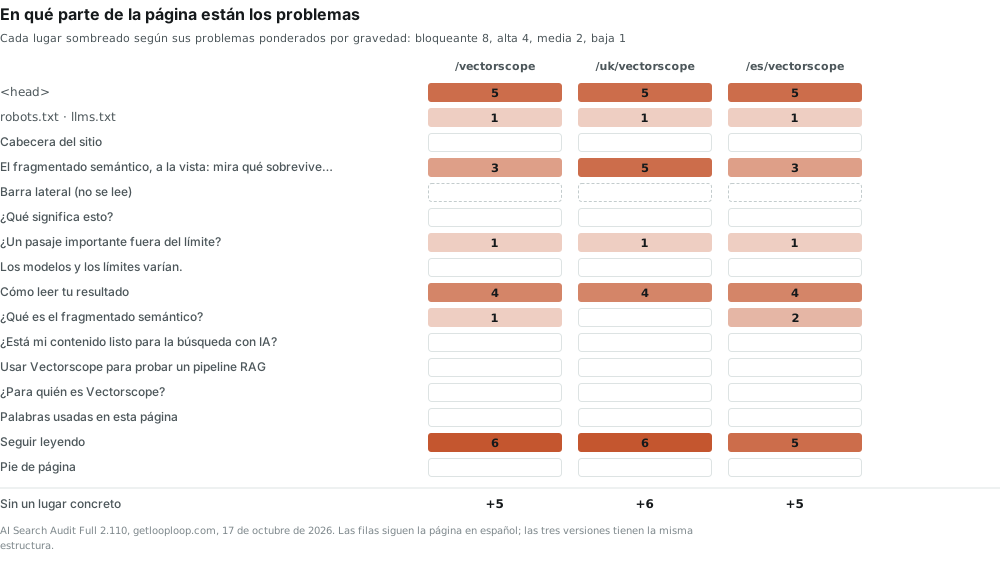
La imagen tranquiliza y concreta a la vez. Nueve o diez de los catorce lugares de cada página no tienen ningún hallazgo. El calor está en tres: el bloque «Seguir leyendo» del final (los enlaces rotos, un pasaje que empieza a mitad de frase, una forma de frase repetida, una respuesta parcial), el <head> (un campo obligatorio que falta en los datos estructurados, dos resultados enriquecidos retirados, el peso de la página) y la sección «Cómo leer tu resultado», tan larga que se corta a mitad de frase. Tres arreglos, en tres lugares conocidos, en tres páginas hechas con una plantilla: un ticket, no diecinueve.
La cabecera de la página ucraniana es el único lugar donde las versiones de idioma difieren: allí marca 5 y en las demás 3, porque la comprobación de palabra clave encontró la frase principal de la página ucraniana concentrada en pocas secciones. Es justo el tipo de diferencia que existe para mostrar un informe de sitio.
Cuánto suena a texto generado
Desde 2.109, al final de cada informe de página hay un bloque llamado «Cuánto suena a texto generado». Pone tres lecturas una al lado de la otra: la puntuación de patrones de escritura (frases hechas y formas de frase repetidas, contadas con su posición), las palabras que los modelos de lenguaje usan de más, y la prueba de sustitución del agente, un veredicto por pasaje sobre si podría pegarse sin cambios en la página de un competidor. Donde el agente y el script no coinciden, se muestran los dos, nunca un promedio. No es un detector de autoría, y el bloque lo dice.
| Página | Puntuación de patrones | Palabras de más | Pasajes genéricos (prueba de sustitución) |
|---|---|---|---|
| /vectorscope | 1 de 100 | 0 | 4 de 17 |
| /uk/vectorscope | 2 de 100 | 0 | 4 de 17 |
| /es/vectorscope | 0 de 100 | 0 | 5 de 18 |
Puntuaciones bajas en los tres idiomas y ni una sola palabra marcadora. Los pasajes que la prueba de sustitución llama genéricos son las advertencias («Esto no demuestra que ningún asistente haya indexado la página») y el párrafo de «para quién es»: frases que podría llevar la página de cualquier herramienta, una nota justa para un editor. El valor está en las posiciones: cada señal apunta a un pasaje y a una palabra, así que quien revisa puede comprobar la afirmación en segundos en lugar de creérsela.
Un historial que sobrevive al chat
Cada ejecución se guarda como una instantánea, y cada informe muestra qué cambió desde la anterior: título, descripción, canonical, h1, número de palabras, tipos de schema, robots.txt y cada bot, hreflang, pasajes nuevos, perdidos y cambiados, y hallazgos corregidos, nuevos y sin cambios. Desde 2.110 el historial vive en la carpeta del propio usuario, ~/.ai-search-audit/history, que no reinicia ni un chat nuevo, ni una carpeta de trabajo nueva, ni una versión nueva de la skill. Y como un entorno de chat como claude.ai puede olvidar su disco, cada informe lleva también el historial entero dentro: --history-from report.html lo recupera en la siguiente ejecución.
El ejemplo del repositorio muestra con qué cuidado se lee el cambio. La primera ejecución de /vectorscope, el 16 de octubre, leyó una copia guardada y encontró 18 problemas; la ejecución en vivo del 17 de octubre encontró 19. Nada empeoró. Un archivo guardado no tiene cabeceras de respuesta HTTP, así que la primera ejecución dio por no medida la comprobación de cabeceras de seguridad; la ejecución en vivo la midió y encontró que faltaban tres. El cambio registra que el número de palabras pasó de 2463 a 2469 y que cambió exactamente uno de los 17 pasajes. /es/vectorscope, leída en vivo dos veces con menos de un minuto de diferencia, muestra 18 y 18 y ningún cambio, que es lo que debe decir una auditoría estable.
Qué cambió desde 2.106
Cinco versiones en dos días, según el historial de commits del repositorio:
| Versión | Fecha | Qué añadió |
|---|---|---|
| 2.107 | 17 oct. 2026 | La marca de GetLoopLoop en el azul de la marca |
| 2.108 | 17 oct. 2026 | Se niega a auditar un dominio ruso, un alojamiento ruso o una página que declara una versión en ruso |
| 2.109 | 18 oct. 2026 | Cuánto suena a texto generado; los informes en polaco |
| 2.110 | 18 oct. 2026 | El historial sobrevive al chat, a la carpeta y a la versión |
| 2.111 | 18 oct. 2026 | El mapa de respuestas; calor en el mapa de la página y en la matriz del sitio; Vectorscope 2.111 sincronizado |
Instalar y ejecutar
La skill necesita Node 20.18 o posterior y ningún npm install: sus scripts van empaquetados. Para Claude Code, clona el repositorio y copia la carpeta de la skill en tu carpeta de skills (Codex, opencode y Hermes Agent usan la misma carpeta en sus propias rutas, que el README enumera):
gh repo clone Olexan-art/ai-search-audit-full
mkdir -p ~/.claude/skills
cp -r ai-search-audit-full/skills/ai-search-audit-full ~/.claude/skills/
Después pídeselo al agente con palabras normales: «una auditoría de búsqueda con IA de https://example.com/page» o «audita estas páginas de mi sitio». Para claude.ai y la aplicación de escritorio de Claude, descarga ai-search-audit-full.zip de las versiones del repositorio, activa la ejecución de código y súbelo en Customize > Skills sin descomprimirlo. Por dentro, el agente ejecuta dos scripts y escribe entre ellos sus propios archivos de juicio:
# una página
node dist/read.mjs https://example.com/page --out reading.json
# el agente escribe questions.json, style.json, brand.json y reviews.json
node dist/audit.mjs reading.json --questions questions.json --style style.json \
  --brand brand.json --reviews reviews.json --html report.html --json export.json

# un sitio, como mucho 50 páginas
node dist/read.mjs --sitemap https://example.com/sitemap.xml --out-dir readings
node dist/audit.mjs --site readings/site.json --questions-dir questions \
  --style-dir style --brand brand.json --reviews reviews.json --out-dir report

# antes y después: añade una exportación anterior al comando de una página
#   --compare old-export.json
Una auditoría de sitio es educada por diseño: lee las páginas de una en una, con al menos un segundo entre ellas, más cuando robots.txt fija una espera, y solo donde robots.txt la deja entrar. En el ejemplo salieron 81 peticiones para tres páginas y otras 39 se respondieron de memoria, porque robots.txt, el sitemap y los enlaces compartidos se descargan una sola vez.
Qué no hace
- No puntúa la página. Hallazgos, cada uno con su prueba y su regla; nunca un número sobre 100 para la página entera. La calidad del mapa de respuestas es por pregunta.
- Sin datos de campo ni estado de indexación. Core Web Vitals y «¿está en el índice de Google?» siempre aparecen como sin medir: necesitan datos de usuarios reales y Search Console.
- No predice qué responden los asistentes. Las lecturas de marca y reseñas son el conocimiento de un modelo, firmado con su nombre. En nuestras páginas el modelo, Claude Opus 5.5, no conocía GetLoopLoop, y la auditoría lo dice tal cual.
- No rastrea el sitio entero. Como mucho 50 páginas; las comprobaciones de sitio ven solo el conjunto auditado, y el informe advierte que una página huérfana en él puede tener enlaces desde fuera.
- Solo páginas públicas. Sin inicio de sesión, sin cookies, sin direcciones privadas y sin renderizar JavaScript salvo que se pida. Cada límite aparece en el informe; ninguno se aplica en silencio.
Preguntas frecuentes sobre AI Search Audit Full
¿AI Search Audit Full es gratuita?
Sí. Es de código abierto con licencia MIT y funciona en tu propio agente y tu propio equipo. No se envía nada a GetLoopLoop.
¿En qué se diferencia Full de AI Search Audit Lite?
Full ejecuta todas las comprobaciones de Lite y añade a cada problema una explicación sencilla, la regla citada y una dirección de arreglo; audita hasta 50 páginas con un informe de sitio, compara ejecuciones y guarda un historial local.
¿Llama a un modelo de IA o a una API de embeddings?
Los scripts no llaman a ningún modelo ni a ninguna API de embeddings. Las partes de juicio, como las preguntas y la lectura de marca, las escribe el agente que ejecuta la skill, y el informe las firma con su modelo.
¿De dónde salen las reglas?
83 reglas se citan palabra por palabra de sus fuentes, 53 de ellas de Google Search Central, cada una con su enlace y la fecha de comprobación. 39 reglas son propias de la skill y están marcadas así.
¿Puede auditar una página sin acceso a la red?
Sí. Guarda la página como HTML y, si puedes, su robots.txt, y dale los dos archivos al agente; cada comprobación que necesita la red queda marcada como no revisada.
El veredicto
En tres páginas reales, la auditoría hizo lo que debe hacer una auditoría. Descartó, con pruebas, lo que habría sido grave: todos los rastreadores con acceso, ningún hallazgo bloqueante ni alto, 25 de 35 comprobaciones superadas. Encontró un defecto real que se les había escapado a sus propios autores, dos enlaces muertos, y lo explicó con una frase que entiende un responsable, una regla que puede comprobar un especialista y un arreglo que puede aplicar un desarrollador. Convirtió doce preguntas en una lista ordenada de tres párrafos por escribir, y diecinueve hallazgos en tres lugares calientes de una sola plantilla. Y cada una de esas afirmaciones se puede comprobar: las reglas, contra sus fuentes; las cifras, contra los archivos del repositorio.
Por eso vale la pena ejecutarla antes de publicar y otra vez después de arreglar. Instálala desde GitHub, apúntala a la página que más te importa y lee lo primero que encuentre. El resto de la configuración está en Agent Skills para equipos de SEO, GEO y marketing, y lo que de verdad dicen los asistentes sobre tu marca, medido durante semanas y no una sola vez, es para lo que existe GetLoopLoop. Más sobre cómo elige sus fuentes la búsqueda con IA, en el glosario: AI Overviews y optimización para motores generativos.
El producto
Véalo en cada página, cada día
Una lectura dice dónde está una página hoy. El producto hace las mismas preguntas a los mismos asistentes de forma continua, así que un cambio es algo que se le cuenta y no algo que tenga que ir a buscar.
Pedir una invitaciónSolo por invitación mientras mantenemos honestas las lecturas
Sobre este tema
¿Está mi página lista para la búsqueda con IA?
Cada día Rastreos con la lectura de Vectorscope junto a cada página, comprobada de nuevo tras cada corrección. Cómo funciona el producto
Autor
Olexandrautor
Más de 15 años en marketing y SEO. Decenas de productos, sobre todo el mercado estadounidense. Investigación y medición.
LinkedInPass it on
Read in your language
Opens a browser translation of this English article. The original source stays in English.