GLLmolfar 0.9.36: un estudio de contenido y modelos integrados que funcionan en tu portátil
Dos experimentos en una versión: modelos Gemma 4 que se descargan dentro de la aplicación y funcionan sin claves ni conexión, y un estudio que escribe páginas, artículos y correos a partir de tus datos. Medido en un portátil, con capturas, tiempos y cada frase inventada que detectamos.
Traducido del original en inglés.
La respuesta corta
- what
- Dos funciones experimentales en 0.9.36: modelos Gemma 4 integrados (descargar, comprobar, eliminar, usar para todas las tareas) y un estudio de contenido para seis tipos de página con once diseños, comprobaciones sin modelo y una corrección puntual.
- why
- Un rastreo termina con una lista de páginas que escribir o reescribir. Hasta ahora eso exigía una cuenta en un servicio de modelos; los modelos abiertos pequeños ya sirven para hacer borradores si la aplicación se encarga de lo que hacen mal.
- who
- Quien rastrea sitios con GLLmolfar y quiere borradores escritos a partir de lo que encontró el rastreo, en su propio ordenador.
- where
- En el ordenador de la persona. Medido en un portátil con AMD Ryzen 9 8945HS, gráficos integrados Radeon 780M y 28,8 GB de memoria.
- when
- GLLmolfar 0.9.36 para Windows y Mac, publicado el 11 de noviembre de 2026; todas las mediciones son de ese mismo día.
- how
- Seis modelos locales probados con las tareas de la propia aplicación; la comprobación integrada en Gemma 4 12B; seis tipos de página generados a la antigua y con el estudio, cronometrados y leídos línea por línea.
Explicación sencilla
GLLmolfar ahora puede descargar un modelo de IA pequeño y ejecutarlo en tu propio ordenador, así que puede escribir sin una cuenta en ningún otro sitio. Es más lento y se equivoca más que los grandes asistentes de pago, y la aplicación lo dice en un recuadro rojo. También trae un estudio nuevo: le das datos de tu tienda o tu sitio y hace una página web, un artículo o un correo. El modelo solo escribe las palabras; la aplicación dibuja la página y comprueba que no se ha inventado nada.
GLLmolfar 0.9.36 trae dos partes nuevas, ambas marcadas como experimentales y ambas abiertas solo a aplicaciones con sesión iniciada. La primera ejecuta un modelo de IA dentro de la aplicación: lo descargas una vez y a partir de ahí responde en tu ordenador, sin clave, sin cuenta en otro sitio y sin conexión. La segunda es un estudio de contenido: convierte los datos que le das —un catálogo, los hallazgos de un rastreo— en una página, un artículo o un correo HTML.
Este artículo muestra las dos y mide las dos. Todo se ejecutó el 11 de noviembre de 2026 en un portátil normal: un AMD Ryzen 9 8945HS con gráficos integrados Radeon 780M y 28,8 GB de memoria, sin tarjeta gráfica aparte. GLLmolfar es nuestro, así que lee las afirmaciones sabiendo de quién es la herramienta; las cifras son las que obtuvimos, incluidas las que no la favorecen.
Modelos integrados
Ajustes › Modelos de IA abre ahora con una sección llamada Modelos integrados en este ordenador. Indica la memoria, la tarjeta gráfica y el espacio libre que encontró, y ofrece tres modelos, cada uno en su tarjeta. La primera pulsación descarga también el motor —llama.cpp, unos 40 MB—, que usa Vulkan en Windows (gráficos AMD, Intel y NVIDIA, también integrados) y Metal en Apple silicon. Si la tarjeta gráfica no puede con el modelo, la aplicación pasa al procesador y lo recuerda.
Una descarga se puede detener y reanudar donde se quedó, y el archivo terminado se comprueba contra su tamaño y su SHA-256 publicados antes de usarlo. Eliminar borra el archivo del modelo; al eliminar el último modelo se borra también el motor, de modo que no queda nada en la carpeta.
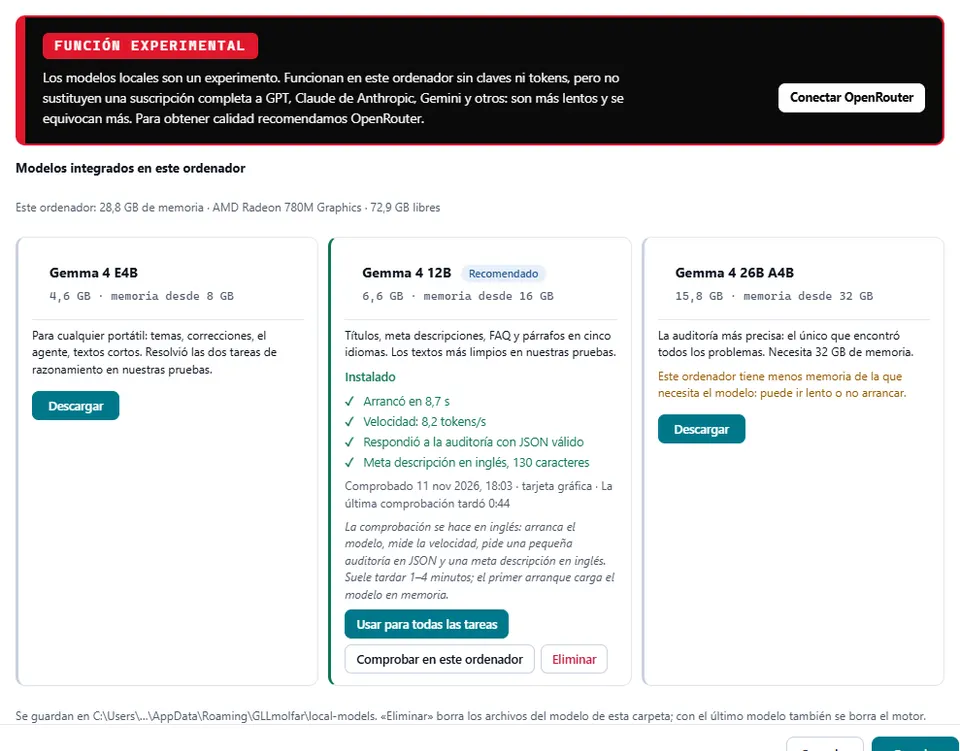
El recuadro rojo y negro de arriba está ahí a propósito y no desaparece. Los modelos locales son más lentos que los grandes modelos alojados y se equivocan más; no sustituyen una suscripción a GPT, Claude o Gemini, y para el trabajo que tiene que salir bien recomendamos conectar un modelo mediante OpenRouter, a una pulsación en el mismo recuadro. Los modelos integrados son para borradores, para el trabajo que no debe salir del ordenador y para probar las funciones de IA de la aplicación antes de decidir nada más.
Usar para todas las tareas pone el modelo instalado en los ocho papeles de IA de la aplicación —temas, correcciones, auditoría, consultas sobre páginas, el agente, contenido, comprobaciones y publicaciones sociales— con una pulsación, en lugar de elegirlo en cada lista. Un modelo que supera Comprobar en este ordenador se asigna además a cada papel que aún no tiene modelo, sin tocar los que ya configuraste de otra forma.
| Modelo | Descarga | Memoria que pide | Para qué sirve |
|---|---|---|---|
| Gemma 4 E4B | 4,6 GB | 8 GB | Cualquier portátil: temas, correcciones, el agente, textos cortos |
| Gemma 4 12B | 6,6 GB | 16 GB | Títulos, descripciones, FAQ y párrafos en cinco idiomas; recomendado desde 16 GB |
| Gemma 4 26B A4B | 15,8 GB | 32 GB | La auditoría más precisa; necesita 32 GB |
Por qué Gemma 4: seis modelos con las tareas de la aplicación
Antes de elegir qué integrar pasamos seis modelos abiertos actuales por el mismo script, en el mismo portátil, una vez en el procesador y otra en los gráficos integrados. Las tareas eran las que la aplicación da realmente a un modelo: una auditoría de ocho páginas con siete errores sembrados, devuelta en JSON; un título y una meta descripción en inglés, ucraniano, español, francés y polaco dentro de los límites de longitud; dos pequeñas tareas de razonamiento; y una llamada a herramientas en dos pasos. Esta prueba usó Ollama, no el motor de la aplicación, así que sus velocidades sirven para comparar modelos entre sí.
| Modelo | Tokens/s, gráficos (procesador) | Auditoría, errores de 7 | Errores inventados | Razonamiento, de 2 | Textos dentro de límites, de 5 idiomas |
|---|---|---|---|---|---|
| Gemma 4 E4B | 17,3 (10,1) | 4 · 8 s | 0 | 2 | 5 |
| Qwen3.5 4B | 19,1 (10,6) | 3 · 6 s | 0 | 2 | 2 |
| Qwen3.5 9B | 11,3 (6,3) | 2 · 9 s | 0 | 2 | 2 |
| Gemma 4 12B | 10,6 (9,6) | 6 · 16 s | 0 | 1 | 4 |
| Ministral 3 8B | 14,1 (6,6) | 5 · 20 s | 1 | 0 | 1 |
| Gemma 4 26B A4B | no arrancó (9) | 7 · 39 s | 0 | 2 | 2 |
Velocidad de escritura en gráficos integrados, tokens por segundo
Auditoría sin razonamiento: errores sembrados encontrados, de 7
Pruébelo en una página propia
Vea qué encuentra PatternScope en una página suya
Todo lo anterior se puede medir en su propio trabajo, y la comprobación lleva cerca de un minuto. Pegue una dirección y lea lo que vuelve.
Abrir PatternScopeGratis · sin cuenta · una cada vez
Lo que decidió:
- Gemma 4 hizo las mejores auditorías. Gemma 4 12B encontró 6 de 7 errores en 16 segundos sin razonamiento; el 26B, los 7. Ministral 3 8B encontró 5 e inventó uno. Qwen3.5 9B encontró 2 sin razonamiento; con razonamiento llegó a 6, pero tardó 5,2 minutos.
- El razonamiento es demasiado lento para ir por defecto. Con él, Gemma 4 E4B, 12B y 26B también llegaron a 6 de 7, en 1,5, 2,3 y 3 minutos. La aplicación pide respuestas sin él.
- La velocidad no es el cuello de botella que parece. Qwen3.5 4B fue el que más rápido escribió, 19,1 tokens/s, pero solo dejó 2 de 5 textos dentro de los límites y confundió de qué trataba la página.
- Textos: Gemma 4 E4B respetó los límites en los cinco idiomas y Gemma 4 12B en cuatro; leídos a mano, los textos del 12B eran gramaticalmente limpios en los cinco, con un tono algo publicitario. Los modelos Qwen y Ministral se salieron de los límites en la mayoría de idiomas, y Qwen3.5 9B aconsejó borrar las páginas huérfanas cuando la tarea era enlazarlas.
Dos resultados fueron iguales para los seis. Todos completaron bien la llamada a herramientas en dos pasos. Y ninguna respuesta en ucraniano de ningún modelo contenía una letra rusa, algo que comprobamos de forma automática en todo lo que escribe la aplicación, porque un modelo al que se le pide ucraniano puede deslizarse hacia la ortografía rusa.
La comprobación en este ordenador
Una prueba en nuestro portátil dice poco del tuyo, así que cada tarjeta tiene Comprobar en este ordenador. Arranca el modelo, mide lo rápido que escribe, pide una pequeña auditoría en JSON y una meta descripción, y muestra cada paso mientras ocurre, con un reloj y el registro del propio motor —cuántas capas fueron a la tarjeta gráfica, qué está cargando—, para que un primer arranque largo no parezca un cuelgue. La comprobación siempre se hace en inglés, sea cual sea el idioma de la interfaz, para que sus resultados se puedan comparar entre equipos; la tarjeta lo dice bajo el botón.
En el portátil de prueba, Gemma 4 12B superó los cuatro pasos en la tarjeta gráfica: arrancó en 8,7 s, escribió 8,2 tokens por segundo, devolvió JSON válido y una meta descripción en inglés de 130 caracteres; toda la comprobación duró 44 segundos. El primer arranque, con el modelo aún fuera de la memoria, tardó 33 s. Este es el motor de la propia aplicación, llama.cpp sobre Vulkan, así que su velocidad no es directamente comparable con la prueba en Ollama.
Gemma 4 12B en la aplicación: segundos hasta arrancar
El estudio de contenido
El estudio es una sección nueva en la barra izquierda, también experimental. Hace seis cosas: un artículo, una página de inicio, una lista de productos, una página de producto, una página de alternativas y un correo HTML. Le indicas el sitio o la marca, la búsqueda para la que es la página, el público, el objetivo, el idioma y —lo importante— los datos que el modelo puede usar. Escribe con el modelo asignado al papel de contenido: uno integrado, Ollama o LM Studio en el mismo ordenador, o un modelo alojado mediante OpenRouter.
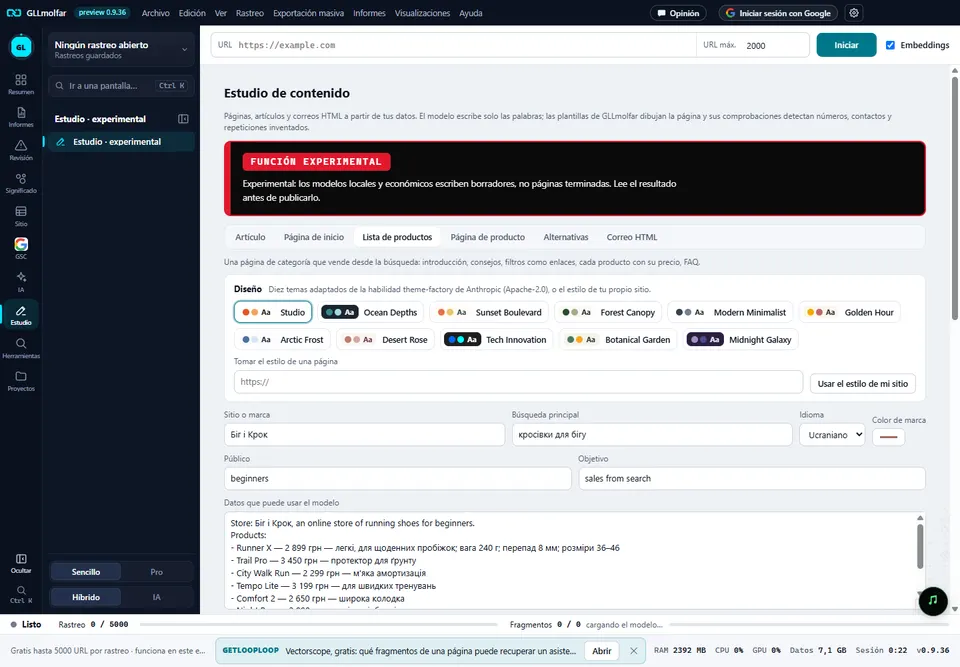
El cambio de verdad de esta versión es cómo funciona. La primera versión de la función pedía al modelo una página HTML entera, y a los modelos pequeños eso se les da mal: el diseño cambiaba de una página a otra y en el pie y el texto aparecían cosas que nadie les había dado. Ahora el modelo devuelve solo el contenido, en JSON —un titular, una introducción, los productos con sus notas, las FAQ—, y las plantillas de GLLmolfar dibujan la página. Después vienen comprobaciones que no necesitan ningún modelo:
- cada número del texto debe aparecer en los datos («2 480» y «2,480» cuentan como el mismo número);
- cada teléfono, dirección de correo y año debe aparecer en los datos;
- se marcan las afirmaciones sobre el negocio que los datos no hacen, como «hemos desarrollado» o «nuestros especialistas»;
- las repeticiones se detectan por secuencias de tres palabras compartidas;
- se mide la longitud de títulos y descripciones, y en ucraniano se marcan las letras rusas.
Lo que encuentran vuelve al modelo una sola vez, como corrección puntual de esos campos, no como «reescríbelo». Lo que sigue mal aparece encima del resultado, de modo que el borrador llega con su propia revisión.
Los artículos tienen un paso más. Un texto largo escrito de una vez por un modelo pequeño pierde el hilo; escrito por secciones, cada sección repite la anterior. El estudio escribe un esquema, luego cada sección viendo lo que ya se ha dicho, lo que viene después y el texto hasta ahí, y al final las FAQ.
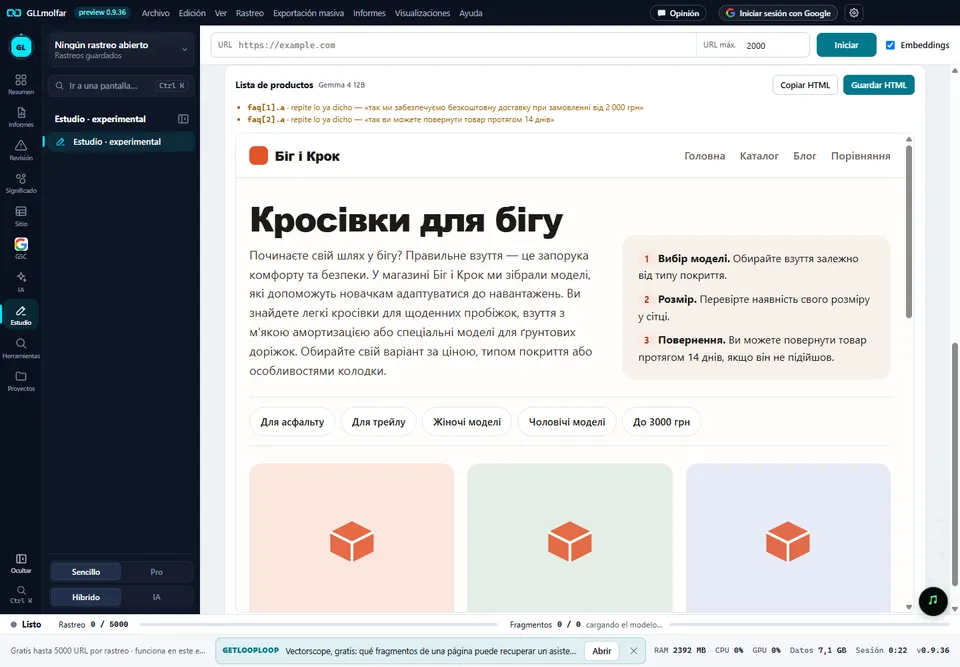
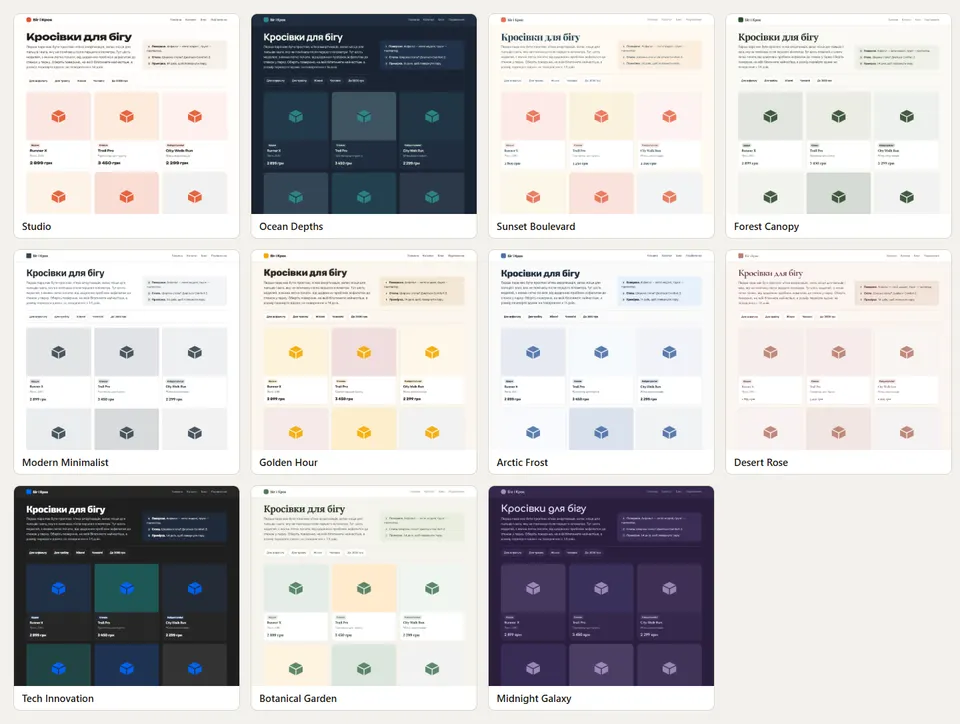
El diseño se elige entre once temas. Uno es el propio del estudio; diez están adaptados de la habilidad theme-factory que Anthropic publica con licencia Apache-2.0, con fuentes que incluyen cirílico. O pulsa Usar el estilo de mi sitio: la aplicación abre la página que indiques en una ventana oculta, lee los colores de fondo, texto y botones, las fuentes y el redondeo de los botones, oscurece o aclara cualquier color de texto o de acento que no alcance el contraste, y ofrece el resultado como un tema más. El correo HTML tiene su propia plantilla —tablas, 600 píxeles de ancho, estilos en línea— porque los programas de correo no dibujan las maquetaciones como un navegador.
Antes y después, con el mismo modelo
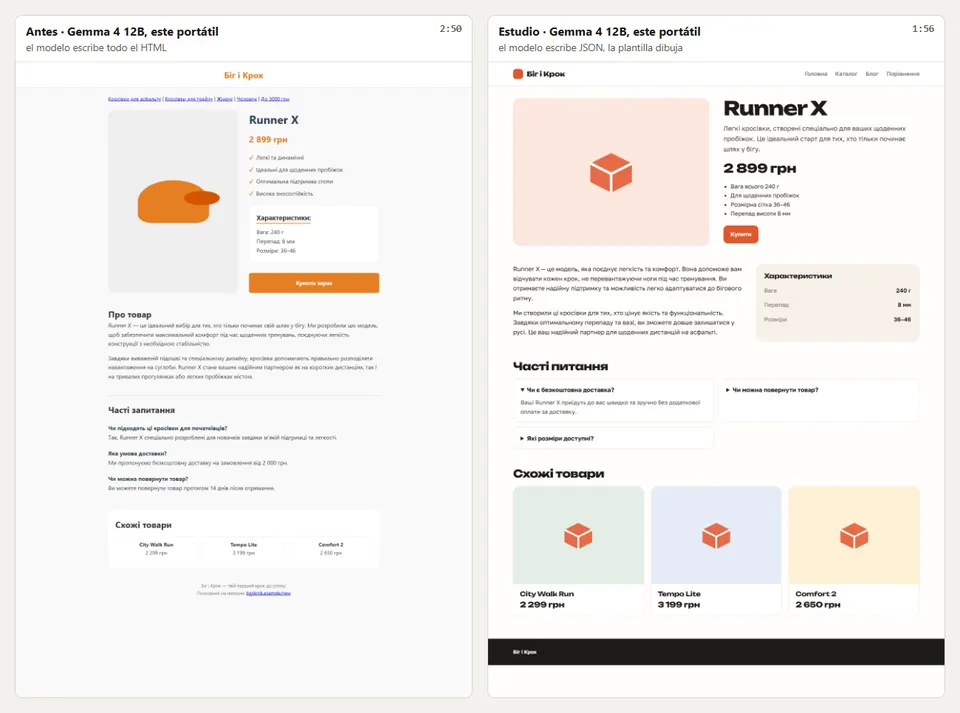
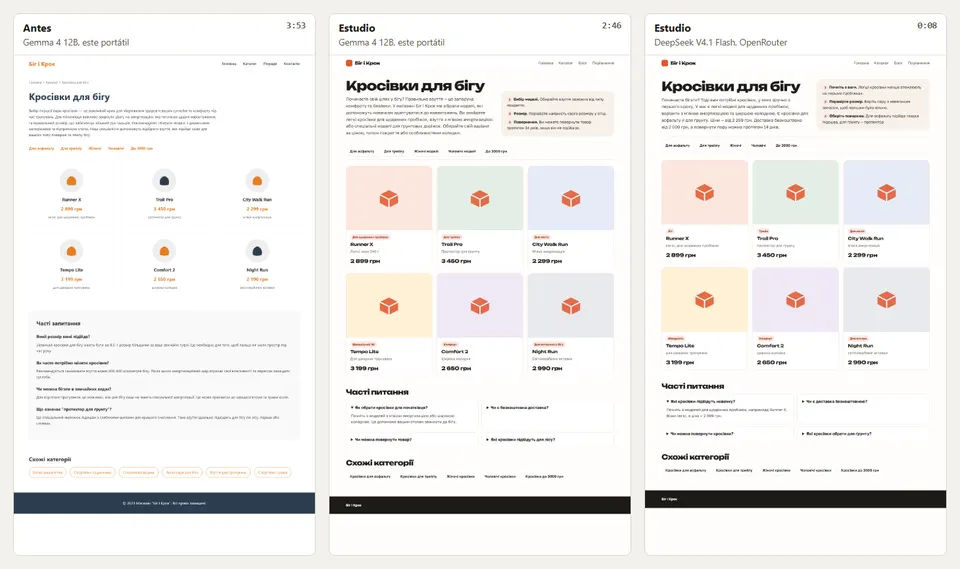
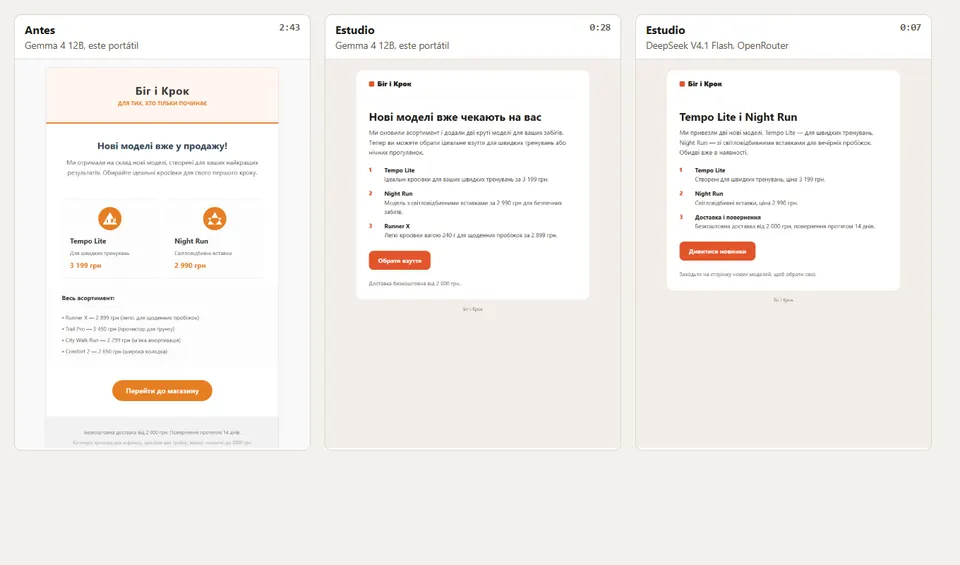
Para ver cuánto vale el proceso generamos los seis tipos dos veces con el mismo modelo local, Gemma 4 12B, y el mismo encargo: una vez a la antigua, con el modelo escribiendo la página HTML entera, y otra con el estudio. Después pasamos el estudio una vez más por un modelo alojado pequeño, DeepSeek V4.1 Flash mediante OpenRouter, para mostrar adónde lleva una conexión rápida. Los tiempos son por página, de la primera llamada a la página terminada, corrección incluida.
| Página | Antes: Gemma 4 12B escribe HTML | Estudio: Gemma 4 12B | Más rápido | Estudio: DeepSeek V4.1 Flash |
|---|---|---|---|---|
| Artículo | 4:36 | 3:39 | 1,3× | 0:45 |
| Página de inicio | 3:33 | 2:21 | 1,5× | 0:16 |
| Lista de productos | 3:53 | 2:46 | 1,4× | 0:08 |
| Página de producto | 2:50 | 1:56 | 1,5× | 0:22 |
| Alternativas | 4:18 | 1:28 | 2,9× | 0:14 |
| Correo HTML | 2:43 | 0:28 | 5,8× | 0:07 |
Cuántas veces más rápido escribió el estudio cada página con Gemma 4 12B
La velocidad es la mitad pequeña. La grande es lo que contenían las páginas antiguas sin que nadie se lo hubiera dado al modelo:
- una línea de copyright con © 2023 en la página de inicio, la lista de productos y la de alternativas;
- «nuestros especialistas te ayudarán» en la lista de productos: los datos de la tienda no mencionan especialistas;
- «Hemos desarrollado este modelo» y «alta resistencia al desgaste» en la página de producto: la tienda vende las zapatillas, no las fabrica, y los datos no dicen nada del desgaste;
- tres palabras que no existen en ucraniano, en el artículo.
Con el estudio no quedó nada de eso. Se coló una en la página de producto —«Ми створили», «hemos creado»— y la comprobación de afirmaciones ahora detecta también esa fórmula. En la página de inicio, la corrección mezcló una pregunta de las FAQ con su respuesta y la lista de resultados no lo detectó; es el punto más débil que conocemos, y la siguiente comprobación será que cada respuesta corresponda a su pregunta. DeepSeek con el estudio no inventó nada en ninguna de las seis páginas.
Para qué sirve aquí un modelo local
En este portátil, Gemma 4 12B con el estudio necesita de uno a cuatro minutos por página y da un borrador que hay que leer: las comprobaciones y la corrección detectan la mayoría de fallos, no todos, y el estilo tira a formal. Es útil cuando los datos no deben salir del ordenador, cuando quieres veinte borradores durante la noche o cuando no hay ninguna cuenta que conectar. DeepSeek V4.1 Flash mediante OpenRouter escribió las mismas seis páginas entre diez y veinte veces más rápido y no inventó nada, lo que convierte a un modelo alojado pequeño en la mejor opción para el día a día. También pedimos a Claude Opus que escribiera una vez los mismos seis contenidos para las mismas plantillas, fuera de la aplicación y sin cronometrar: fue el más denso y el más franco —escribió «no hay datos de peso» donde los datos no los tenían— y merece la pena cuando un texto va a un cliente sin editar.
El estudio no decide eso por ti. Junto al resultado muestra qué modelo escribió la página, y el mismo encargo se puede volver a lanzar con otro.
Cómo probarlo
Actualiza GLLmolfar a 0.9.36 en Windows o Mac e inicia sesión; mientras sean experimentos, ambas funciones están abiertas a aplicaciones con sesión iniciada. Los modelos están en Ajustes › Modelos de IA; el estudio, en la barra izquierda. Un modelo pesa varios gigabytes, así que descárgalo en una conexión que no te importe usar para ello. Tras la descarga, el modelo integrado funciona sin conexión. Solo medimos en Windows; en Apple silicon el motor es la misma versión sobre Metal y aún no tenemos cifras de un Mac.
Un cambio en lo que envía la aplicación: las estadísticas de uso anónimas incluyen ahora qué modelos integrados están instalados, solo con su nombre de catálogo (por ejemplo, gemma4-12b), para ver qué tamaños conserva la gente de verdad. La pantalla de ajustes y la página de GLLmolfar lo enumeran junto con todo lo demás que envía la aplicación; nunca incluye una dirección de sitio, una consulta ni nada de lo que escribió un modelo.
Questions people ask
¿Los modelos integrados sustituyen a ChatGPT, Claude o Gemini?
No, y la aplicación lo dice en el recuadro rojo sobre los modelos. Son más lentos y se equivocan más. Para el trabajo que tiene que salir bien, conecta un modelo mediante OpenRouter; los integrados son para borradores y para datos que deben quedarse en el ordenador.
¿Qué modelo descargo?
Gemma 4 12B si el ordenador tiene 16 GB de memoria o más: en nuestras pruebas escribió el texto más limpio en cinco idiomas, y la aplicación lo marca como recomendado. Gemma 4 E4B con 8 GB. Gemma 4 26B A4B fue el auditor más preciso, pero pide 32 GB.
¿Sale algo de mi ordenador cuando uso un modelo integrado?
El modelo y el motor se descargan una vez. Después el modelo responde en local y las comprobaciones del estudio también se hacen en local. Las estadísticas de uso dicen qué modelos integrados están instalados, por su nombre de catálogo, y nada de lo que escribieron.
¿Por qué la comprobación se hace en inglés?
Para que sus resultados signifiquen lo mismo en cualquier ordenador y con cualquier idioma de interfaz. Escribir en tu idioma es para lo que luego usan el modelo el estudio y las demás funciones.
¿Puedo publicar lo que escribe el estudio sin leerlo?
No lo haríamos. Las comprobaciones detectan números, contactos, años y afirmaciones inventados, y repeticiones, pero no todos los errores: en una página de nuestras pruebas la corrección intercambió una pregunta y una respuesta de las FAQ. Trata el resultado como un borrador.
Cómo se midió
Un portátil: AMD Ryzen 9 8945HS, gráficos integrados Radeon 780M con Vulkan, 28,8 GB de memoria, Windows, 11 de noviembre de 2026. Elección de modelos: Ollama, un script, seis modelos, pruebas en procesador y gráficos guardadas en JSON por modelo. Comprobación en la aplicación: GLLmolfar 0.9.36, llama.cpp versión b12284, los valores que guarda la comprobación y muestra la tarjeta. Estudio: un encargo para una tienda de zapatillas con seis productos, Gemma 4 12B Q4_K_M en Ollama sobre los gráficos y deepseek/deepseek-v4.1-flash mediante OpenRouter, tiempo total por página. Lo inventado se encontró leyendo cada página frente a los datos y se confirmó buscando en el HTML guardado. Las capturas son de GLLmolfar 0.9.36 con un perfil aislado que contiene el archivo real del modelo y el resultado real de la comprobación, y de las páginas que produjeron las pruebas.
Relacionado: GLLmolfar.
El producto
Véalo en cada página, cada día
Una lectura dice dónde está una página hoy. El producto hace las mismas preguntas a los mismos asistentes de forma continua, así que un cambio es algo que se le cuenta y no algo que tenga que ir a buscar.
Pedir una invitaciónSolo por invitación mientras mantenemos honestas las lecturas
Sobre este tema
¿Está mi página lista para la búsqueda con IA?
Cada día Rastreos con la lectura de Vectorscope junto a cada página, comprobada de nuevo tras cada corrección. Cómo funciona el producto
Autor
Olexandrautor
Más de 15 años en marketing y SEO. Decenas de productos, sobre todo el mercado estadounidense. Investigación y medición.
LinkedInPass it on
Read in your language
Opens a browser translation of this English article. The original source stays in English.