

Vectorscope como Agent Skill: lo que un recuperador conserva de una página
La skill gratuita Vectorscope aplica a cualquier página pública la descarga, la limpieza, el troceado y el tope de 26 pasajes de un recuperador, en tu propio agente. Tres ejecuciones de ejemplo muestran qué mide, qué encuentra y cómo cada hallazgo se convierte en un arreglo.
Traducido del original en inglés.
La respuesta corta
- what
- Vectorscope 2.112, una Agent Skill de código abierto que aplica la descarga, la extracción, el troceado y el tope de 26 pasajes de GetLoopLoop a entre 1 y 5 páginas públicas, revisa robots.txt para doce rastreadores y genera un informe HTML con la agrupación, la prueba de preguntas y el plan de reescritura del agente.
- why
- Porque un asistente cita pasajes, no páginas, y casi todo lo que decide qué pasajes existen ocurre antes de que un modelo lea una sola palabra. Una página puede ser excelente y aun así perder su mejor respuesta por el tope, partida a mitad de frase o sin llegar a extraerse.
- who
- Redactores y responsables de contenido que necesitan saber si los párrafos clave de una página pueden citarse, SEO que explican por qué una página larga rinde poco en las respuestas de IA y desarrolladores que quieren ver qué hace su marcado con el texto.
- where
- En GitHub con licencia MIT, para Claude Code, Codex, opencode y otros agentes que cargan skills SKILL.md, y como zip para claude.ai y la aplicación de escritorio de Claude.
- when
- Publicada el 18 de octubre de 2026. Las ejecuciones de una sola página citadas aquí se hicieron el 18 de octubre de 2026 con la 2.111; la comparación, el 17 de octubre de 2026.
- how
- Scripts deterministas de Node hacen la descarga, la limpieza, el troceado, el tope y las comprobaciones sin llamar a ningún modelo ni a ningún servicio de embeddings. El agente que ejecuta la skill lee los pasajes y escribe las partes de juicio, y los scripts comprueban cada cita suya palabra por palabra.
Explicación sencilla
Un asistente de IA no lee tu página entera. Un programa la descarga, tira el código y los menús, y corta lo que queda en trozos. Se queda con 26 trozos como mucho, y el asistente responde a partir de ellos. Vectorscope es una herramienta gratuita que le das a tu propio ayudante de IA. Hace esos mismos pasos con cualquier página y te enseña los trozos: qué partes de la página entraron, cuáles no, qué preguntas pueden responder los trozos y qué frases reescribir para que cada trozo se entienda por sí solo.
La semana pasada presentamos tres Agent Skills gratuitas en un solo artículo, La IA lee tu página a trozos. Este es el primero de los análisis en profundidad, y empieza por la skill sobre la que se construyen las otras dos: Vectorscope.
Su tarea es concreta y, creemos, infravalorada. No te dice lo buena que es una página. Te muestra lo que un recuperador conserva de ella. Un asistente que responde una pregunta no lee tu página: lee unos pocos pasajes cortados de ella, y lo que no sobrevivió al corte no se puede citar, por bueno que sea. La skill hace ese corte en tu propia máquina, con tu propio agente, y te entrega un informe que puedes comprobar línea por línea.
Todo lo que sigue sale de las tres ejecuciones de ejemplo guardadas en el repositorio: nuestra propia página de Vectorscope y el artículo de Wikipedia sobre grandes modelos de lenguaje, ambos leídos el 18 de octubre de 2026, y una comparación de las guías de MDN y web.dev sobre la caché HTTP, leída el 17 de octubre de 2026. Puedes abrir los mismos archivos y obtener los mismos números.
Qué hace la skill, paso a paso
La skill son dos scripts con la lectura del agente en medio. Los scripts son deterministas: la misma página da los mismos pasajes en cualquier máquina y con cualquier modelo. El README del repositorio marca el límite en una línea:
No clasifica tu página, no decide quién la escribió ni predice lo que dirá de ti ningún asistente.
getlooploop-skills, README.md (traducción)
1. Lectura (script). read.mjs descarga la página y su robots.txt, quita lo que quita el limpiador de un recuperador (scripts, estilos, menús, cabeceras, pies, texto oculto, controles de formulario), corta el resto por los encabezados h2 en ventanas de 2000 caracteres como máximo con 200 de solapamiento y se detiene en 26 pasajes. El tope es una constante con nombre, CHUNKS_PER_PAGE = 26, en chunk.mjs. 2. Agrupación (juicio). El agente lee cada pasaje y los agrupa por tema. El Vectorscope web lo hace con embeddings; la skill no llama a ningún servicio de embeddings, así que el informe marca cada grupo como lectura del agente. 3. Lente (script). lens.mjs ejecuta las comprobaciones, cuenta las frases de la página y genera el informe. 4. Juicio (juicio). El agente escribe una prueba de preguntas, una lectura pasaje a pasaje de lo genérico que es el texto y un plan de reescritura. El script rechaza cualquier cita que no esté literalmente en su pasaje.
Cada número del informe lleva una de tres etiquetas: medido (lo que vio el analizador), derivado (una fórmula fija sobre lo medido) o juicio (la lectura del agente). Un «?» junto a cada número abre su fórmula, unidad, umbral y límites conocidos. SKILL.md obliga al agente a decir qué es cada cosa:
Los scripts no llaman a ningún modelo ni a ninguna API de embeddings. La lectura es tuya; dilo.
skills/vectorscope/SKILL.md, regla R6 (traducción)
Casi toda la página no es texto
Lo primero que mide la skill es cuánto del HTML descargado merece leerse. En las cuatro páginas de ejemplo la respuesta va de menos de un tercio a unos dos tercios.
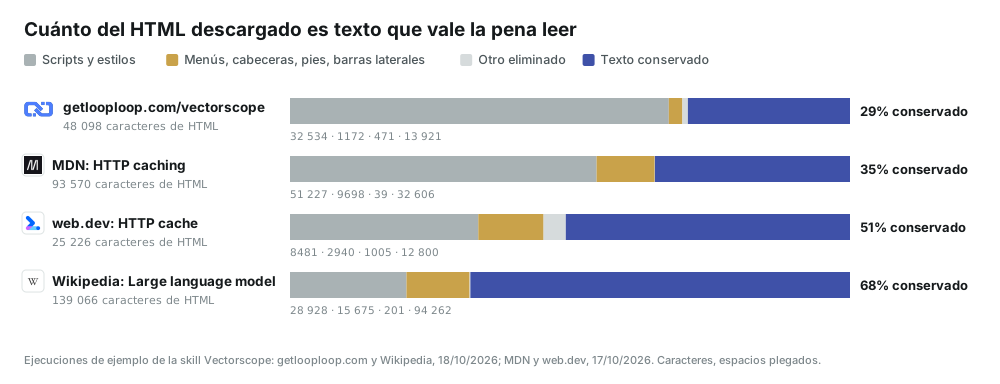
Los scripts y los estilos dominan en todas partes. En nuestra página, una aplicación Next.js, son 32 534 de 48 098 caracteres; menús, pie y barra lateral suman solo 1172. Wikipedia conserva más que ninguna, el 68%, porque es casi todo artículo, y lo más grande que pierde después de los scripts es la navegación: 14 208 caracteres. Nada de esto es un problema en sí. Un recuperador debe tirarlo. La figura sirve para la pregunta siguiente: del texto conservado, ¿cuánto llega a un pasaje?
El informe la responde con una tabla de cada elemento eliminado, su ruta CSS y sus caracteres, de mayor a menor. En esa tabla un desarrollador encuentra los casos que sí son un problema: unas preguntas frecuentes cuyas preguntas están en elementos <button>, o texto principal dentro de un <aside>.
Wikipedia: dónde cae el tope de 26 pasajes
El artículo de Wikipedia sobre grandes modelos de lenguaje tiene 13 718 palabras y llena los 26 huecos. La skill informa de 55 001 caracteres más allá del tope, como su único hallazgo de gravedad alta, cap_overflow. El mapa de secciones muestra exactamente qué partes son.
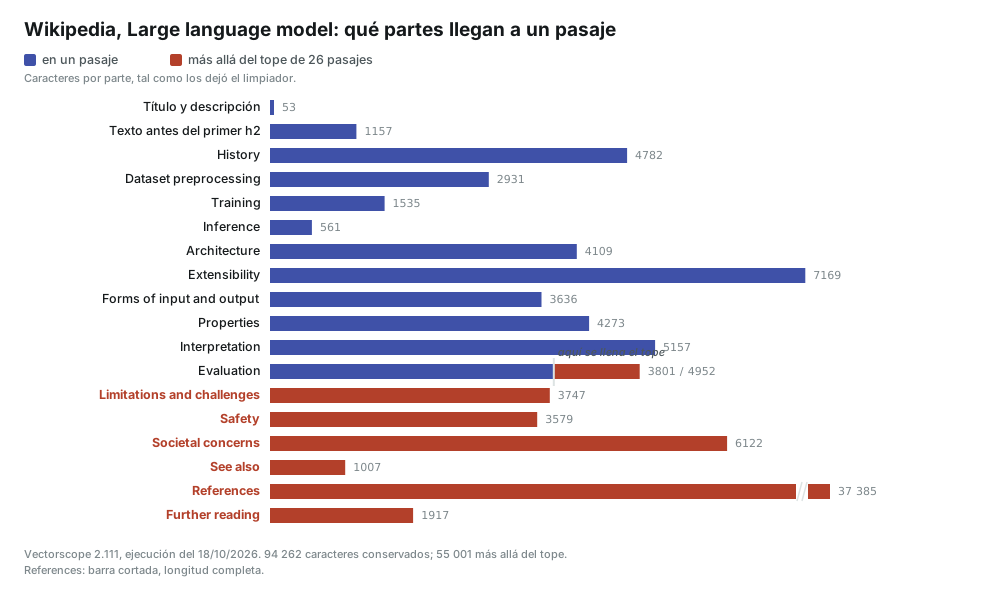
Aquí importa leer con justicia. References son 37 385 caracteres por sí sola, y nadie necesita que un recuperador cite una lista de referencias. Pero tres de las partes perdidas son prosa: Limitations and challenges, Safety y Societal concerns. Un recuperador con tope que leyera este artículo en orden sabría cómo se construyen los modelos de lenguaje y muy poco de lo que falla en ellos.
La prueba de preguntas muestra la consecuencia. El agente, Claude Opus 5.5 en Claude Code, escribió ocho preguntas típicas y buscó el pasaje que responde a cada una. Seis tienen respuesta, cinco completa. Dos no tienen ningún pasaje: «how much energy do LLMs use» (cuánta energía consumen los LLM) y «can LLMs reproduce copyrighted text» (pueden los LLM reproducir texto protegido por derechos de autor). El plan de reescritura del agente señala dónde están esas respuestas: en Societal concerns, más allá del tope.
Para este tipo de hallazgo existe la herramienta: no una puntuación, sino un lugar de la página y un motivo. El primer punto del plan es estructural: llevar el detalle de las largas secciones centrales a sus propios artículos para que las secciones finales entren en el tope. El resto son ediciones de línea, cada una con el texto original y la reescritura. El artículo de Wikipedia no tiene meta descripción, así que el primer pasaje contiene solo el título dos veces:
Pruébelo en una página propia
Vea qué encuentra Vectorscope en una página suya
Todo lo anterior se puede medir en su propio trabajo, y la comprobación lleva cerca de un minuto. Pegue una dirección y lea lo que vuelve.
Abrir VectorscopeGratis · sin cuenta · una cada vez
| Comprobación | Antes (literal del pasaje) | Después (reescritura del agente) |
|---|---|---|
| meta_description_missing | Large language model - Wikipedia Large language model | Large language model - Wikipedia. A large language model (LLM) is a neural network trained on a vast amount of text to generate, summarise, translate and analyse language. |
| mid_sentence_start | used LSTM-based encoder-decoder architectures, as they preceded the invention of transformers. | Early neural machine translation used LSTM-based encoder-decoder architectures, because they preceded the invention of transformers. |
La segunda fila es el hallazgo más común de los ejemplos. Una sección de más de 2000 caracteres la corta la ventana, y el pasaje siguiente empieza a mitad de frase, sin sujeto. En este artículo lo hacen 14 pasajes. Citado solo, «used LSTM-based encoder-decoder architectures» no dice quién las usaba.
Nuestra página: todo cabe, y aun así tiene cuatro hallazgos
La página del propio Vectorscope, leída el mismo día, tiene 2463 palabras, necesita 17 pasajes y no pierde nada por el tope. Su robots.txt deja pasar a los doce rastreadores de IA y de búsqueda. De las ocho preguntas que escribió el agente, seis tienen respuesta completa y dos parcial. Esa es la buena noticia, y está medida.
Pero no está limpia, y la dejamos así a propósito en el ejemplo. La skill encuentra cuatro cosas:
- Navegación dentro del contenido (media). El widget de resultado vacío está dentro de
main, así que sus etiquetas de pasos se convierten en texto del pasaje: «passages read», «slots used of the 26-passage cap». Un recuperador las guarda como contenido. - Dos pasajes que empiezan a mitad de frase (media). How to read your result es un solo h2 de 2257 caracteres, así que la ventana lo corta y un pasaje empieza con «to quote.».
- Una sección escasa (baja). Important passage outside the cap? tiene 139 caracteres debajo, por debajo del umbral de 150.
- Una frase repetida entre grupos (baja): una frase de cuatro palabras en al menos la mitad de los seis grupos.
Cada una viene con su arreglo. En la sección escasa, la respuesta se apoyaba en su encabezado. El plan convierte «Move it earlier on the page, or split the page so that passage has a budget of its own.» en «If an important passage falls outside Vectorscope's 26-passage cap, move it earlier on the page, or split the page so that passage has a budget of its own.» La segunda frase se puede citar sola; la primera, no. Ese único cambio es casi todo lo que hace citable un pasaje.
Ocho preguntas por página
La prueba de preguntas es la parte del informe que se lee primero, porque responde a lo que de verdad interesa: si alguien pregunta esto, ¿hay un pasaje que lo responda, y con qué palabras? En las cuatro páginas de ejemplo queda así.
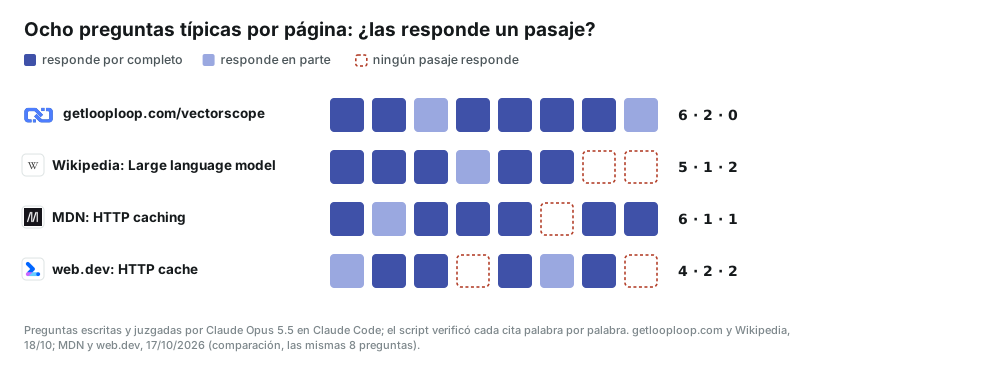
Un veredicto es juicio del agente, y el informe lo dice. Lo que lo mantiene honesto es la cita: un veredicto «completa» debe llevar las palabras exactas que un recuperador podría devolver, y lens.mjs rechaza el archivo si esas palabras no están en el pasaje. En nuestra página, la respuesta a «is Vectorscope free» es un pasaje que empieza «Is it really free? Yes, with a rate limit rather than a paywall.» Es una frase que un asistente puede tomar tal cual.
Dos páginas sobre un mismo tema
El modo comparación lee de 2 a 5 páginas, pide al agente una lista común de temas y pone las páginas una junto a otra. El ejemplo enfrenta la guía de MDN sobre caché HTTP con el artículo de web.dev sobre la caché HTTP.
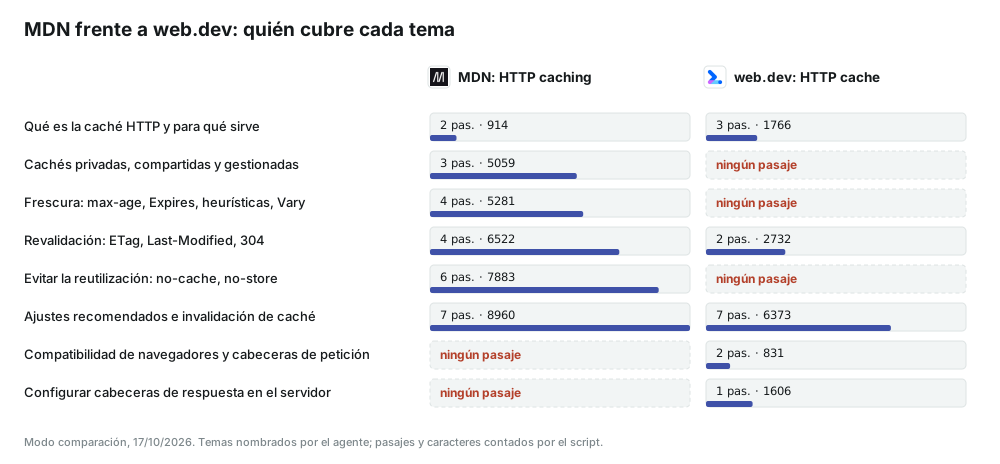
Las dos páginas no compiten por el mismo lector, y la tabla lo muestra de un vistazo. MDN es la referencia: seis temas, todos los huecos llenos, nada más allá del tope. web.dev es la guía práctica: menos temas, pero la única de las dos con un pasaje sobre configurar un servidor. La prueba de preguntas coincide. MDN no tiene pasaje para «how to set caching headers in nginx»; web.dev no lo tiene para «what is a shared cache» ni para «does the browser revalidate when the user reloads». Si escribes la tercera página sobre este tema, esos huecos son tu índice.
Que MDN quepa justo en 26 pasajes es también fruto de la historia de la skill. Antes de la 2.103, un h3 que repetía el texto de un h2 cortaba una sección en el sitio equivocado y empujaba la última sección de MDN más allá del tope. El arreglo está en el registro de cambios, y el README dice que ese hueco lo ocupa ahora la última sección de la página.
Qué ha cambiado desde la 2.106
El resumen describía la versión 2.106. Desde entonces la skill lee más y rechaza más, según su historial de commits:
| Versión | Qué añadió |
|---|---|
| 2.109 | Cabeceras de respuesta (X-Robots-Tag, Cache-Control) y comprobaciones de accesibilidad: imágenes sin texto alternativo, alt que es solo un nombre de archivo, saltos de nivel de encabezado, más de un h1 |
| 2.110 | Rechaza un dominio ruso, un alojamiento ruso y una página que declara una versión en ruso |
| 2.111 | Cuánto suena a texto generado: la puntuación de PatternScope, las palabras que los modelos de lenguaje usan en exceso y la prueba de sustitución del agente; el informe en polaco |
| 2.112 | Un nombre de marca en minúscula al inicio de un pasaje ya no cuenta como mitad de frase; SKILL.md reescrito en inglés controlado |
La mayor es la 2.111, una sección llamada Cuánto suena a texto generado. Pasa los detectores de PatternScope por el texto de la página, cuenta las palabras que los modelos de lenguaje usan en exceso y le hace al agente otra pregunta sobre cada pasaje: ¿encajaría en la página de un competidor cambiando solo el nombre? Nuestra página puntúa 1 de 100, sin palabras marcadoras, y el agente considera genéricos 4 de sus 17 pasajes, el 13% del texto de los pasajes. Wikipedia puntúa 10 de 100, casi todo por formatos de cita repetidos en las referencias, y tiene 3 pasajes genéricos de 26. Donde el script y el agente discrepan, el informe muestra ambos; en nuestra página discrepan en dos pasajes.
El README es explícito sobre lo que esta sección no es:
No es un detector de autoría, y el bloque lo dice.
getlooploop-skills, README.md, sobre «Cuánto suena a texto generado» (traducción)
El rechazo de la 2.110 es una política, no un límite técnico: las páginas en ruso o de sitios rusos se rechazan en lugar de analizarse, pida lo que pida el usuario. En los ejemplos tiene un coste visible. web.dev declara ahora una versión en ruso, así que la comparación de arriba es la ejecución del 17 de octubre, y el README explica por qué no se volvió a generar.
Instalar y ejecutar
La skill necesita Node 20.18 o posterior y ningún npm install: los scripts van empaquetados con su única dependencia. Con la CLI de skills, un solo comando la instala para Claude Code, Codex, opencode y otros agentes que cargan skills SKILL.md:
npx skills add Olexan-art/getlooploop-skills --skill vectorscopeDespués pídeselo a tu agente con palabras normales: «ejecuta vectorscope en https://example.com/page» o «compara estas dos páginas con vectorscope». Para claude.ai y la aplicación de escritorio de Claude, descarga vectorscope.zip de las versiones publicadas, activa la ejecución de código y sube el zip en Customize > Skills sin descomprimirlo. El entorno aislado necesita acceso de red al sitio que lee. Sin red, guarda la página como HTML y dale el archivo al agente; el informe marca como no comprobada cada prueba que necesitaba la red. La guía paso a paso está en Vectorscope para Claude. Por debajo, el agente ejecuta:
node dist/read.mjs https://example.com/page --out reading.json
# el agente lee los pasajes y escribe groups.json
node dist/lens.mjs reading.json groups.json --html report.html
# el agente escribe queries.json, style.json y plan.json
node dist/lens.mjs reading.json groups.json --queries queries.json \
  --style style.json --plan plan.json --html report.html --md report.md --json export.json

# comparar de 2 a 5 páginas
node dist/read.mjs <url1> <url2> --out-dir readings
Lo que no hace
- No es la canalización de ningún asistente. ChatGPT, Gemini, Perplexity y los demás no publican cómo cortan ni dónde se detienen sus rastreadores. La skill reproduce un recuperador típico, y el tope de 26 pasajes es el del propio Vectorscope. Hace medible «qué parte no alcanzaría nunca un recuperador con tope»; no afirma que ningún asistente corte en 26.
- Ni puntuación ni predicción. No clasifica la página ni dice lo que un asistente responderá sobre ti.
- Las partes de juicio son la lectura de un modelo. Grupos, veredictos, pasajes genéricos y plan los escribe el agente que ejecutó la skill. Los scripts comprueban las citas, pero otro modelo podría agrupar de forma algo distinta.
- Sin embeddings. La cohesión, la autosimilitud y el mapa necesitan vectores, y la skill los deja vacíos en lugar de estimarlos. El mapa de embeddings lo dibuja el Vectorscope web.
- Solo páginas públicas. Sin inicio de sesión, sin cookies, sin direcciones privadas.
Conclusión
Tres cosas hacen que valga la pena instalar esta skill, y cada una se ve en los archivos de ejemplo en lugar de prometerse.
Encuentra un lugar, no una puntuación. En Wikipedia no dijo «esta página es demasiado larga». Dijo que el tope se llena a mitad de Evaluation, que Limitations and challenges, Safety y Societal concerns no llegan a ningún pasaje y que, por eso, dos preguntas corrientes se quedan sin respuesta. Es un hallazgo que un editor resuelve en una tarde.
Cada arreglo es comprobable. Cada reescritura del plan cita el pasaje tal como está y da el pasaje como debería ser, y el script rechaza cualquier cita que no sea literal. No tienes que fiarte de la lectura del agente; puedes compararla.
Funciona donde están tus páginas. Sin cuenta, sin subir nada, sin llamadas a modelos desde los scripts, y nada se envía a GetLoopLoop. La misma página da los mismos pasajes en cualquier máquina. Una página que cabe en el tope, responde a sus preguntas con frases que se entienden solas y deja pasar a los rastreadores adecuados es una página que un asistente puede citar, y nuestra propia página muestra que llegar ahí es una lista corta.
Ejecútala en la página que más te importa. Si los ejemplos sirven de guía, el primer informe señalará algo concreto que arreglar y el segundo lo mostrará arreglado. Y cuando quieras saber lo que los asistentes dicen de verdad sobre ti, semana tras semana, eso es lo que mide GetLoopLoop.
Questions people ask
¿La skill Vectorscope es gratuita?
Sí. Es de código abierto con licencia MIT, funciona en tu propio agente y sus scripts no llaman a ningún modelo ni a ningún servicio de pago.
¿Envía mi página a GetLoopLoop?
No. Los scripts descargan la página y su robots.txt, hacen una consulta DNS y una petición RDAP para saber dónde está alojado el sitio, y escriben el informe en tu máquina. El informe HTML bloquea cualquier petición de red desde sí mismo.
¿Por qué 26 pasajes?
Es el tope de Vectorscope, una constante fija y con nombre, no una cifra que publique ningún asistente. Un tope conocido convierte la pregunta de qué parte de una página no alcanza nunca un recuperador con tope en algo que se puede medir.
¿En qué se diferencia del Vectorscope web?
La herramienta web agrupa los pasajes por sus embeddings y dibuja un mapa. La skill no llama a ningún servicio de embeddings: el agente lee los pasajes y los agrupa, y añade una prueba de preguntas, un plan de reescritura y una lectura de lo genérico que es el texto.
¿Puede comparar mi página con la de un competidor?
Sí. El modo comparación lee de 2 a 5 páginas y las pone en una tabla de temas comunes, con huecos de temas, huecos de datos y qué página responde a cada pregunta.
¿Qué agentes pueden ejecutarla?
Claude Code, Codex, opencode, Hermes Agent y otros agentes que cargan skills SKILL.md, además de claude.ai y la aplicación de escritorio de Claude con la ejecución de código activada.
El producto
Véalo en cada página, cada día
Una lectura dice dónde está una página hoy. El producto hace las mismas preguntas a los mismos asistentes de forma continua, así que un cambio es algo que se le cuenta y no algo que tenga que ir a buscar.
Pedir una invitaciónSolo por invitación mientras mantenemos honestas las lecturas
Sobre este tema
¿Está mi página lista para la búsqueda con IA?
Cada día Rastreos con la lectura de Vectorscope junto a cada página, comprobada de nuevo tras cada corrección. Cómo funciona el producto
Autor
Olexandrautor
Más de 15 años en marketing y SEO. Decenas de productos, sobre todo el mercado estadounidense. Investigación y medición.
LinkedInPass it on
Read in your language
Opens a browser translation of this English article. The original source stays in English.