

Ми просканували 190 SEO-сайтів: що вони кажуть AI-ботам і що роблять їхні сервери
Сканування GLLmolfar 190 SEO-видань, блогів інструментів та агенцій: хто блокує AI-краулери й чому, де robots.txt і сервер не погоджуються, у кого є llms.txt і як із технічною базою на 6442 сторінках.
Переклад з англійського оригіналу.
Коротка відповідь
- what
- Сканування їхніх robots.txt, llms.txt, відповідей сервера AI-краулерам і 6442 HTML-сторінок.
- why
- SEO-сайти задають поради, за якими йде решта вебу, тож їхні власні файли показують, як ці поради виглядають на практиці.
- who
- 190 сайтів, що пишуть про пошук: новинні видання, блоги SEO-інструментів, експерти, агенції та офіційні блоги пошукових систем.
- where
- Шість груп сайтів англійською, німецькою, французькою, іспанською, польською та українською.
- when
- Сканування 4 листопада 2026 року, через п'ять днів після того, як Google і Microsoft підтримали спільний токен проти AI-навчання.
- how
- Рушій сканування GLLmolfar із налаштуваннями за замовчуванням, 50 сторінок на сайт, robots.txt прочитано для 14 AI-краулерів.
Просте пояснення
Ми відправили робота на 190 сайтів, які пишуть про пошукові системи, і подивилися на таблички на їхніх дверях для AI-роботів. Більшість сайтів пускає AI-роботів. Ті небагато, що не пускають, здебільшого користуються табличкою, яку їм надрукував хостинг. Деякі сайти пишуть на табличці «заходьте», але двері все одно зачиняють. Приблизно третина залишає для AI окрему записку, llms.txt. Статті в них підписані добре, але на багатьох сторінках є дрібні вади, наприклад посилання, яке екранний читач не може назвати.
Сайти, що пишуть про пошук, — це ті, кого копіює решта вебу. Тож 4 листопада 2026 року ми направили GLLmolfar на 190 із них і подивилися, що вони віддають насправді: новинні видання на кшталт Search Engine Roundtable і PPC Land, блоги Ahrefs, Semrush, Moz і ще 62 виробників інструментів, експертів, агенції, власні пошукові блоги Google і Microsoft та SEO-сайти п'ятьма іншими мовами.
Для кожного сайту ми прочитали robots.txt для 14 AI-краулерів, яких відстежує застосунок, запросили llms.txt, запросили стартову сторінку як браузер і як чотири AI-краулери та просканували до 50 сторінок розділу новин чи блогу. HTML віддали 156 сайтів: це 6442 сторінки, з них 1643 статті зі 111 сайтів.
| Показник | Результат | База |
|---|---|---|
| Сайти зі спільним токеном __usage_ai-training | 0 | 157 файлів robots.txt |
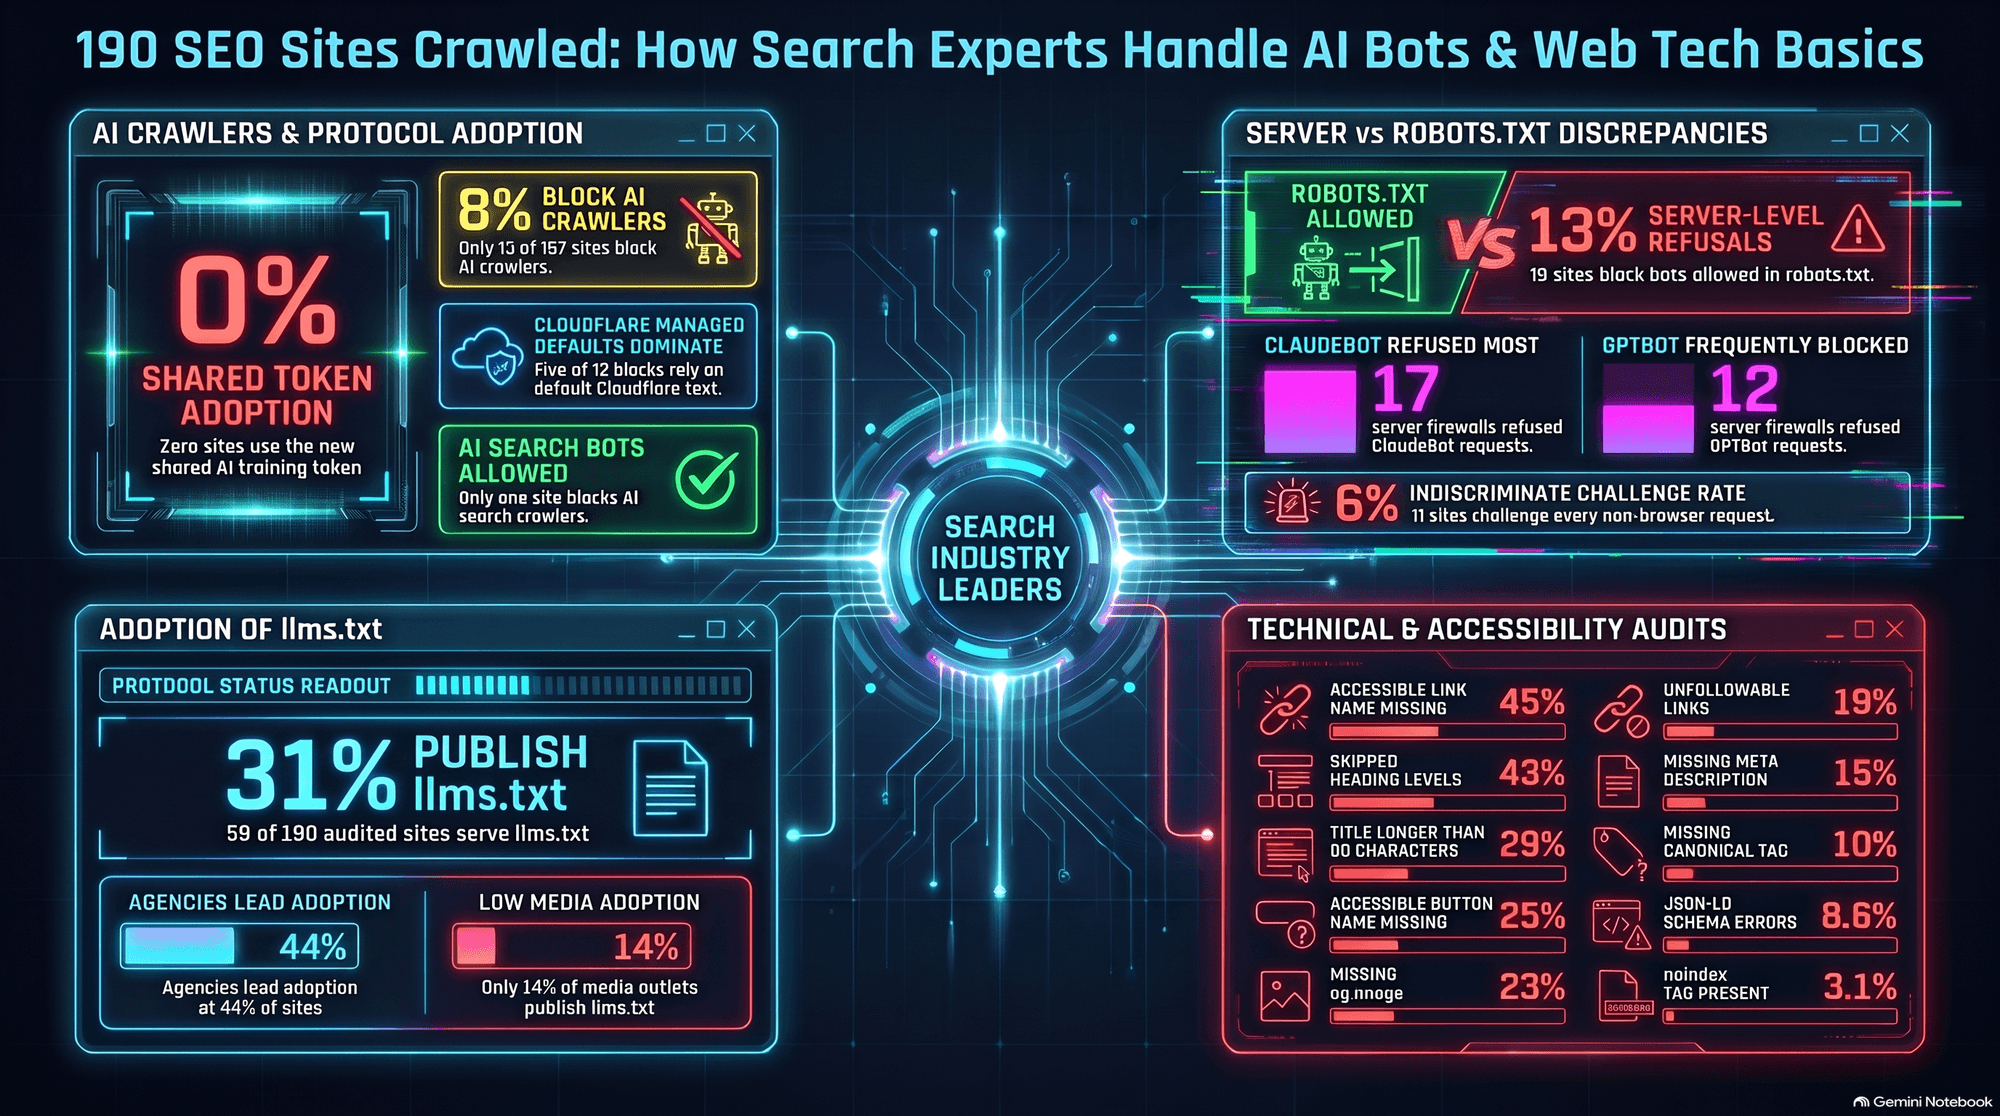
| Сайти, що блокують хоча б один AI-краулер у robots.txt | 13 (8%) | 157 |
| …з них із керованим robots.txt від Cloudflare | 5 | 13 |
| Сайти, що блокують AI-краулер для відповідей (OAI-SearchBot, PerplexityBot, Claude-SearchBot) | 1 | 157 |
| Сайти, що відмовляють AI-краулеру, якого дозволяє їхній robots.txt | 19 (13%) | 147, що відповіли браузеру |
| Сайти, що показують перевірку кожному запиту не з браузера | 11 (6%) | 190 |
| Сайти з llms.txt | 59 (31%) | 190 |
| Статті з типом Schema із сімейства Article | 94% | 1643 статті |
1. Через п'ять днів спільний токен проти навчання не використовує ніхто
30 жовтня Google і Microsoft підтримали спільний токен у robots.txt, яким сайт відмовляється від AI-навчання в усіх провайдерів одразу: група User-Agent: __usage_ai-training. 4 листопада його не було в жодному зі 157 файлів robots.txt, які ми змогли прочитати. Жодна головна сторінка не мала й нових значень Bing ai-training чи ai-grounding у мета-тегу robots.
Це не вирок токену — Google каже, що планує підтримати його у 2027 році, — але це корисна точка відліку. Якщо додати його зараз, ви будете попереду всіх SEO-видань, які ми переглянули.
Дванадцять сайтів уже користуються іншим механізмом: рядком Content-Signal, форматом, який просуває Cloudflare. П'ять із них мають керований текст Cloudflare слово в слово (search=yes, ai-train=no, use=reference). Три кажуть протилежне — ai-train=yes, ai-input=yes — і прямо запрошують AI. Три дозволяють AI-відповіді, але не навчання, а один забороняє і те, і те.
2. Більшість AI-блокувань — чиєсь налаштування за замовчуванням
Лише 13 зі 157 сайтів блокують хоч якийсь AI-краулер у robots.txt. Блокування зосереджені в одній групі: GPTBot блокують 7 із 22 маркетингових і медійних видань проти 1 із 57 виробників інструментів. П'ять із 13 файлів містять рядок # BEGIN Cloudflare Managed content і той самий список із восьми краулерів для навчання — GPTBot, ClaudeBot, Google-Extended, Applebot-Extended, CCBot, Bytespider, meta-externalagent і Amazonbot. Ці сайти не писали політику, вони її увімкнули.
Усі 11 сайтів, що блокують GPTBot, залишають відкритим OAI-SearchBot. Розподіл між навчанням і відповідями, про який сперечалися рік, тепер став звичною формою: лише один сайт у вибірці, WebmasterWorld, взагалі блокує AI-краулер для відповідей.
AI-краулери, заблоковані в robots.txt, сайтів зі 157
Спробуйте на власній сторінці
Подивіться, що Vectorscope знайде на вашій сторінці
Усе, що написано вище, можна зміряти на власній роботі, і перевірка займає близько хвилини. Вставте одну адресу і прочитайте, що повернеться.
Відкрити VectorscopeБезкоштовно · без акаунта · по одній за раз
Списки ще й застарілі. 15 файлів robots.txt називають anthropic-ai або Claude-Web, токени, яких немає в нинішній документації Anthropic про краулери; 13 із них називають і ClaudeBot. Лише 5 називають Claude-SearchBot і 6 — Claude-User, двох агентів, що забирають сторінки для відповідей Claude. Robots.txt, який одного разу скопіювали й більше не переглядали, каже «ні» краулерам, що вже не приходять, і нічого не каже тим, що приходять.
3. robots.txt каже «так», сервер каже «ні»
Потім ми запросили HTML кожної стартової сторінки ще чотири рази, з user agent GPTBot, ClaudeBot, PerplexityBot і OAI-SearchBot. Зі 147 сайтів, що відповіли браузеру, 19 (13%) відмовили хоча б одному AI-краулеру, якого дозволяє їхній власний robots.txt: 403, 429 «забагато запитів» на першому ж запиті або сторінка блокування Cloudflare. Найчастіше відмовляли ClaudeBot.
Стартову сторінку не віддали AI user agent, сайтів зі 147
Читайте це з одним застереженням. Наші запити несли імена краулерів, але йшли з нашої адреси, а не з опублікованих діапазонів IP цих краулерів, і деякі фаєрволи блокують саме таке: запит, що називає себе GPTBot, звідти, звідки GPTBot ніколи не ходить. Тож відмова тут не доводить, що відмовляють справжньому краулеру. Вона доводить інше: robots.txt — це не вся політика. Правила, які вирішують, чи отримає AI-краулер сторінку, часто живуть у фаєрволі чи CDN, яких аудит robots.txt не бачить, і перевірити їх можна лише в логах сервера.
4. Деякі SEO-сайти неможливо проаудитувати SEO-краулером
Одинадцять сайтів (6%) на кожен запит не зі справжнього браузера відповідали перевіркою Cloudflare — і на user agent нашого краулера, і на user agent браузера з простого HTTP-клієнта. Серед них Search Engine Land, Search Engine Watch, Neil Patel, WordStream, The Drum і Marketing Week. Ще два, Marketing Dive і Social Media Today, віддавали сторінку user agent браузера і показували перевірку user agent краулера.
Троє з одинадцяти публікують llms.txt для AI-систем, а один пише в robots.txt ai-train=yes, ai-input=yes. Запрошення написане на одному рівні й відкликане на наступному. Перевірені краулери Google, Bing і OpenAI можуть пройти перевірку; десктопний SEO-краулер, скрипт моніторингу чи менший AI-сервіс — ні.
5. llms.txt має кожен третій, і вони не схожі
llms.txt віддають 59 зі 190 сайтів (31%). Попереду агенції — 11 із 25 (44%), потім виробники інструментів — 26 із 65 (40%); із 29 медійних видань він є в чотирьох, а серед офіційних пошукових блогів — лише в Microsoft Advertising.
Файли розходяться в тому, навіщо llms.txt узагалі. Медіанний файл має 65 посилань, найменший — 4. Шість мають понад 500, а один — майже 5000: це карта сайту під іншою назвою, і вона руйнує формат, що мав указати моделі на кілька сторінок, які пояснюють сайт. Два сайти публікують llms.txt і водночас блокують краулери для навчання в robots.txt — це послідовна версія політики: відповідай за моїми сторінками, але не навчайся на них.
Сайти з llms.txt, % у кожній групі
6. Статті розмічені добре — крім Discover
На 1643 статтях, які знайшло сканування, сигнали довіри майже всюди: 94% мають тип Schema із сімейства Article, 95% називають автора, 88% описують автора як Person, 91% указують дату зміни. Медіанна стаття — 1978 слів, 7 заголовків H2 і 8 посилань на джерела; 57% мають хоча б один заголовок у формі питання.
Прогалина — у мета-тегу robots. Третина статей (33%) не має max-image-preview:large, налаштування, яке дозволяє Google Discover показати велике зображення. У новинних виданнях тип NewsArticle мають 126 зі 196 статей; решта використовує загальний Article.
7. База на 6442 сторінках
На всіх HTML-сторінках, які прочитало сканування, — статтях, категоріях, лендингах — знайомі вади нікуди не ділися, і найчастіші з них саме ті, що важать для допоміжних технологій.
| Перевірка | Частка сторінок |
|---|---|
| Посилання без доступної назви (без тексту, alt чи aria-label) | 45% |
| Пропущено рівень заголовка (H2, а потім H4) | 43% |
| Title довший за 60 символів | 29% |
| Кнопка без доступної назви | 25% |
| Немає og:image | 23% |
| Посилання, за якими пошуковики не ходять (javascript: або без href) | 19% |
| Немає meta description | 15% |
| Немає canonical | 10% |
| JSON-LD із помилкою | 8,6% |
| noindex | 3,1% |
Помилки JSON-LD зосереджені в трьох місцях: елементи хлібних крихт без position (180 сторінок), JSON-LD, який узагалі не розбирається (115 сторінок), і розмітка SoftwareApplication на сторінках інструментів без рейтингу чи відгуку (102 сторінки) — без них вона не дає розширеного результату, заради якого її додали.
Сторінки важкі, але швидкі. Медіанний HTML-документ важить 178 КБ ще до скриптів і зображень, а кожен десятий — понад 554 КБ; медіанний сервер відповів за 300 мс, кожен десятий — понад 1,3 секунди.
Що з цим робити
1. Вирішуйте окремо про навчання і про відповіді, для кожного краулера. Запишіть рішення в robots.txt, а якщо хочете спільний токен — додайте групу __usage_ai-training уже зараз. 2. Перевірте, що сервер погоджується з robots.txt. Пошукайте в логах GPTBot, ClaudeBot, Claude-SearchBot, OAI-SearchBot і PerplexityBot, а в CDN чи фаєрволі — відповіді 403 і 429 для них. 3. Приберіть старі токени. Замініть anthropic-ai і Claude-Web агентами, що існують сьогодні. 4. Якщо ви увімкнули керований robots.txt, прочитайте його. Це політика з вашим іменем. 5. Тримайте llms.txt коротким. Кілька посилань на сторінки, що пояснюють, чим ви займаєтеся, а не карта сайту. 6. Додайте `max-image-preview:large` до статей, якщо хочете трафік із Discover. 7. Дайте назву кожному посиланню й кнопці. Це найчастіша вада у вибірці й найдешевша у виправленні.
Як це виміряно і де межі
Список із 190 сайтів наш: новинні й галузеві видання, блоги SEO-інструментів, експерти, агенції, офіційні пошукові блоги та SEO-сайти німецькою, французькою, іспанською, польською й українською. 34 сайти не віддали HTML (перевірка, 404 за адресою, яку ми використали, або відсутність відповіді) і не входять у показники сторінок. Сканування брало до 50 сторінок розділу новин чи блогу, тож показники сторінок описують ці розділи, а не сайти цілком. JavaScript не виконувався; кількість слів — у HTML, як його віддає сервер. robots.txt прочитано для 14 AI-краулерів; запити з AI user agent зроблено один раз, з однієї адреси.
Усе це можна повторити в GLLmolfar: вигляд готовності до AI читає robots.txt для кожного AI-краулера й перевіряє llms.txt, а вигляд «Проблеми» показує перевірки сторінок, наведені вище, для будь-якого сайту, який ви просканували.
Питання про це дослідження
Чи блокують SEO-сайти AI-краулери?
Здебільшого ні. 13 зі 157 сайтів, чий robots.txt ми прочитали, блокують хоча б один AI-краулер, і майже всі ці блокування — для краулерів навчання. AI-краулер для відповідей блокує лише один сайт.
Чи хтось уже використовує спільний токен проти AI-навчання?
У цій вибірці — ні. 4 листопада 2026 року жоден зі 157 файлів robots.txt не мав групи User-Agent: __usage_ai-training, через п'ять днів після того, як її підтримали Google і Microsoft.
Чому сайт може відмовити краулеру, якого дозволяє його robots.txt?
Бо фаєрвол чи CDN можуть блокувати за user agent, адресою чи частотою ще до того, як хтось подивиться в robots.txt. 19 зі 147 сайтів відмовили AI user agent, якого дозволяє їхній robots.txt; частина цих відмов може стосуватися запитів, що лише видають себе за краулер.
Скільки SEO-сайтів мають llms.txt?
59 зі 190, тобто 31%. Попереду агенції та виробники інструментів; у медіа й офіційних пошукових блогах його здебільшого немає. Медіанний файл має 65 посилань.
Яка технічна вада найчастіша на SEO-сайтах?
Посилання без доступної назви — на 45% із 6442 просканованих сторінок, далі пропущені рівні заголовків — на 43%.
Продукт
Стежте за кожною сторінкою щодня
Одне зчитування каже, де сторінка стоїть сьогодні. Продукт ставить ті самі питання тим самим асистентам постійно — тож про зміну вам повідомляють, а не ви йдете її шукати.
Попросити запрошенняЗа запрошеннями, поки ми тримаємо зчитування чесними
На цю тему
Чи згадують нас ШІ-асистенти?
- Читати
- AI-асистенти в жовтні 2026: запитання розійшлися, кліки — ніТиждень, коли Google прибрав вихід
- Перевірити
- VoicescopeЯкі моделі використовують
Щодня Ті самі запитання справжнім асистентам за розкладом, кожна відповідь — у сховищі доказів. Як працює продукт
Автор
Olexandrавтор
15+ років у маркетингу та SEO. Десятки продуктів, переважно американський ринок. Дослідження і заміри.
LinkedInPass it on
Read in your language
Opens a browser translation of this English article. The original source stays in English.