01 Що відбувається зі сторінкою, перш ніж AI-асистент зможе її процитувати
Перш ніж AI-асистент процитує сторінку, машина мусить її завантажити, звести до тексту, порізати текст на уривки й частину з них зберегти; потім асистент шукає уривки, а не сторінки. Саме так виглядала генерація з доповненням пошуком, коли її назвали у 2020 році: ретривер знаходить уривки в індексі, а генератор пише на їхній основі [16]. В оригінальній статті Вікіпедію поділили на уривки по 100 слів ще до індексації [16].
Завантажують сторінки іменовані краулери, які публікують своє призначення. OpenAI відділяє бота, що збирає дані для навчання, від бота, що знаходить сторінки для пошуку в ChatGPT, і від того, що відкриває сторінку на прохання користувача [9]; Anthropic і Perplexity розрізняють своїх ботів так само [10] [11]. Google пише, що для появи в його AI-функціях сторінка має бути в індексі й придатна до показу зі сніпетом [1], а Bing — що Copilot спирається на те саме сканування й індексацію, що і його пошук [14].
Краулер зберігає текст. Googlebot виконує JavaScript на пізнішому етапі [7], але коли Vercel у грудні 2024 року виміряв трафік у власній мережі, основні AI-краулери завантажували файли JavaScript і не виконували їх [8], а Common Crawl пише, що його CCBot теж не виконує JavaScript [12]. Слова, які з'являються лише після виконання скрипту, для цих краулерів не існують.
- Завантаження Один GET-запит HTML, як у краулера. Скрипти не виконуються.
- Текст Меню, футери й розмітку прибрано; лишається текст для читання.
- Уривки Розріз на кожному h2, далі вікна приблизно по 2000 символів.
- Ліміт Зберігається щонайбільше 26 уривків. Решта не зберігається ніколи.
- Пошук Запитання зіставляють з уривками, а не зі сторінкою.
Розріз і ліміт у 26 уривків — правила нашого безкоштовного Vectorscope і цього скіла. Жоден асистент не публікує власного ліміту уривків; 26 — робоча модель ліміту, а не число, взяте в когось із них.
02 Чому кожен уривок мусить бути зрозумілим окремо
Уривок, якому для сенсу потрібен попередній, не можна процитувати, бо ретривер передає його самого. Anthropic, описуючи контекстний пошук, називає саме цю ваду: коли документ ділять на фрагменти, окремий фрагмент може втратити контекст, який пояснював, про що він [18]. Посібник Pinecone формулює те саме правило з іншого боку: якщо фрагмент зрозумілий людині без тексту довкола, він буде зрозумілий і моделі [19].
Він також працює без мережі. Ціна на це починається з другого тарифу, і це можна вимкнути для проєкту.
Чи працює редактор без мережі? Так, настільний редактор працює без мережі. Офлайн-режим входить у тариф від другого й вимикається для кожного проєкту.
Позиція важить і після пошуку. Лю та співавтори з'ясували, що мовні моделі часто найкраще використовують інформацію на початку або в кінці довгого контексту й помітно гірше — посередині [17]. Сторінка не вибирає, куди асистент поставить її уривок; вона може подбати, щоб уривок мав власну тему й будь-де лишався зрозумілим.
Більшість конвеєрів ріже спершу за розміром. Типове налаштування в інструментах RAG — фіксований розмір фрагмента з перекриттям і поділ за абзацами та рядками, де це можливо [20]. Вікно, вирізане так, не знає, де закінчується ваша відповідь.
Одне чесне застереження щодо Google. Google пише, що Google Пошуку не потрібно, щоб зміст ділили на дрібні шматки, бо його системи самі знаходять потрібну частину сторінки [2]. Скіл Claude Code для AI-пошуку не змінить того, як Google ранжує сторінку, і цей не намагається. Він про ретривери, які зберігають уривки, — конвеєри RAG і крок пошуку в асистенті, — і Bing, наприклад, пише, що URL частіше обирають для ґрунтування й цитування, коли його зміст зрозумілий окремо [14].
03 Що робить скіл, крок за кроком
Скіл — це тека з файлом інструкцій SKILL.md, яку завантажує агент. Claude Code знаходить скіли в особистій і проєктній теках, застосовує скіл, коли він доречний, і дає викликати його за назвою, тут — /vectorscope [21]; інші агенти завантажують ту саму теку зі своїх тек скілів, перелічених нижче. Як скіл Claude Code для AI-пошуку, Vectorscope ділить роботу між двома скриптами з фіксованими правилами й кроками, які є судженням агента, — їх робить модель, на якій працює ваш агент; у Claude Code це Claude.
-
Прочитати сторінку
dist/read.mjsзавантажує URL одним звичайним GET-запитом і читає robots.txt сайту, відмовляє приватним і локальним адресам, видобуває видимий текст, ріже його на кожному h2, а далі на вікна приблизно по 2000 символів із перекриттям 200, застосовує ліміт у 26 уривків і позначає уривки, схожі на супутні посилання чи дрібний шрифт. З--renderвін ще відкриває сторінку в локальному Chrome, Chromium чи Edge з одноразовим профілем і повідомляє, скільки слів з'являється лише після виконання JavaScript; саме прочитання лишається звичайним завантаженням. -
Згрупувати уривки
Агент читає кожен уривок повністю й записує
groups.json: щонайбільше шість груп за темою, кожна з назвою мовою сторінки. Це судження — веб-інструмент групує за ембедингами, скіл читанням, — і наступний скрипт відмовляє групуванню, яке пропускає уривок або рахує його двічі. -
Написати звіт
dist/lens.mjsперевіряє групування, запускає всі перевірки й записує самодостатній HTML-звіт, Markdown і JSON; звіт завжди показують, а не лише називають. Кожен розділ і кожне число мають позначку — виміряно парсером, обчислено за сталою формулою або судження агента, — а «?» біля числа відкриває його формулу, одиницю, поріг і обмеження. Інформаційна панель угорі пояснює позначки й називає модель, що оцінювала. Перемикач EN | UK, дві теми й політика безпеки вмісту, що блокує будь-які мережеві запити. -
Показати, куди дівається текст
Каскад символів простежує сторінку від сирого HTML до уривків: що прибрав очищувач, що лишилося, що потрапило в уривки, що за лімітом. Таблиця показує, що очищувач прибрав і чому — елемент, його CSS-шлях, символи, початок тексту, — а мапа розділів показує, скільки з кожного h2 дійшло до уривка. Символи за лімітом рахуються від унікального тексту в уривках: 55 001 для прикладу з Вікіпедією, тоді як віднімання всіх збережених символів разом із перекриттями й вступом дає 52 973.
Звіт також показує власну лексику сторінки, спершу фрази: два–чотири слова, які сторінка пише разом щонайменше у двох уривках, потім окремі слова розповіді, яких ще не використала жодна фраза. Це те, що каже сторінка, а не пошуковий попит; як люди питають, показує тест запитами.
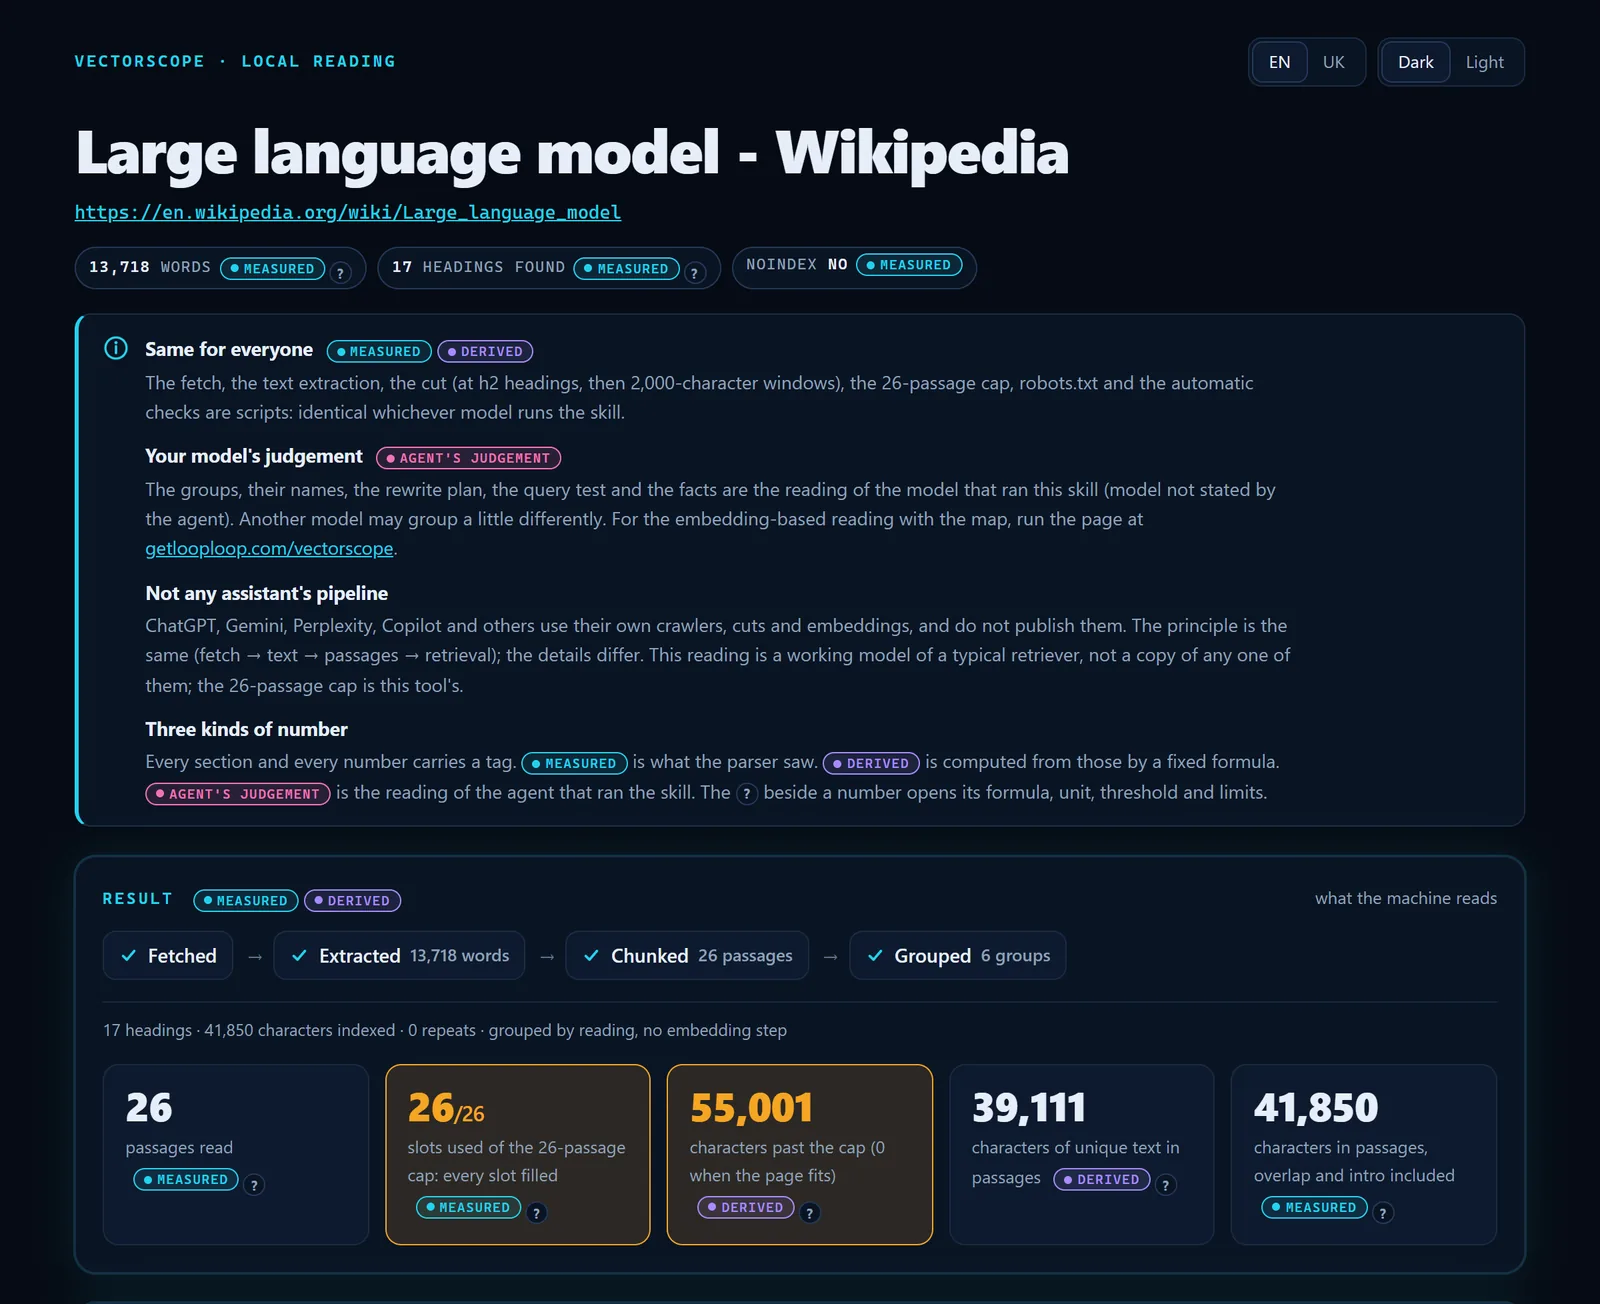
- Позначка біля кожного числа: виміряно, обчислено чи судження агента.
- Інформаційна панель пояснює кожну позначку.
- 55 001 символ за лімітом, порахований від унікального тексту.
- Унікальний текст в уривках поруч із сумою з перекриттями й вступом.
- «?» відкриває, як обчислено число.
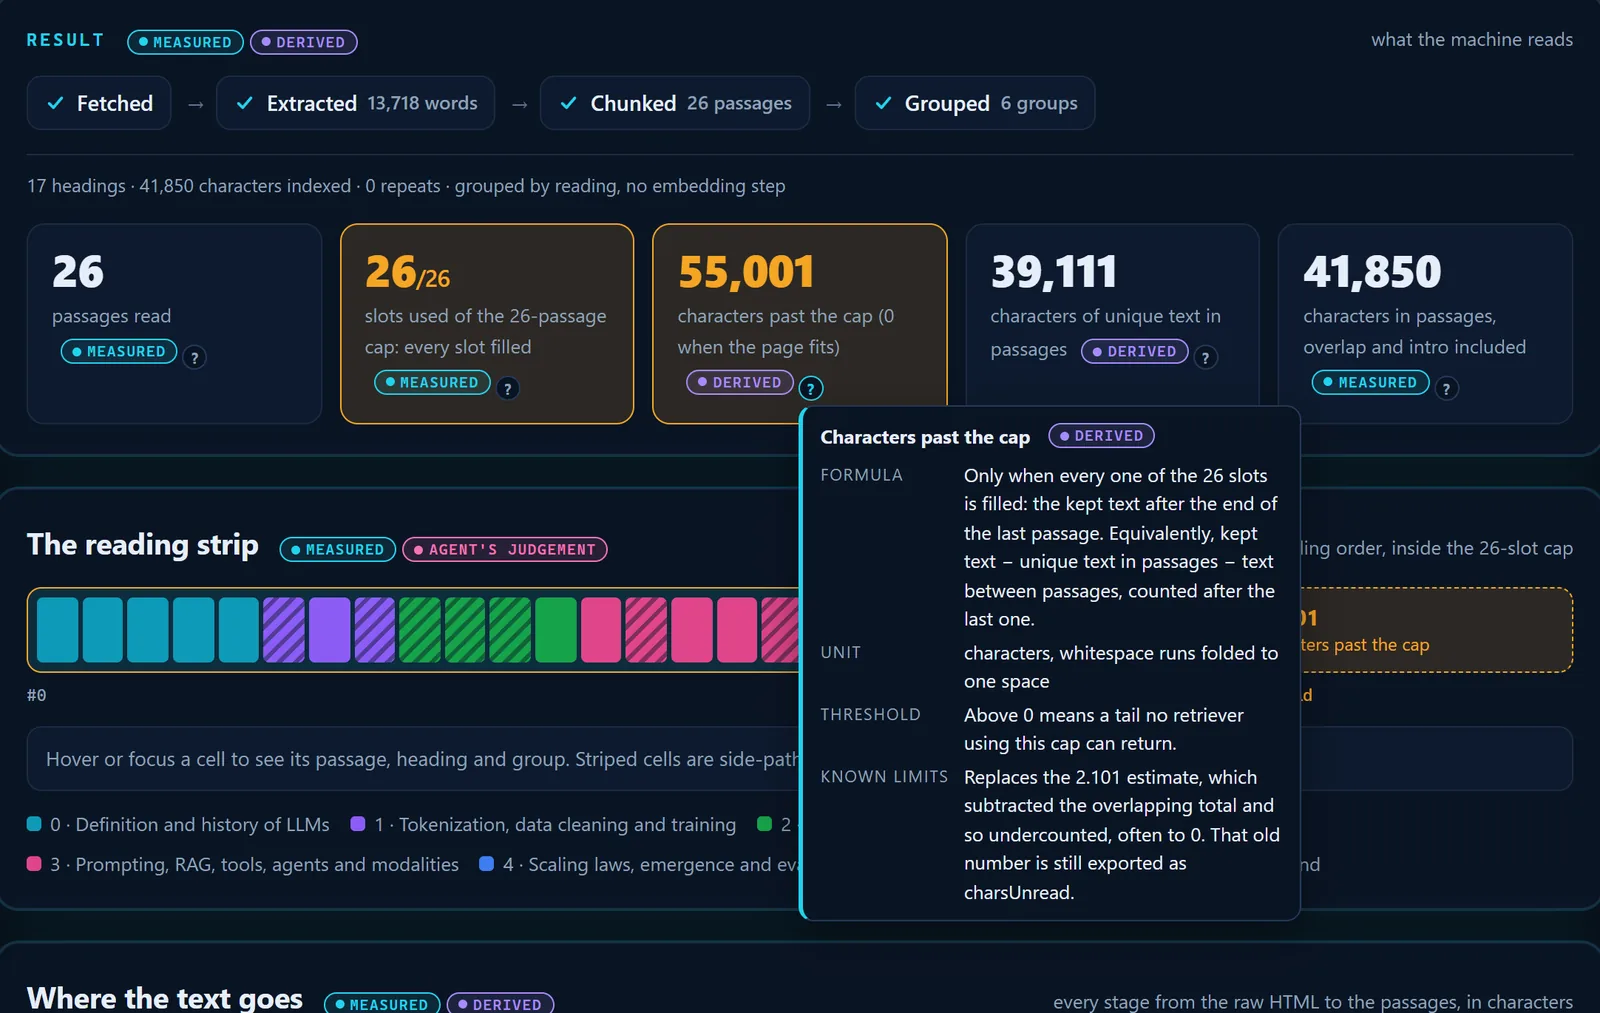
- «?» біля числа.
- Формула, словами.
- Відомі обмеження, зокрема що робив старий підрахунок.
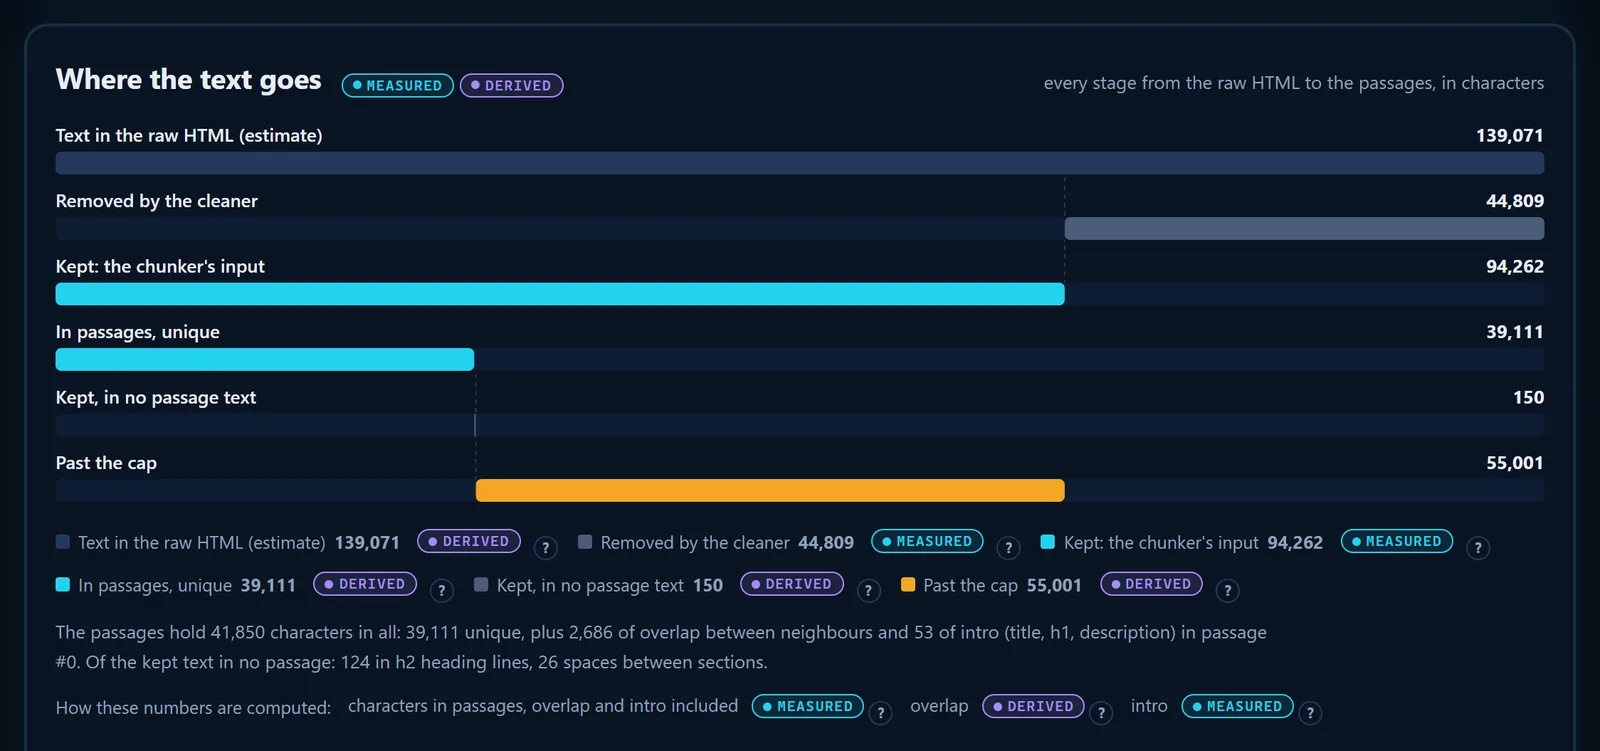
- Що прибрав очищувач: скрипти, стилі, навігацію.
- Унікальний текст, що дійшов до уривка.
- За лімітом: лишене, але без уривка.
- Сума уривків, поділена на унікальне, перекриття й вступ.
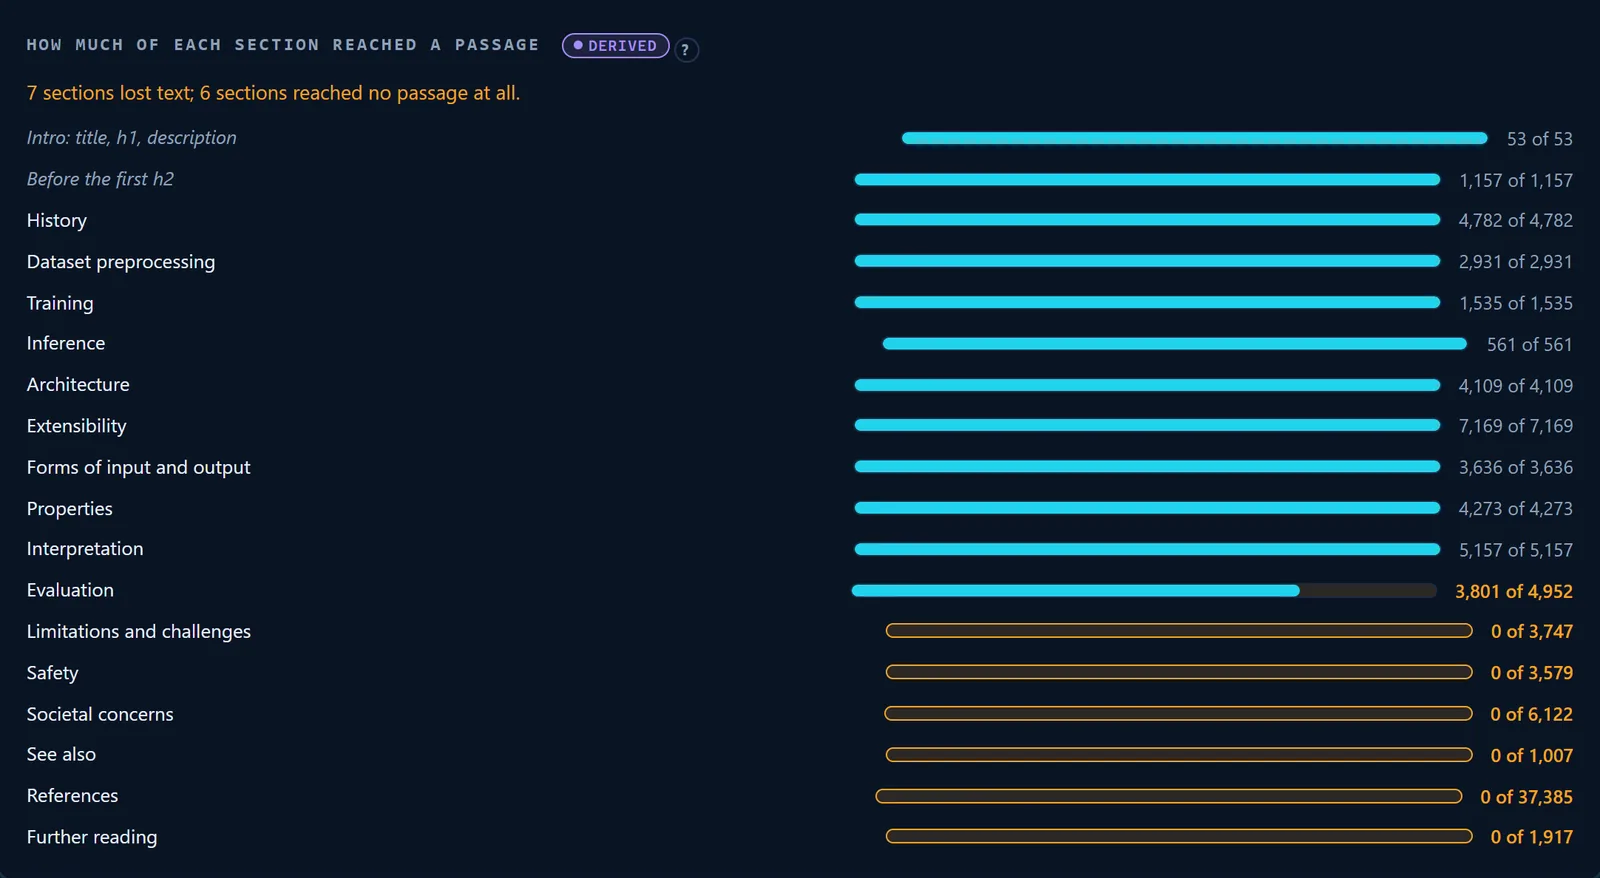
- Розділи, що втратили текст, і ті, що не дійшли зовсім.
- Розділ, який ліміт обрізав посередині.
- Розділи за лімітом: збережено 0 символів.
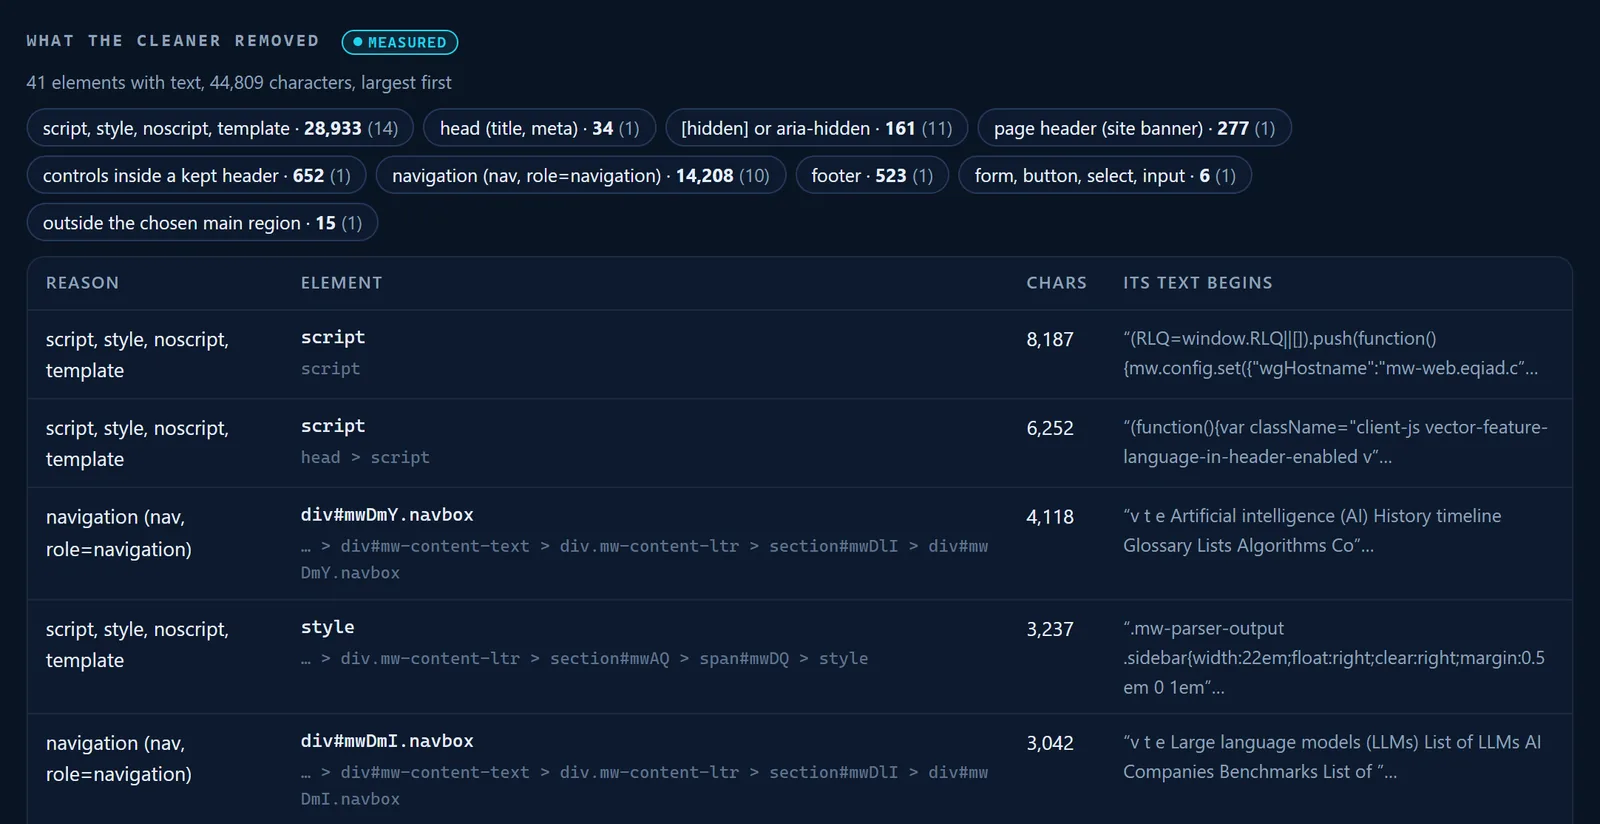
- Прибрані символи за причиною.
- Елемент і його CSS-шлях.
- Його символи й початок тексту.
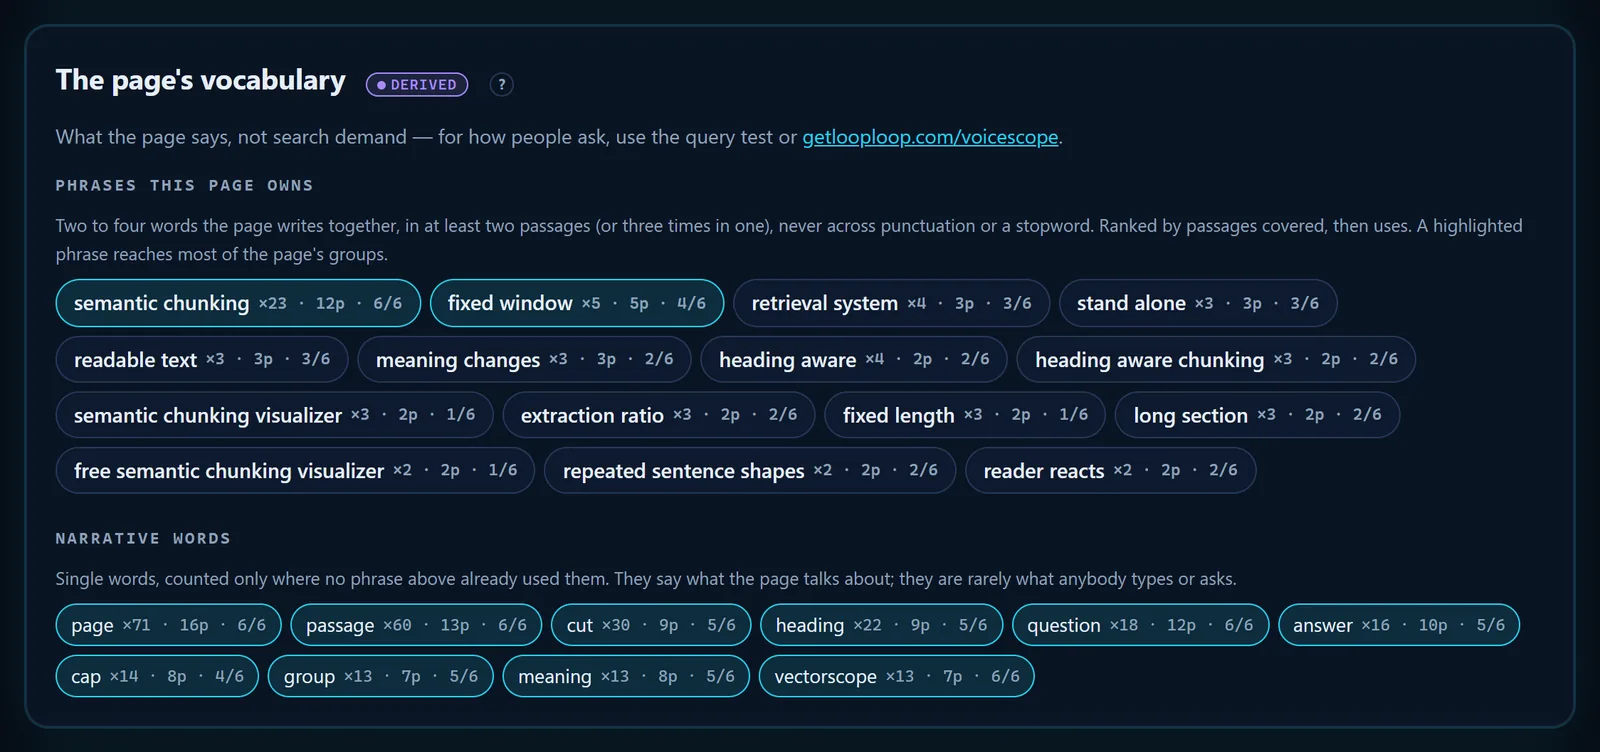
- Обчислено: пораховано за сталим правилом, а не оцінено.
- Те, що каже сторінка, а не пошуковий попит.
- Фраза сторінки: вживання, уривки, охоплені групи.
- Слова розповіді: окремі слова, яких не використала жодна фраза.
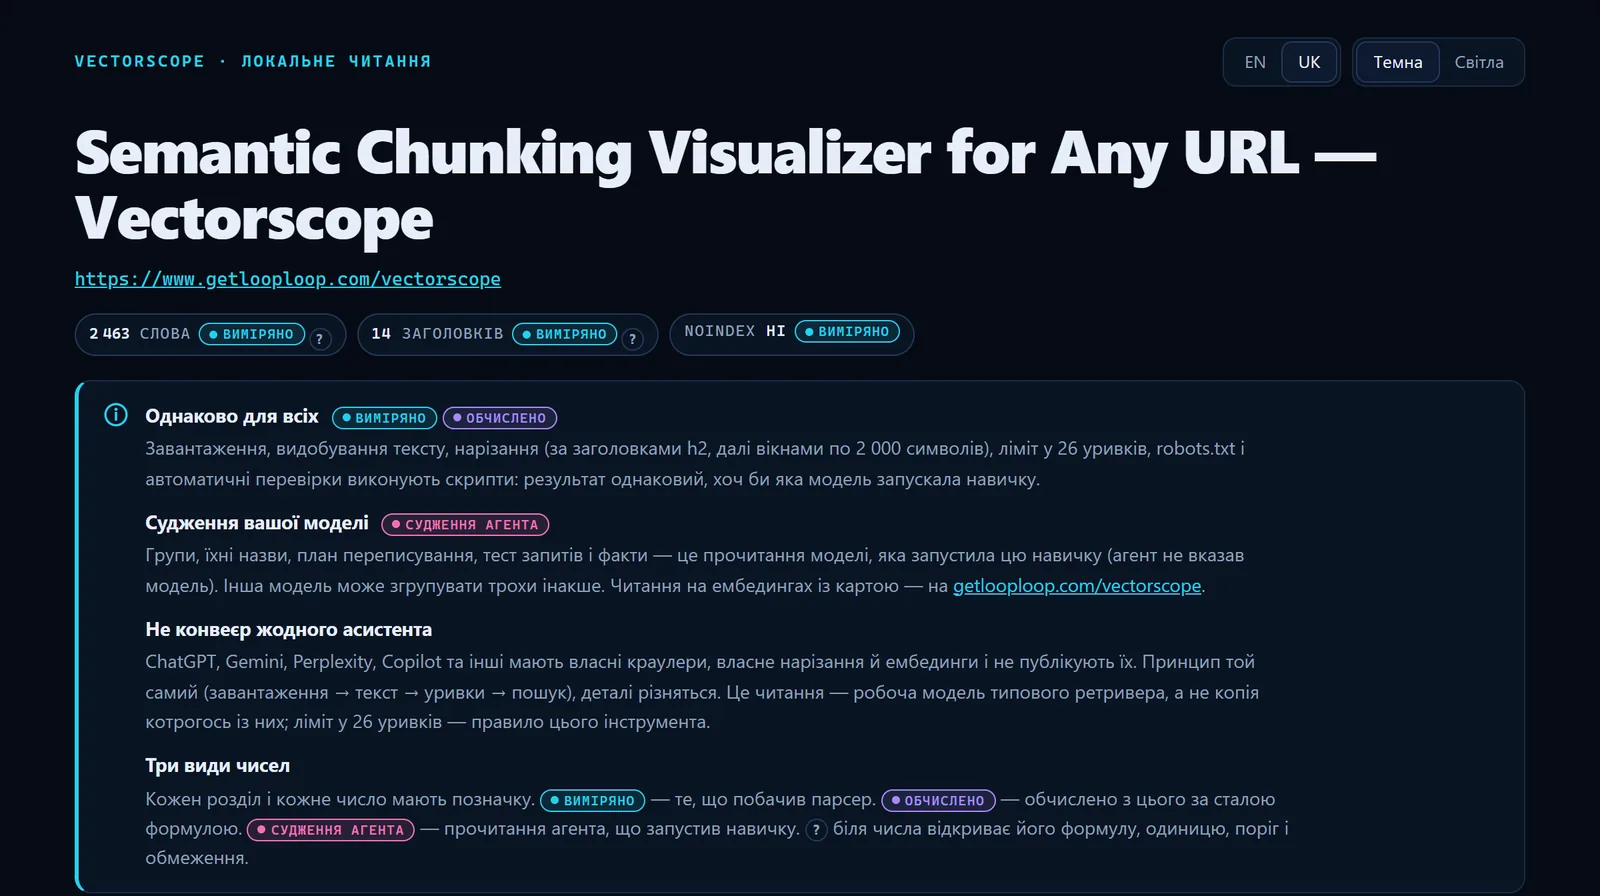
- Перемикач мови інтерфейсу.
- Позначки й пояснення — українською.
- Власна назва сторінки ніколи не перекладається.
04 Автоматичні перевірки і чому кожна важлива
Після прочитання скіл Claude Code для AI-пошуку запускає перевірки без жодного судження: кожна знахідка має код, рівень важливості, уривки, на яких вона ґрунтується, і докази, а кожен поріг — іменована константа в коді скіла. Звіт упорядковує їх за важливістю, і першим іде доступ краулерів, бо заблокований краулер робить решту неважливою.
-
Краулери, що відповідають людям, заблоковані в robots.txt
ai_search_blockedСкіл читає /robots.txt на домені сторінки й зіставляє його так, як описує RFC 9309, для дванадцяти краулерів. Якщо пошуковому краулеру чи краулеру на запит користувача — OAI-SearchBot, ChatGPT-User, Claude-SearchBot, Claude-User, PerplexityBot, Perplexity-User, Googlebot або Bingbot — заборонено доступ, звіт каже про це раніше за все інше; порада самого Google для його AI-функцій починається з того, щоб краулер не був заблокований [5]. robots.txt — прохання, якого краулерів просять дотримуватися, а не контроль доступу [13], і кожен оператор документує власних агентів [9] [10] [11]; запити від імені одного користувача — окремий випадок: OpenAI пише, що правила robots.txt можуть не застосовуватися до ChatGPT-User, а Perplexity — що Perplexity-User зазвичай їх ігнорує. robots.txt, що відповідає 5xx або не відповідає взагалі, позначається як
robots_unreachable. -
Заблоковано лише краулери для навчання
ai_training_blockedЗаборона для GPTBot, ClaudeBot, Google-Extended чи CCBot зазвичай навмисна й не заважає асистентові цитувати сторінку сьогодні, тож це знахідка низької важливості. Google пише, що Google-Extended не впливає на присутність у Google Пошуку [4], а robots.txt керує скануванням, а не тим, чи з'явиться сторінка в результатах [3]; CCBot від Common Crawl спершу читає robots.txt [12].
-
Сторінка просить не індексувати її
noindexMeta robots noindex означає, що пошукові індекси, з яких відповідають асистенти, відкинуть сторінку. AI-функції Google показують лише сторінки, що є в індексі й придатні до сніпета [1].
-
Текст, що існує лише після JavaScript
js_dependentЗ
--renderпозначається сторінка, де JavaScript додає 50% слів або більше (і щонайменше 150). Коли Vercel у грудні 2024 року виміряв трафік у своїй мережі, основні AI-краулери завантажували файли JavaScript і не виконували їх [8], тож вони читають менше число. -
Текст за лімітом у 26 уривків
cap_overflowУсі 26 слотів зайняті, а текст ще лишається. Те, що йде після 26-го уривка, цей конвеєр ніколи не зберігає, тож жодне запитання його не поверне. Ліміт наш, а не якогось асистента.
-
Відповіді FAQ, що втратили свої запитання
lost_faq_questionsТри чи більше речень починаються з «Так.» або «Ні.», а знаків питання на сторінці менше за половину від них: запитання були в кнопках чи акордеонах, які не пережили видобування, і кожна відповідь втратила свою адресу. Google прибрав розширені результати FAQ у травні 2026 року [6], тож справа ніколи не була в розмітці — справа в тексті.
-
Один заголовок тримає понад 30% тексту
dominant_headingЧанкер ділить лише на h2, тож такий великий розділ ріжеться тільки за довжиною; його підзаголовки — h3 або стилізований текст, і жоден із них не робить розрізу.
-
Уривки, що починаються посеред речення
mid_sentence_startУривок, що починається з малої літери чи розділового знака, розрізало вікно у 2000 символів. Він починається без свого підмета — та сама вада, що описана в розділі про окремі уривки [18].
-
Навігація всередині змісту
nav_in_contentЧотири чи більше рядків поспіль з одного-двох слів в основному тексті: меню, списки тегів чи таблиці підписів стали текстом уривків і забрали уривки. Google радить, щоб важливий зміст був доступний як текст [1]; оформлення, що читається як текст, витрачається як зміст.
-
Тонкі розділи
thin_sectionЗаголовок, під яким менше 150 символів, затонкий, щоб сам по собі на щось відповісти.
-
Обрізані анонси
truncated_teaserРядки, що закінчуються на «…» або «...» (крім зразків коду), дають ретриверу пів твердження; три чи більше таких рядків підвищують важливість до середньої.
-
Те саме твердження в кожному розділі
repeated_claimТа сама фраза з чотирьох слів — з граматикою, а не код — щонайменше в половині груп. Повтори витрачають уривки на вже сказане.
Далі розмітка: canonical, якого немає, відносний, подвоєний або такий, що вказує на інший URL; JSON-LD, що не розбирається або відсутній; і meta description, якого немає, коротший за 70 чи довший за 160 символів, бо чанкер кладе опис в уривок #0.
Спершу robots.txt: які AI-краулери можуть читати сторінку
Таблиця — вердикт robots.txt зі справжнього запуску скіла на сторінці самого веб-Vectorscope: дванадцять краулерів, кожен із правилом, яке вирішило. На цій сторінці дозволено всіх.
| Краулер | Компанія | Для чого | Ця сторінка | Вирішальне правило |
|---|---|---|---|---|
OAI-SearchBot | OpenAI | відповіді пошуку | дозволено | Allow: /vectorscope |
ChatGPT-User | OpenAI | запит на прохання користувача компанія пише, що robots.txt може до нього не застосовуватися | дозволено | Allow: /vectorscope |
GPTBot | OpenAI | дані для навчання | дозволено | Allow: /vectorscope |
Claude-SearchBot | Anthropic | відповіді пошуку | дозволено | Allow: /vectorscope |
Claude-User | Anthropic | запит на прохання користувача | дозволено | Allow: /vectorscope |
ClaudeBot | Anthropic | дані для навчання | дозволено | Allow: /vectorscope |
PerplexityBot | Perplexity | відповіді пошуку | дозволено | Allow: /vectorscope |
Perplexity-User | Perplexity | запит на прохання користувача компанія пише, що robots.txt може до нього не застосовуватися | дозволено | Allow: /vectorscope |
Google-Extended | навчання й ґрунтування Gemini | дозволено | Allow: /vectorscope | |
Googlebot | пошуковий індекс, з якого відповідають асистенти | дозволено | Allow: /vectorscope | |
Bingbot | Microsoft | пошуковий індекс, з якого відповідають асистенти | дозволено | Allow: /vectorscope |
CCBot | Common Crawl | відкритий веб-корпус | дозволено | Allow: /vectorscope |
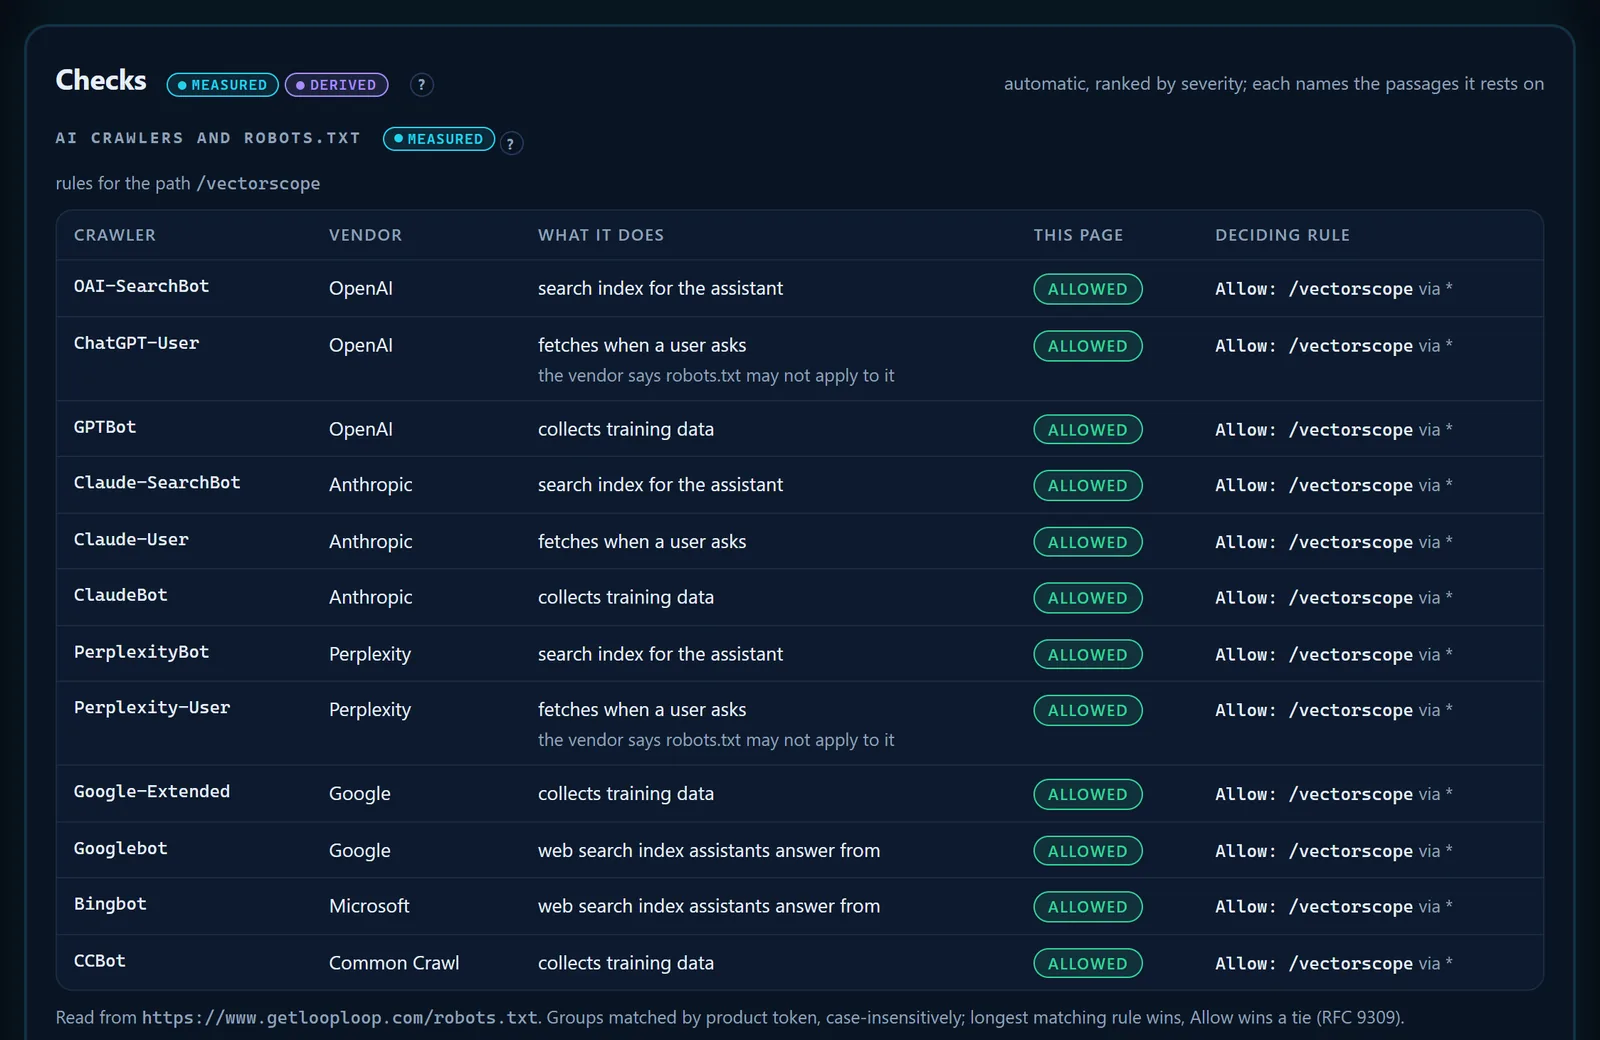
- Краулери на запит користувача мають застереження самої компанії щодо robots.txt.
- Вердикт для шляху цієї сторінки.
- Правило, що вирішило, і група, з якої воно взялося.
- Звідки прочитано файл і за якими правилами зіставлено (RFC 9309).
05 Від прочитання до переписування: тест запитами, план, порівняння, до і після
Прочитання каже, що не так; решта можливостей, які дає скіл Claude Code для AI-пошуку, допомагає виправити це й показує, чи виправлення спрацювало. Тест запитами й план — судження агента, і скрипт перевіряє обидва: цитату треба скопіювати дослівно з уривка, на який вона посилається, інакше запуск відхиляється з назвою пункту.
Тест запитами
Агент пише від 5 до 10 типових запитів — ваших, якщо ви їх дали, а інакше тих, які людина набрала б в асистенті, і щонайменше один, на який сторінка, імовірно, не відповідає. Для кожного він називає один уривок, який мав би повернути ретривер, вердикт (повна, часткова чи жодна відповідь), чи слова зрозумілі в цитаті окремо, і точні слова, що відповідають.
План переписування
Виправлення в порядку пріоритету, кожне прив'язане до коду перевірки й уривків, на яких ґрунтується, з переписуванням «було → стало» для найслабших уривків. Порядок іде за тим, що найбільше змінює пошук: заблоковані краулери й noindex, потім текст за лімітом, потім уривки, що втратили запитання чи тему, потім тонкі або роздроблені розділи, потім розмітка. Переписування не може додати твердження, якого сторінка не робить.
Режим порівняння
Прочитайте від 2 до 5 сторінок за один запуск. Агент спершу пише один спільний словник тем, щоб групи збігалися між сторінками; звіт показує таблицю «теми × сторінки», прогалини в темах (теми, які інші сторінки охоплюють, а ця ні), прогалини у фактах (факти, які називає лише одна сторінка) і хто виграє кожен запит. Скіл порівнює сторінки, які ви назвали, і має вказівку не пропонувати сам порівняння зі сторінкою названої компанії.
До і після
Збережіть старе прочитання. Після зміни сторінки прочитайте її знову й передайте звіту --baseline old-reading.json, а якщо зберегли старе групування, то й --baseline-groups: він покаже, які уривки не змінилися, змінилися, додалися й зникли, стан ліміту до і тепер, і з яких старих груп узялися нові. Після справжньої зміни IndexNow може повідомити пошуковим системам-учасникам, що URL змінився [15].
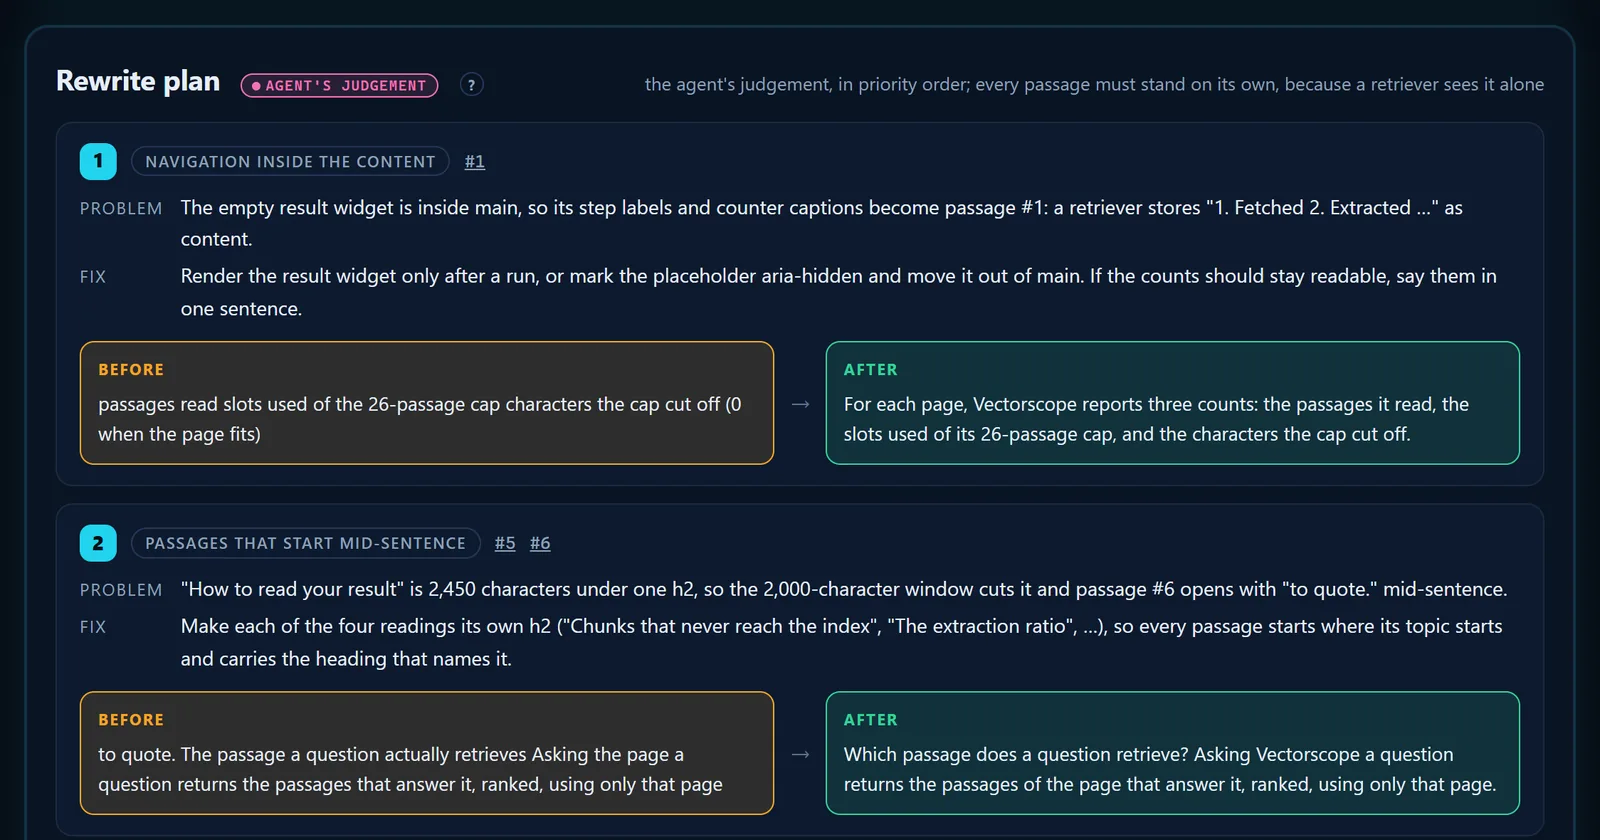
- Позначено як судження агента.
- Перевірка, на яку відповідає пункт, і його уривки.
- Було: текст уривка, скопійований дослівно.
- Стало: переписаний текст, що називає свою тему й зрозумілий окремо.
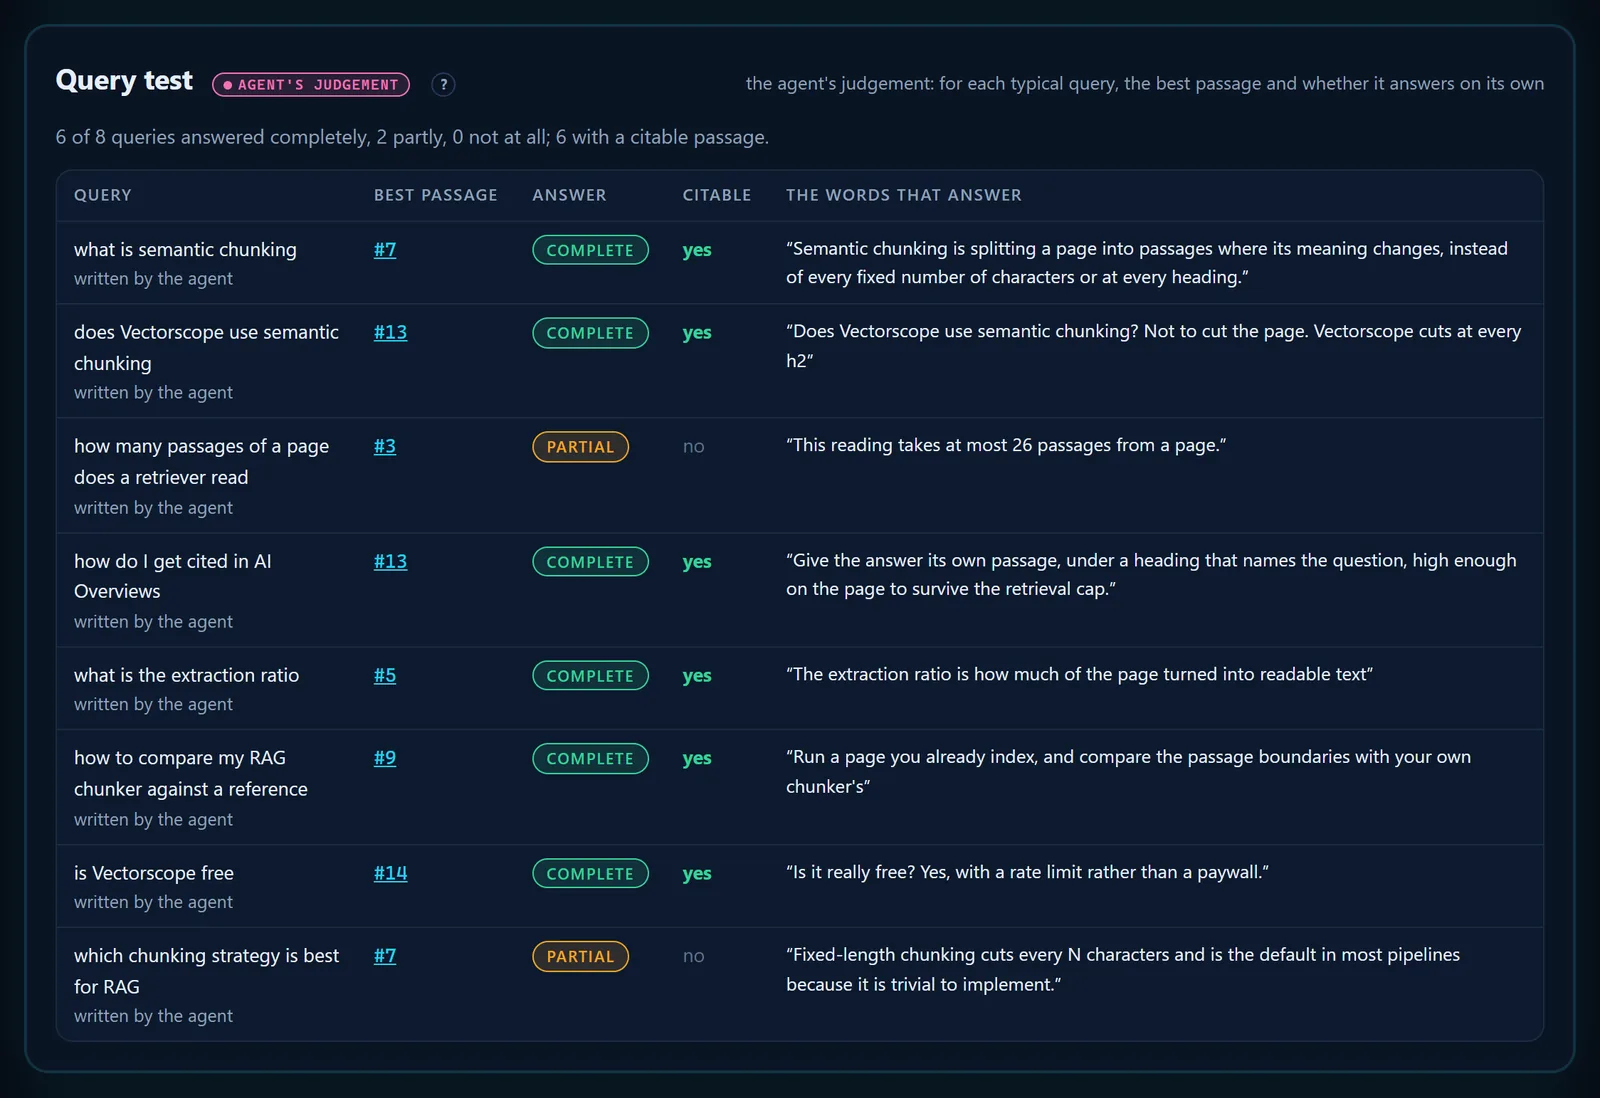
- Позначено як судження агента.
- Підсумок: скільки відповідей повних, часткових, відсутніх і придатних до цитування.
- Вердикт: повна, часткова чи жодна відповідь.
- Точні слова, що відповідають, перевірені за уривком.
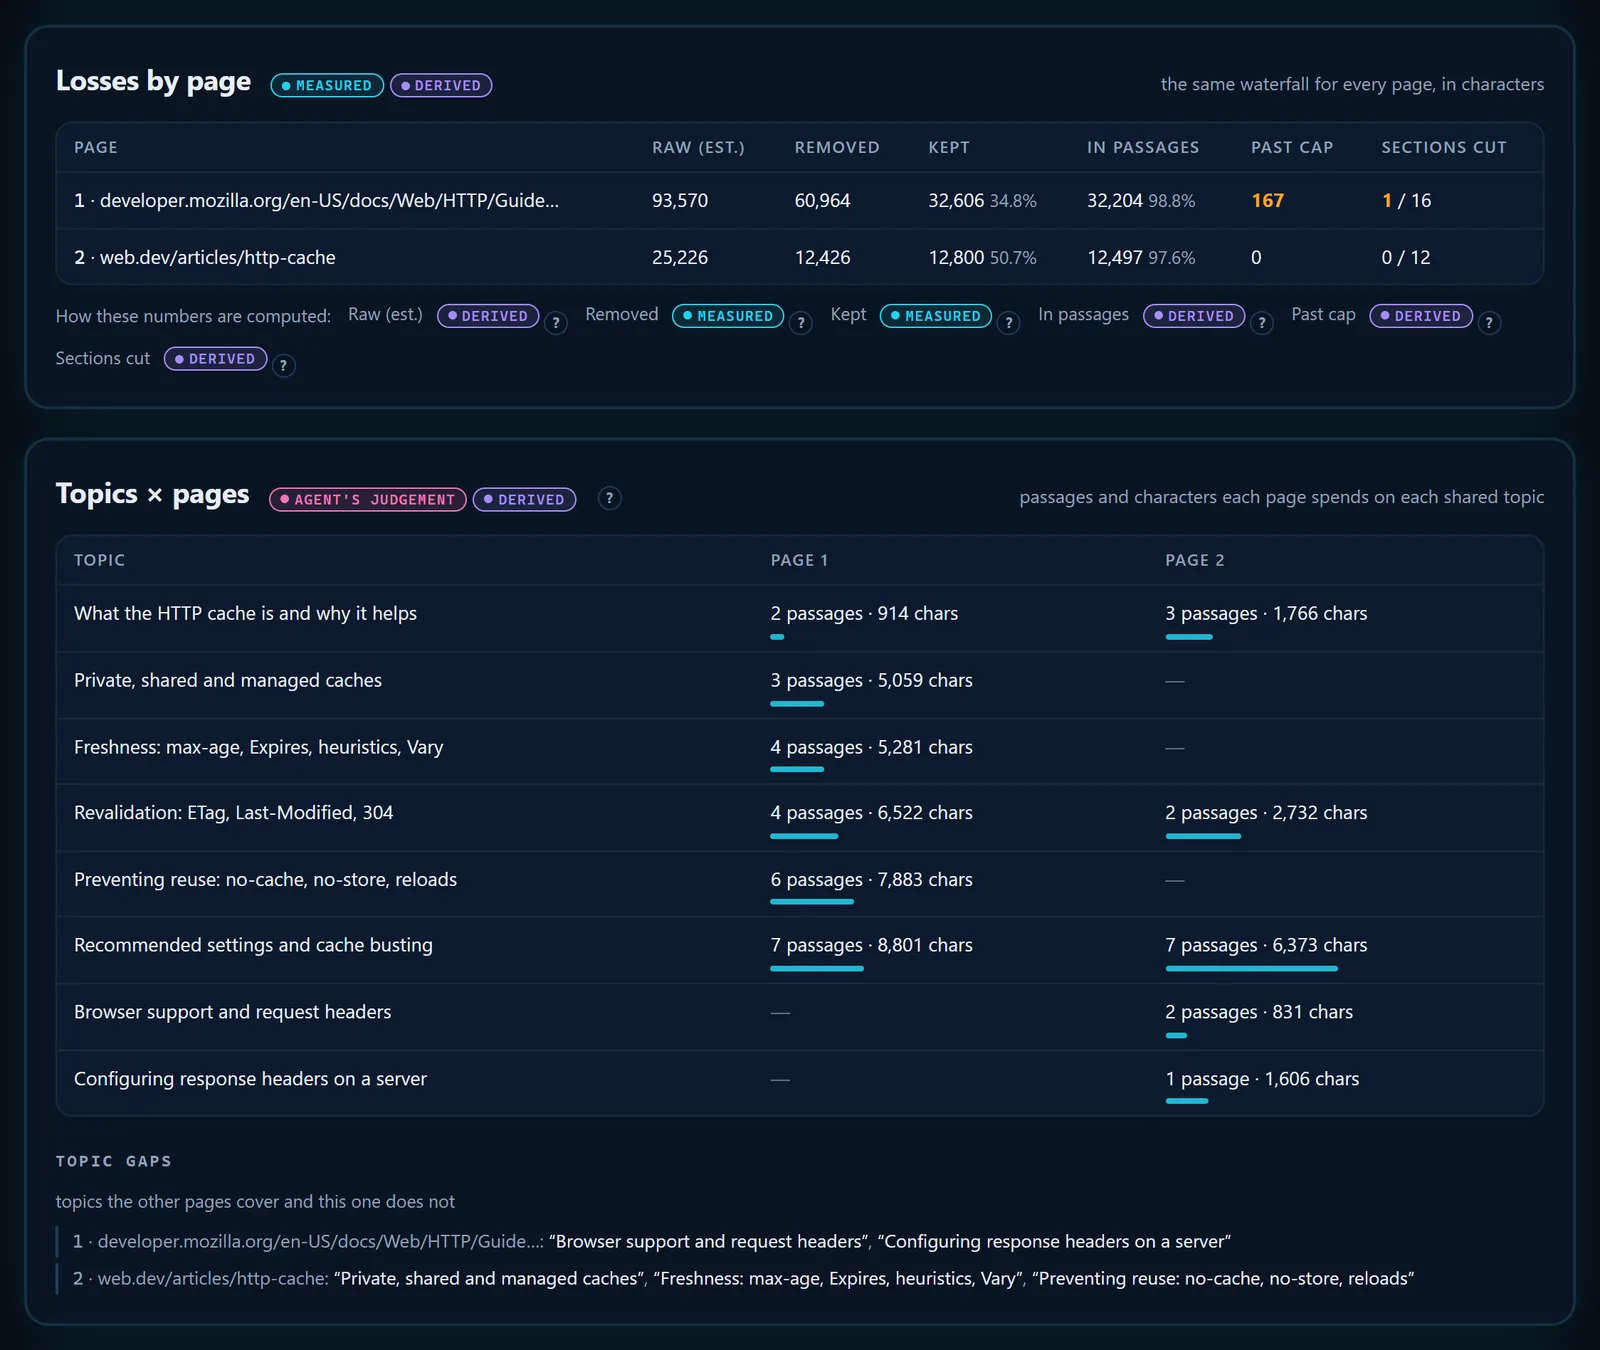
- Так було у 2.102: MDN втрачала 167 символів за лімітом. У 2.103 виправлено розріз, що це спричиняв (h3 з тим самим текстом, що й h2, ділив розділ), і тепер сторінка вміщується.
- Уривки й символи, які кожна сторінка витрачає на тему.
- Тема, яку одна сторінка охоплює, а інша ні.
- Прогалини в темах, сторінка за сторінкою.
06 Дві справжні сторінки, прочитані скілом
Цей скіл Claude Code для AI-пошуку постачається з двома запусками-прикладами. Стаття Вікіпедії про великі мовні моделі заповнює всі 26 слотів і лишає за лімітом 55 001 символ, порахований від унікального тексту в уривках; 2.101 віднімав і перекриття та давав 52 973. Сторінці Vectorscope вистачає 17 уривків, і вона нічого не втрачає. Кожне число нижче взято з JSON цих двох запусків скіла 2.102 — нічого не оцінено на око.
- уривок
- вільний слот
Двадцять шість слотів, по одному на збережений уривок, у порядку читання; проміжок позначає зміну групи, а порожній контур — слот, який сторінці не знадобився. Клітинки рахують уривки, а не символи — символи на останньому графіку.
Довгі розділи ріжуться на вікна, що зупиняються біля 2000 символів; короткі стовпці — кінці розділів і перші рядки сторінки.
- в уривках
- за лімітом
Текст уривків пораховано один раз, без перекриттів по 200 символів і вступу, тож два стовпці разом дають збережений текст сторінки без рядків заголовків, що не потрапили в жоден уривок.
Джерело: приклади запусків скіла examples/wikipedia-llm.json і examples/getlooploop-vectorscope.json, скіл 2.102, створені 16 жовтня 2026 року.
Ті самі числа таблицею
| Сторінка | Слів | Уривків | Символів збережено, з перекриттями | З них унікальних | Символів за лімітом |
|---|---|---|---|---|---|
| Wikipedia — Large language model | 13 718 | 26 / 26 | 41 850 | 39 111 | 55 001 |
| getlooploop.com/vectorscope | 2 463 | 17 / 26 | 14 211 | 13 547 | 0 |
07 Працює з вашим агентом: Claude Code, claude.ai, Codex, opencode, Hermes
Скіл Claude Code для AI-пошуку — одна тека з SKILL.md і скриптами на Node, і кожен агент запускає з неї ті самі команди, тож читає власна модель агента. Claude Code — агент, у якому скіл створено і на честь якого названо цю сторінку, але скрипти від нього не залежать. Ця сторінка описує випуск 2.103 (знімки екрана — з 2.102); версії рахуються в тисячних (2.101, 2.102, 2.103 …), тож перше число змінюється лише тоді, коли зміна ламає сумісність. Кожен агент знаходить скіли у своєму місці:
| Агент | Де шукає скіли |
|---|---|
| claude.ai, Claude desktop | vectorscope.zip, завантажений у Customize > Skills [26] |
| Claude Code | ~/.claude/skills/ (особисті) · .claude/skills/ (проєкт) [21] |
| OpenAI Codex | ~/.agents/skills/ (користувач) · .agents/skills/ (репозиторій) [22] |
| opencode | ~/.config/opencode/skills/ · .opencode/skills/, а також теки Claude Code і Codex [23] |
| Hermes Agent | ~/.hermes/skills/ і теки проєкту, коли ви довірили репозиторій [24] |
| Будь-який інший агент | вкажіть у його файлі інструкцій, як-от AGENTS.md, на skills/vectorscope/SKILL.md |
GLM — це сімейство моделей, а не агент: GLM Coding Plan від Z.ai працює всередині агентів для програмування, і його документація називає серед них Claude Code, Codex і OpenCode [25]. Встановіть скіл для агента, у якому запускаєте GLM, і читати буде GLM.
Повні команди встановлення для кожного агента — у README скіла
08 Як встановити: claude.ai, застосунок Claude, Claude Code
Цей скіл Claude Code для AI-пошуку потребує Node 20.18 або новішого й ніде не потребує npm install: його скрипти постачаються зібраними в dist/, тож їх запускає звичайний node, навіть там, де встановлення пакетів заблоковано.
-
claude.ai або застосунок Claude: завантажте zip
Завантажте
vectorscope.zipзі сторінки випуску й не розпаковуйте його. Увімкніть виконання коду, без якого скіли не працюють [26], далі Customize > Skills > + > Create skill > Upload a skill. -
Дайте пісочниці дістатися сторінки
На Free, Pro і Max увімкніть Allow network egress; на Team і Enterprise власник дозволяє менеджери пакетів і окремі домени, і домен сайту має бути в списку [27]. Якщо налаштування не може цього дозволити, запуск зупиняється з
REFUSED unreachable: скористайтеся Claude Code. -
Вставлене посилання — не встановлення
Claude не завантажуватиме й не запускатиме код за посиланням, вставленим у чат, бо завантажений вміст може містити інструкції, яких ніхто не перевіряв [28]; щонайбільше він імітує кроки, а ці числа — не числа інструмента.
-
Claude Code та інші агенти: клонуйте
Будь-де на вашому комп'ютері.
shellgit clone https://github.com/Olexan-art/getlooploop-skills.git -
Скопіюйте скіл у теку скілів
~/.claude/skills/робить його вашим у кожному проєкті;.claude/skills/усередині репозиторію — лише цього проєкту.macOS, Linux, Git Bashmkdir -p ~/.claude/skills && cp -r getlooploop-skills/skills/vectorscope ~/.claude/skills/vectorscope -
Те саме копіювання в PowerShell
У Windows без Git Bash.
PowerShellNew-Item -ItemType Directory -Force "$HOME\.claude\skills" | Out-Null Copy-Item -Recurse getlooploop-skills\skills\vectorscope "$HOME\.claude\skills\vectorscope" -
Попросіть агента
Наберіть
/vectorscope https://example.com/pageу Claude Code або попросіть звичайними словами в будь-якому агенті. Запуск закінчується показаним HTML-звітом: файлом для завантаження в claude.ai, відкритим чи опублікованим у Claude Code.
09 Чого скіл не робить
Скіл Claude Code для AI-пошуку може показати лише те, що отримує ретривер. Усе, що далі, було б твердженням, яке він не може перевірити, тож він його не робить.
- Жодної оцінки. Сторінка не отримує бала, місця в рейтингу чи відсотка «готовності до ШІ».
- Жодного виявлення ШІ. Скіл не каже, людина чи модель написала сторінку.
- Жодних передбачень відповідей. Він не може сказати, що про вас скаже будь-який асистент і чи є сторінка сьогодні в чиємусь індексі.
- Жодної підміни власного конвеєра асистента. Групи, вердикти запитів і план — це прочитання агента, а не кластеризація ембедингів, і інформаційна панель звіту називає модель, яка їх оцінила; дві моделі можуть оцінити сторінку трохи по-різному. Завантаження, розріз, ліміт і перевірки — фіксовані правила й не змінюються.
- Жодних чисел, порахованих вручну. Там, де скрипти не можуть працювати, — немає Node, виконання коду чи доступу до мережі, — агент так і каже й зупиняється, а не рахує сторінку сам.
- Один публічний URL на прочитання, до п'яти в режимі порівняння, прочитаний як анонімний відвідувач: без входу, без cookie, без Accept-Language. JavaScript виконується лише з
--render, а саме прочитання лишається звичайним завантаженням.

- Скрипти завантажили сторінку та її robots.txt, нічого нікуди не надіслали й не викликали жодної моделі.
- Посилання на GetLoopLoop і його автора.
10 Як скіл пов'язаний із безкоштовним веб-Vectorscope
Веб-Vectorscope і скіл Claude Code для AI-пошуку мають спільні завантаження, видобування, розріз і ліміт. Відрізняються вони тим, хто читає уривки: веб-інструмент будує ембединг кожного уривка, групує їх за виміряною подібністю й малює мапу; скіл віддає уривки вашому агентові й не викликає ембедингів узагалі, і саме це дає йому змогу оцінювати запити й писати план.
| Скіл у вашому агенті | Веб-Vectorscope | |
|---|---|---|
| Завантаження, видобування, розріз, ліміт 26 | Ті самі правила | Ті самі правила |
| Групування | Агент читає й групує | Ембединги, кластеризація середнього зв'язку |
| Семантична мапа | Ні | Так |
| Таблиця robots.txt для AI-краулерів і автоматичні перевірки | Так | Ні |
| Тест запитами й план переписування | Так, від агента | Одне запитання за раз, за подібністю |
| Порівняння сторінок | Від 2 до 5 сторінок | Один URL за раз |
| Де працює | У вашому агенті: на вашому комп'ютері або в пісочниці claude.ai | На нашому сервері, у браузері |
| Обмеження | Жодних наших | Кілька запусків на відвідувача |
11 Запитання про скіл
Цей скіл Claude Code для AI-пошуку безкоштовний?
Так. Скіл має відкритий код під ліцензією MIT. Його скрипти не викликають ні моделей, ні ембедингів; читає модель, на якій уже працює ваш агент, у вашій власній сесії.
Для кого скіл Vectorscope?
Для тих, хто пише сторінки, і для тих, хто будує те, що їх читає. Контент- і SEO-команди перевіряють ним перед публікацією, чи відповідь, заради якої існує сторінка, потрапляє в один уривок вище ліміту і чи можуть AI-краулери її завантажити. Інженери, які будують конвеєри RAG, використовують його як еталонне прочитання, з яким порівнюють власний чанкер.
Чи надсилає скіл мою сторінку кудись?
Ні. Скрипти роблять два GET-запити — сторінку та її robots.txt — і нічого нікуди не надсилають; з --render сторінку ще відкриває локальний браузер. Сам звіт блокує будь-які мережеві запити.
26 уривків — це ліміт, який використовують ChatGPT, Claude чи Perplexity?
Ні. Двадцять шість — ліміт, який застосовують наш Vectorscope і цей скіл. Жоден асистент не публікує ліміту уривків, і це число — робоча модель ліміту, а не вимірювання чийогось.
Чому довга на вигляд сторінка дає лише кілька уривків?
Зазвичай тому, що її текст малює JavaScript. Звичайне прочитання, як і основні AI-краулери, не виконує скриптів; запустіть його з --render, щоб виміряти, скільки сторінки існує лише після JavaScript.
Чи може скіл сказати, чи з'являється моя сторінка у відповідях ШІ?
Ні. Він показує, що ретривер отримав би зі сторінки. Чи цитує вас асистент — це вимірювання в часі на запитах, які ви обираєте, і прочитання сторінки на це не відповість.
Чи працює він поза Claude Code?
Так. claude.ai і застосунок Claude приймають його як завантажений zip і запускають у пісочниці виконання коду; Codex, opencode і Hermes Agent беруть його зі своїх тек скілів; GLM запускає його через ці агенти. Скрипти працюють на звичайному Node без жодного встановлення; судження — від моделі агента.
12 Джерела
Як ми перевіряли ці джерела
Ця сторінка пояснює скіл Claude Code для AI-пошуку, і кожне її твердження про те, як поводиться пошукова система, краулер чи ретривер, прив'язане до джерела, і кожне джерело відкрито й прочитано 16 жовтня 2026. Спершу первинна документація — пошукові системи й оператори краулерів, що описують власні системи, — далі стандарт, потім рецензовані дослідження, а потім тексти постачальників про розбиття, де вони формулюють робоче правило.
Для кожного джерела ми зберегли точне речення, на яке спирається твердження, словами самого джерела, і воно надруковане під посиланням. Де джерело казало менше, ніж чернетка цієї сторінки, речення на сторінці скоротили до сказаного в джерелі. Документація краулерів змінюється; якщо цитата нижче вже не збігається зі своєю сторінкою, та сторінка змінилася, і цю буде оновлено.
Завантажено й процитовано 16 жовтня 2026
- [1] AI features and your website Google Search Central · 2025-12-10 · Пошукова система
To be eligible to be shown as a supporting link in AI Overviews or AI Mode, a page must be indexed and eligible to be shown in Google Search with a snippet, fulfilling the Search technical requirements. There are no additional technical requirements. … Making sure that important content is available in textual form
- [2] Optimizing your website for generative AI features on Google Search Google Search Central · 2026-07-10 · Пошукова система
“Chunking” content: There's no requirement to break your content into tiny pieces for AI to better understand it. Google systems are able to understand the nuance of multiple topics on a page and show the relevant piece to users.
- [3] Introduction to robots.txt Google Search Central · 2025-12-10 · Пошукова система
A robots.txt file tells search engine crawlers which URLs the crawler can access on your site. This is used mainly to avoid overloading your site with requests; it is not a mechanism for keeping a web page out of Google.
- [4] Google's common crawlers Google Crawling Infrastructure · 2026-10-15 · Оператор краулера
Google-Extended does not impact a site's inclusion in Google Search nor is it used as a ranking signal in Google Search.
- [5] Top ways to ensure your content performs well in Google's AI experiences on Search Google Search Central Blog · 2025-05-21 · Пошукова система
This includes making sure that Googlebot isn't blocked, the page works (Google receives an HTTP 200 (success) status code), and the page has indexable content.
- [6] Latest Google Search documentation updates — FAQ rich result Google Search Central · 2026-05-08 · Пошукова система
Deprecating the FAQ rich result feature … This feature will no longer appear in Google Search starting May 7, 2026.
- [7] Understand the JavaScript SEO basics Google Search Central · 2026-03-04 · Пошукова система
Google processes JavaScript web apps in three main phases: Crawling, Rendering, Indexing
- [8] The rise of the AI crawler Vercel, with MERJ · 2024-12-17 · Галузь
The data indicates that while ChatGPT and Claude crawlers do fetch JavaScript files (ChatGPT: 11.50%, Claude: 23.84% of requests), they don't execute them.
- [9] Overview of OpenAI Crawlers OpenAI · Оператор краулера
Sites that are opted out of OAI-SearchBot will not be shown in ChatGPT search answers, though can still appear as navigational links. … Because these actions are initiated by a user, robots.txt rules may not apply.
- [10] Does Anthropic crawl data from the web, and how can site owners block the crawler? Anthropic · 2026-04-07 · Оператор краулера
Claude-SearchBot navigates the web to improve search result quality for users. … Anthropic’s Bots respect “do not crawl” signals by honoring industry standard directives in robots.txt.
- [11] Perplexity Crawlers Perplexity · Оператор краулера
PerplexityBot is designed to surface and link websites in search results on Perplexity. … Since a user requested the fetch, this fetcher generally ignores robots.txt rules.
- [12] Common Crawl FAQ — CCBot Common Crawl · Оператор краулера
CCBot is an automated crawler, checking first the robots.txt … Currently, JavaScript is not executed and Cookies are not used.
- [13] RFC 9309: Robots Exclusion Protocol IETF · 2022-09 · Стандарт
This document specifies the rules originally defined by the "Robots Exclusion Protocol" [ROBOTSTXT] that crawlers are requested to honor when accessing URIs. These rules are not a form of access authorization.
- [14] Bing Webmaster Guidelines Microsoft Bing · Пошукова система
Bing and Copilot search experiences rely on the same core crawling, indexing, and ranking foundation as traditional search. … URLs are more likely to be selected for grounding queries and citations when content stands on its own.
- [15] IndexNow IndexNow (Microsoft Bing, Naver, Seznam.cz, Yandex, Yep) · Стандарт
In its simplest form, IndexNow is a simple ping so that search engines know that a URL and its content has been added, updated, or deleted, allowing search engines to quickly reflect this change in their search results.
- [16] Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks Lewis et al., NeurIPS 2020 (arXiv:2005.11401) · 2020-05-22 · Дослідження
the non-parametric memory is a dense vector index of Wikipedia, accessed with a pre-trained neural retriever. … Each Wikipedia article is split into disjoint 100-word chunks, to make a total of 21M documents.
- [17] Lost in the Middle: How Language Models Use Long Contexts Liu et al., TACL 2024 (arXiv:2307.03172) · 2023-07-06 · Дослідження
performance is often highest when relevant information occurs at the beginning or end of the input context, and significantly degrades when models must access relevant information in the middle of long contexts
- [18] Introducing Contextual Retrieval Anthropic · 2024-09-19 · Галузь
In traditional RAG, documents are typically split into smaller chunks for efficient retrieval. While this approach works well for many applications, it can lead to problems when individual chunks lack sufficient context.
- [19] Chunking Strategies for LLM Applications Pinecone · 2025-06-28 · Галузь
As a rule of thumb, if the chunk of text makes sense without the surrounding context to a human, it will make sense to the language model as well.
- [20] Splitting recursively — text splitter guide LangChain · Інструменти
It tries to split on them in order until the chunks are small enough. The default list is ["\n\n", "\n", " ", ""]. … chunk_overlap: Target overlap between chunks.
- [21] Extend Claude with skills Claude Code Docs (Anthropic) · Інструменти
Skills extend what Claude can do. Create a SKILL.md file with instructions, and Claude adds it to its toolkit. Claude uses skills when relevant, or you can invoke one directly with /skill-name.
- [22] Build skills OpenAI (ChatGPT Learn — Codex) · Інструменти
Codex reads skills from repository, user, admin, and system locations. … For repositories, Codex scans `.agents/skills` in every directory from your current working directory
- [23] Agent Skills OpenCode · Інструменти
Create one folder per skill name and put a `SKILL.md` inside it. OpenCode searches these locations: … `~/.config/opencode/skills/<name>/SKILL.md` … `.claude/skills/<name>/SKILL.md` … `.agents/skills/<name>/SKILL.md`
- [24] Skills System Nous Research (Hermes Agent) · Інструменти
All skills live in `~/.hermes/skills/` — the primary directory and source of truth.
- [25] GLM Coding Plan — Overview Z.ai · Інструменти
The plan can be applied to agent tools such as ZCode, Claude Code, Codex, OpenCode, AutoClaw, and OpenClaw
- [26] Use skills in Claude Claude Help Center (Anthropic) · 2026-09-22 · Інструменти
Skills require the code execution environment to function. … Upload a ZIP file containing your skill folder.
- [27] Create and edit files with Claude Claude Help Center (Anthropic) · 2026-08-06 · Інструменти
To give Claude access to external data sources, toggle Allow network egress on … Allow network egress to package managers and specific domains: Claude can access package managers plus additional domains you specify.
- [28] Agent Skills Claude Platform Docs (Anthropic) · Інструменти
Depending on user/admin settings, Skills may have full, partial, or no network access. … Skills that fetch data from external URLs pose particular risk, as fetched content may contain malicious instructions.