ШІ читає вашу сторінку шматками. Три безкоштовні навички показують, якими
Vectorscope, AI Search Audit Lite та AI Search Audit Full — це відкриті Agent Skills, які працюють у вашому власному агенті. Вони показують, що ретривер залишає зі сторінки, що відкидає і які опубліковані правила сторінка порушує. Без оцінки в балах і без передавання даних нам.
Переклад з англійського оригіналу.
Коротка відповідь
- what
- Три відкриті Agent Skills версії 2.106: Vectorscope показує, як ретривер читає одну сторінку; AI Search Audit Lite перелічує проблеми однієї сторінки; AI Search Audit Full пояснює кожну проблему, перевіряє до 50 сторінок і веде історію.
- why
- Бо ШІ-асистенти відповідають з уривків, а не зі сторінок, і більша частина втрат стається ще до того, як модель прочитає хоч слово. Класичні правила SEO і готовність до ШІ-пошуку перетинаються, але це не один і той самий список.
- who
- Маркетологи, яким треба знати, чи можна процитувати сторінку; SEO-фахівці, які перевіряють сторінки за правилами Google, Bing і ШІ-краулерів; розробники, які створюють і виправляють сторінки.
- where
- На GitHub за ліцензією MIT. Встановлюються однією командою в Claude Code, Codex, opencode та інші агенти, що завантажують навички SKILL.md, або архівом для claude.ai.
- when
- Випущені в жовтні 2026 року. Приклади запусків, на які тут посилаємося, зроблено 16 і 17 жовтня 2026 року, а кожну цитату звірено з чинним джерелом 17 жовтня 2026 року.
- how
- Детерміновані скрипти Node завантажують, вилучають текст, ріжуть на уривки й перевіряють без жодного виклику моделі чи ембедингів; частини-судження пише агент, який запускає навичку, і звіт позначає їх як його власні. Нічого не надсилається в GetLoopLoop.
Просте пояснення
Коли ви ставите ШІ-асистентові запитання, він не читає сайти цілком. Спершу програма завантажує сторінку, викидає меню й кнопки, а решту ріже на шматки завдовжки приблизно зі сторінку книжки. Вона залишає лише перші 26 шматків, і асистент відповідає вже з них. Ці три безкоштовні інструменти показують шматки вашої власної сторінки: які з них є, які частини тексту не потрапили в жоден, і які прості правила Google та ШІ-компаній сторінка порушує. Вони працюють на вашому комп’ютері, з вашим власним ШІ-помічником.
Запитайте ШІ-асистента про свій продукт — і він не прочитає вашу сторінку. Він прочитає кілька її шматків. Ще до того, як модель побачить хоч слово, краулер завантажує HTML, чистильник викидає все, що схоже на обстановку, а чанкер ріже решту на уривки. Потім ретривер вибирає уривки, схожі на відповіді. Те, що не пережило цих кроків, процитувати неможливо, хоч би яким добрим воно було.
Ми створили Vectorscope, щоб зробити це читання видимим, а цього місяця випустили його, разом із двома аудитами на його основі, як відкриті Agent Skills. Вони працюють у вашому агенті, на вашому комп’ютері, безкоштовно. Скрипти не викликають жодної моделі чи API ембедингів, і нічого не надсилається в GetLoopLoop. Далі — для чого кожна навичка, що вони знайшли на реальних сторінках, зокрема на наших, і три симуляції на синтетичних сторінках.
Чому саме зараз
Правила, за якими пошуковики показують сторінку, і правила, за якими ШІ-асистенти її цитують, почали розходитися, і опублікована документація прямо про це каже.
Власні настанови Google щодо AI Overviews та AI Mode прив’язують їх до звичайного Пошуку. Сторінка AI features and your website ставить одну технічну вимогу:
Щоб сторінку могли показати як посилання-джерело в AI Overviews чи AI Mode, вона має бути проіндексована й придатна до показу в Google Пошуку зі сніпетом.
Google Search Central, AI features and your website (оновлено 10 грудня 2025)
Та сама сторінка так само прямо каже, чого не треба: жодного особливого файлу, жодної нової розмітки.
Вам не потрібно створювати нові машиночитні файли, текстові файли для ШІ чи розмітку, щоб з’являтися в цих функціях.
Google Search Central, AI features and your website
У червні Google додав до своїх оновлень документації примітку про llms.txt: такі файли «не потрібні для Google Пошуку», хоча тримати їх для інших систем можна. А частина розмітки, яка колись давала розширений результат, більше його не дає. Розширеного результату FAQ, заради якого багато сайтів додавали структуровані дані FAQPage, більше немає:
Ця функція більше не з’являтиметься в Google Пошуку з 7 травня 2026 року.
Google Search Central, оновлення документації, запис від 8 травня 2026
Тим часом кожна ШІ-компанія має кілька краулерів, і вони виконують різну роботу. Документація OpenAI відділяє OAI-SearchBot, від якого залежить, чи може сайт з’явитися в пошукових відповідях ChatGPT, від GPTBot, що збирає дані для навчання, і наголошує: «кожне налаштування незалежне від інших». Anthropic описує ClaudeBot, Claude-User і Claude-SearchBot так само, а Perplexity документує PerplexityBot для пошуку і Perplexity-User для запитів, які робить людина.
Сайти, які відмовилися від OAI-SearchBot, не показуватимуться в пошукових відповідях ChatGPT
OpenAI, Overview of OpenAI crawlers
Вимкнення Claude-SearchBot на вашому сайті не дає нашій системі індексувати ваш контент для пошукової оптимізації
Anthropic, Does Anthropic crawl data from the web, and how can site owners block the crawler?
Отже, сторінка може пройти SEO-чекліст і все одно бути невидимою для асистента, бо один рядок у robots.txt блокує саме того краулера, що відповідає людям. І вона може виконати всі правила для краулерів, але втратити найкращий абзац за межею, де ретривер припиняє читати. Два списки перетинаються, але це не один список. Навички перевіряють обидва, локально.
Асистент цитує уривок, а не сторінку
Нижче — конвеєр, який відтворює Vectorscope, зі справжньою кількістю знаків із трьох прикладів навички від 17 жовтня 2026 року: наша сторінка Vectorscope, посібник MDN про HTTP-кешування і стаття Вікіпедії про великі мовні моделі.
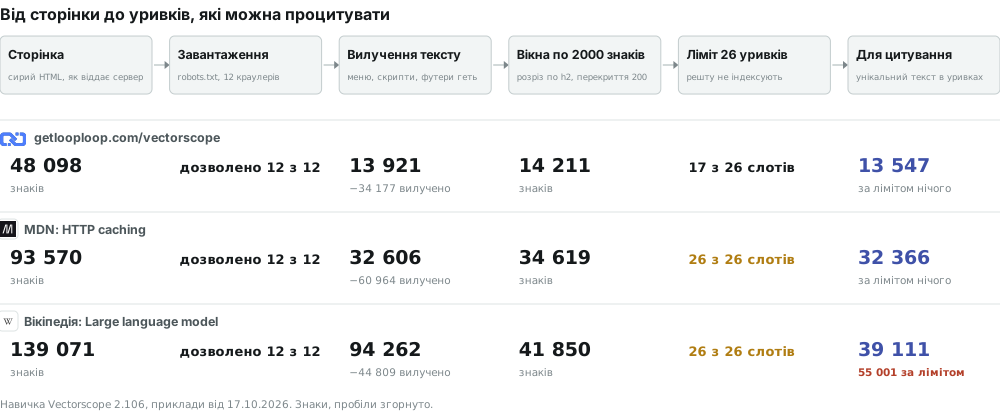
Більшість того, що завантажує краулер, — зовсім не текст: на нашій сторінці 32 534 із 34 177 вилучених знаків припали на скрипти й стилі. Те, що залишає чистильник, ріжеться по заголовках h2 на вікна до 2000 знаків із перекриттям у 200, і з однієї сторінки індексується щонайбільше 26 уривків. MDN заповнює всі слоти й закінчується якраз на межі. Вікіпедія заповнює всі слоти й триває ще 55 001 знак, яких не містить жоден уривок.
26 — це ліміт Vectorscope, а не число, яке публікує якийсь асистент. Фіксований, відомий ліміт робить питання вимірюваним: яку частину цієї сторінки ретривер із лімітом не прочитає ніколи? (Докладніше в глосарії: придатність до чанкінгу і розрив у пошуку уривків.)
Vectorscope: як ретривер читає одну сторінку
Що робить. Навичка Vectorscope застосовує до будь-якої публічної адреси точно те саме завантаження, вилучення тексту, нарізання й ліміт у 26 уривків, що й продукт, перевіряє robots.txt для дванадцяти краулерів, від GPTBot і OAI-SearchBot до Claude-SearchBot, PerplexityBot, Google-Extended і CCBot, за правилами RFC 9309, і робить перевірки структури: відповіді FAQ, що втратили запитання, уривки, які починаються з середини речення, рядки меню в тексті, тонкі розділи, одне твердження всюди, canonical, JSON-LD і meta description.
Чим відрізняється від вебінструмента. Вебверсія Vectorscope групує уривки за ембедингами. Навичка ембедингів не викликає, тож агент, який її запускає, сам читає уривки й групує їх за темою, і звіт пише про це біля кожної групи.
Для кого. Для авторів, які хочуть знати, чи головні абзаци сторінки взагалі доходять до уривка; для SEO-фахівців, які пояснюють, чому довга сторінка слабко виступає у ШІ-відповідях; для розробників, які хочуть бачити, що їхня розмітка робить із текстом.
Що показує звіт. Один самодостатній HTML-файл англійською або українською. Кожне число має позначку: виміряно, виведено (за фіксованою формулою) або судження (агента), а «?» поруч відкриває формулу. Згорнутий розділ Куди дівається текст простежує знаки від сирого HTML до уривків: що вилучив чистильник, елемент за елементом, і яка частина кожного розділу дійшла до уривка. Далі частина агента: тематичні групи, перевірка 5–10 типових запитань із точними словами, які ретривер міг би процитувати, і план переписування з текстом до і після. Режим порівняння ставить 2–5 сторінок на одну таблицю тем.
Ось згорнутий розділ для статті Вікіпедії про великі мовні моделі, прочитаної 17 жовтня 2026 року.
Спробуйте на власній сторінці
Подивіться, що Vectorscope знайде на вашій сторінці
Усе, що написано вище, можна зміряти на власній роботі, і перевірка займає близько хвилини. Вставте одну адресу і прочитайте, що повернеться.
Відкрити VectorscopeБезкоштовно · без акаунта · по одній за раз
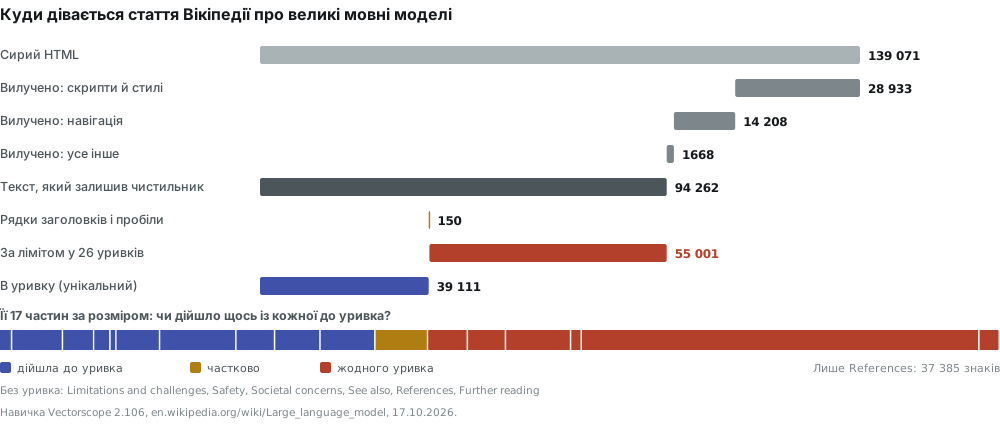
Цей рисунок важливо прочитати чесно, бо число на кшталт «втрачено 55 001 знак» легко перебільшити. Із шести частин, що не дійшли до жодного уривка, References сам має 37 385 знаків, а цитувати список джерел ретриверові ні до чого. Але три з них — це проза: Limitations and challenges, Safety і Societal concerns, разом 13 448 знаків, а Evaluation доходить до уривка лише 3801 знаком із 4952. Ретривер із лімітом, що читає цю статтю за порядком, знав би багато про те, як будують мовні моделі, і нічого про те, що з ними не так. Саме для таких знахідок інструмент і існує: не оцінка, а місце.
Наша власна сторінка Vectorscope, прочитана того ж дня, потребує 17 уривків і нічого не втрачає за лімітом. Але й вона не чиста. Навичка позначає два уривки, що починаються з середини речення, шість рядків меню посеред тексту (підписи кроків самого конвеєра, від «1. Fetched» до «5. Grouped»), розділ на 139 знаків, закороткий, щоб стояти самостійно, і фразу, що повторюється у трьох тематичних групах. Ми навмисно залишаємо це в прикладі.
AI Search Audit Lite: одна сторінка проти опублікованих правил
Що робить. Lite перевіряє одну публічну сторінку за правилами, які публікують Google, Bing та ШІ-компанії, з читанням Vectorscope поруч: robots.txt для пошукових і ШІ-краулерів, noindex і керування сніпетами, sitemap; чекліст Google і Bing на 35 клітинок, від довжини title й порядку заголовків до неробочих посилань, зображень, варіантів URL і заголовків відповіді; структуровані дані проти властивостей, які перелічує Google, із датою скасування розширених результатів; мовні версії, де кожну альтернативу з hreflang завантажують і перевіряють, чи посилається вона назад; і наявність ознак E-E-A-T, тобто чи є на сторінці автор, посилання «Про нас» і «Контакти» та дані організації, а не оцінку експертизи за ними.
Три читання, які може зробити лише ШІ. Агент, що запускає навичку, пише 8–12 запитань, які люди ставлять на цю тему, і скрипт перевіряє кожне проти уривка з дослівною цитатою. Потім модель агента відповідає на п’ять запитань покупця про бренд зі своїх власних знань і каже, що думає про рейтинг бренду на дванадцяти платформах відгуків плюс одній вигаданій контрольній: рейтинг на платформі, якої не існує, — це галюцинація. Це погляд однієї моделі з її назвою; вебверсії Brandscope і Reviewscope питають трьох асистентів.
Чого не робить. Кожна проблема — це короткий підпис, серйозність і місце на мапі сторінки. Ні оцінки, ні порад. Про список помилок із доказами двоє людей можуть домовитися; оцінка в балах запрошує до суперечки про ваги.
Для кого. Для кожного, хто має відповісти «чи щось зламано на цій сторінці?» і передати список тому, хто виправлятиме.
Lite містить п’ять реальних запусків від 17 жовтня 2026 року. Три з них — наші власні сторінки.
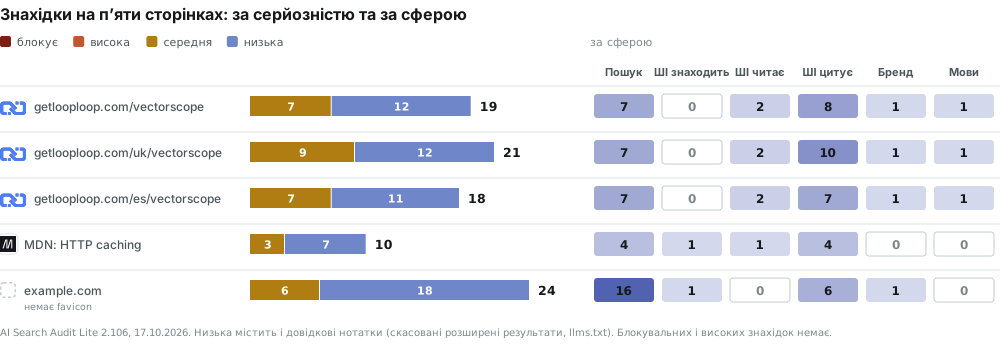
Наша англійська сторінка Vectorscope має 19 знахідок, жодної блокувальної. Дві найконкретніші незручні в корисний спосіб: два посилання на статті, що повертають 404, і розмітка SoftwareApplication без полів, які Google вимагає для цього типу. Сторінка досі має розмітку FAQPage і HowTo для розширених результатів, яких Google більше не показує, і Lite подає це як довідкову нотатку, а не як помилку. На два з дванадцяти запитань, які написав агент, відповіді на сторінці немає взагалі. А модель, що проводила аудит, Claude Opus 5.5 у Claude Code, не знала GetLoopLoop зі своїх знань і так і сказала: аудит записує це як brand_unknown, і це чесний результат для молодого продукту та причина зробити так, щоб сторінка відповідала на те, чого модель не знає.
example.com, зарезервований домен для документації, має найбільше знахідок, 24, здебільшого через відсутність того, що мав би справжній сайт: немає h1, опису, favicon, варіанти з http і www не перенаправляють. MDN має найменше, 10, і її середні знахідки стосуються читання, а не правил: шість уривків починаються з середини речення.
AI Search Audit Full: пояснення, сайт та історія
Full виконує всі перевірки Lite і додає те, що потрібно фахівцеві, щоб діяти.
Три шари на кожну проблему. Що не так — простими словами, без порад. Що каже правило — коротка дослівна цитата з офіційного джерела з посиланням і датою перевірки, або примітка, що поріг належить самій навичці, коли ніхто його не публікує. І напрям виправлення — стисло й технічно, згорнуто в деталях для фахівців. Випуск 2.106 містить 83 цитати, кожну звірено слово в слово з чинною сторінкою 17 жовтня 2026 року.
До 50 сторінок. Зі списку адрес або sitemap, по одній, щонайменше з секундною паузою і лише там, де дозволяє robots.txt. Звіт по сайту додає проблеми, що повторюються на сторінках, і перевірки, які може зробити лише набір сторінок: дублікати title, сторінки-сироти, глибину посилань, пари hreflang, ланцюжки canonical.
До/після та історія. --compare old-export.json дає виправлені, нові й незмінні знахідки. Кожен запуск також зберігається як знімок на вашому комп’ютері, тож кожен звіт показує, що змінилося з минулого разу, аж до уривків.
Приклад — аудит трьох сторінок getlooploop.com: сторінка Vectorscope англійською, українською та іспанською.
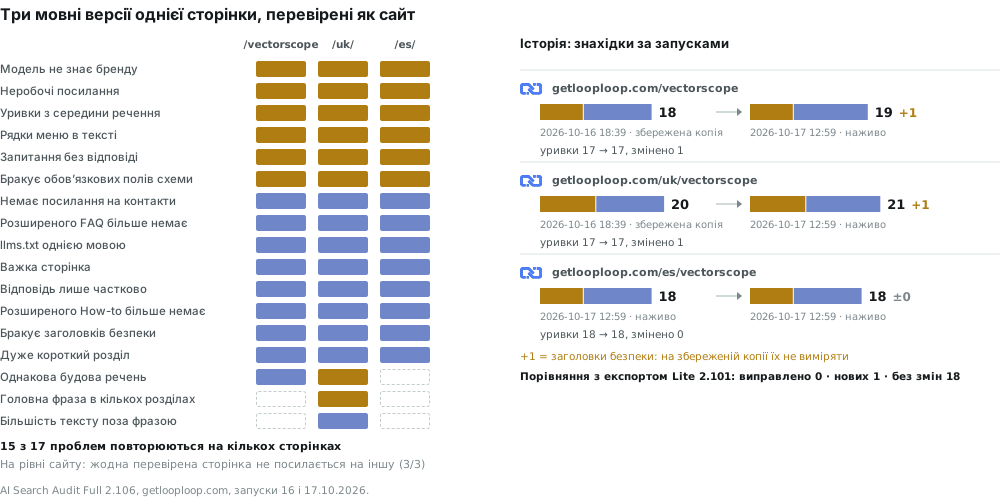
П’ятнадцять із сімнадцяти типів проблем повторюються на кількох сторінках, і в цьому практична цінність звіту по сайту: проблема, що є в кожній мовній версії, — це одне виправлення в шаблоні, а не три тікети. Перевірка на рівні сайту знайшла те, чого не побачить аудит однієї сторінки: жодна з трьох версій не посилається на іншу, тож кожна з них — сирота в межах перевіреного набору. (Навичка сама додає застереження: на сторінку може посилатися щось поза набором.)
Історію треба читати уважно. Між двома запусками /vectorscope перейшла з 18 знахідок до 19, і нічого не погіршилося: перший запуск читав копію, збережену напередодні, у збереженого файлу немає HTTP-заголовків відповіді, тож перевірку заголовків позначено як не виміряну; живий запуск виміряв їх і виявив, що бракує трьох заголовків безпеки. Дрейф показує, що слів стало 2469 замість 2463, і один змінений уривок із 17. Порівняння з експортом Lite 2.101 тієї ж сторінки каже те саме своїми словами: 0 виправлено, 1 нова, 18 без змін, і нова — це перевірка, яку додала версія 2.102.
Щодо розмітки FAQ на сторінці пояснення каже, що розмітка не шкодить, але вже не дає результату, заради якого її додали, цитує оновлення документації Google із посиланням і датою перевірки й дає фахівцеві напрям: для Google нічого не потрібно; залиште, якщо її читає інший споживач, або видаліть, щоб полегшити сторінку.
Яку навичку запускати
У трьох навичок спільне ядро. Lite і Full містять код читання Vectorscope без змін, тож кількість уривків чи знаки за лімітом означають те саме в усіх трьох звітах. Відрізняються вони питанням, на яке відповідають.
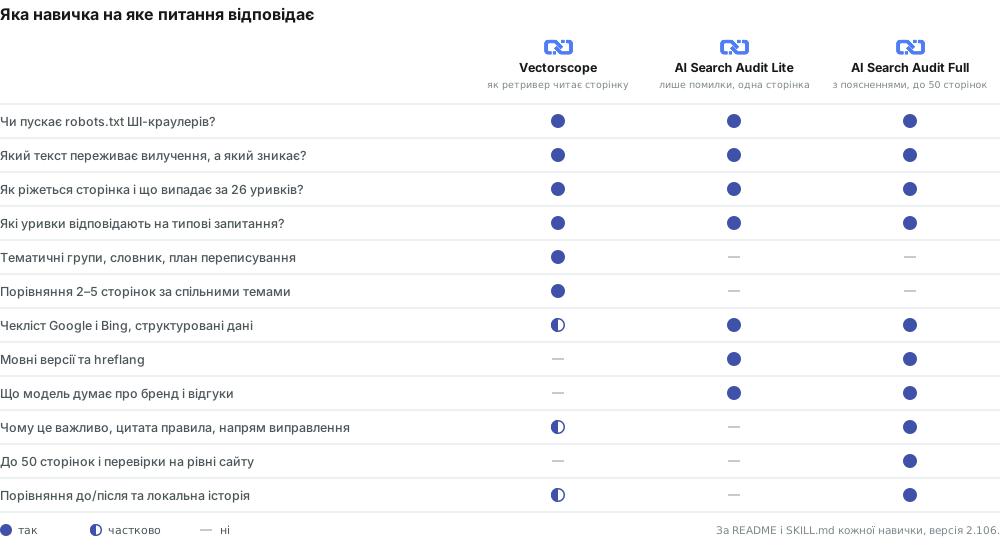
- Маркетологові чи керівникові контенту з однією важливою сторінкою потрібен Vectorscope: які абзаци доходять до уривка, на які запитання сторінка відповідає словами, придатними для цитування, і як переписати слабкі.
- SEO-фахівцеві потрібен Lite для списку і Full для звіту: правило, процитоване з джерела, закриває питання «а хто так сказав?», а звіт по сайту перетворює п’ятдесят сторінок знахідок на кілька виправлень у шаблонах.
- Розробник отримує напрями виправлення з Full і таблицю вилучень Vectorscope, де названо кожен вилучений елемент, його CSS-шлях і кількість знаків.
Три симуляції на синтетичних сторінках
Реальні сторінки показують, що знаходять інструменти; синтетичні — як вони поводяться, бо можна змінити одну річ і подивитися, як з’являється чи зникає одна знахідка. Ми написали невеликі HTML-сторінки на вигадану тему, догляд за велосипедом удома, на зарезервованому домені example.com, і прогнали кожну через AI Search Audit Lite 2.106 у режимі збереженої копії (--html для сторінки, --robots для robots.txt): нічого не завантажується, жодна модель не викликається, на будь-якому комп’ютері ті самі числа. Текст зібрано з шаблонів речень, і інструмент це помічає: кожна сторінка отримує знахідку repeated_sentence_shape, що правильно, і вона лишається в підсумках.
1. Посібник на 40 розділів проти ліміту в 26 уривків
Одна сторінка, 40 розділів h2 приблизно по 1400 знаків, від тиску в шинах до перевірки перед поїздкою. Кожен розділ вміщується в одне вікно, тож сторінці потрібно 42 уривки: один на заголовок, один на лід і по одному на розділ.
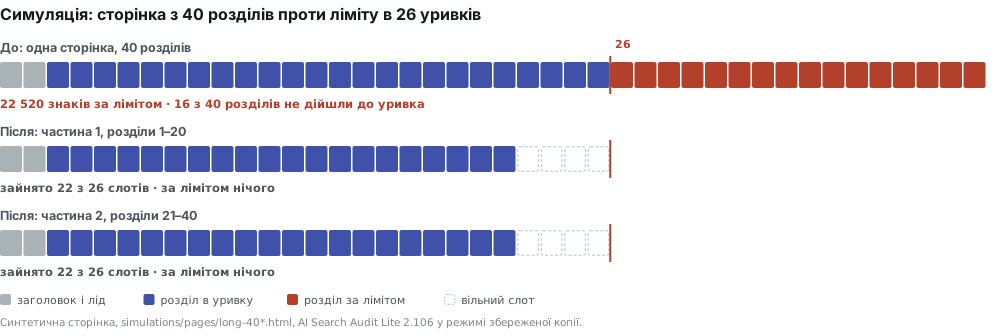
Ліміт обрізав посібник після 24-го розділу. Розділи з 25-го по 40-й, від Saddle setback до A pre-ride check, не дійшли до жодного уривка: 22 520 із 56 789 знаків, які залишив чистильник. Lite подає це як єдину високу знахідку, cap_overflow, а його вердикт звучить «1 проблема ховає текст від ШІ». Після поділу на дві сторінки по 20 розділів кожна частина займає 22 з 26 слотів, за лімітом нічого, і висока знахідка зникає: 8 знахідок до, по 7 на частину після; решта — знахідка про шаблони й розмітка, якої бракує синтетичній сторінці. Поділ — не єдиний вихід: якщо підняти вище розділи, про які справді питають, зміниться те, які 24 потраплять усередину. На довгій сторінці порядок — це рішення про те, чого ретривер із лімітом ніколи не прочитає.
2. robots.txt, що блокує не того краулера
Коротка звичайна сторінка, прогнана двічі з двома файлами robots.txt. Перший блокує двох краулерів і пускає всіх інших:
User-agent: OAI-SearchBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: *
Allow: /| robots.txt | Знахідки | Блокувальні | Що каже аудит |
|---|---|---|---|
| Блокує OAI-SearchBot і ClaudeBot | 8 | 1 | OAI-SearchBot заблоковано (блокує); ClaudeBot заблоковано (низька) |
| Пускає всіх | 6 | 0 | Нічого про краулерів |
Два блокування важать по-різному, і в цьому суть. Блокування OAI-SearchBot не пускає сторінку в пошукові відповіді ChatGPT, тож Lite позначає його як блокувальне, а вердикт звучить «1 проблема блокує пошук або ШІ». Блокування ClaudeBot зупиняє лише краулера для навчання: пошуковий краулер Anthropic, Claude-SearchBot, має власний токен і досі пропущений групою *. Тому Lite подає його як низьке — власник міг зробити такий вибір свідомо. Кожна знахідка посилається на сторінку краулерів постачальника, тож читач може сам перевірити цю різницю.
3. Відповіді FAQ, що втрачають свої запитання
Шість запитань і відповідей в акордеоні. У першій версії кожне запитання — це підпис кнопки <button>, що відкриває панель, поширений підхід. У другій кожне запитання — це <summary> елемента <details>. Видима сторінка однакова.
| Розмітка | Знахідки | Високі | Вилучено знаків | Що в уривку |
|---|---|---|---|---|
| Запитання в <button> | 4 | 1 | 402 | 6 відповідей, 0 запитань |
| Запитання в <summary> | 3 | 0 | 146 | 6 відповідей із запитаннями |
Чистильник ретривера вилучає кнопки, бо на більшості сторінок кнопка — це обстановка: «Підписатися», «Прийняти cookies», «Далі». Тут це правило забирає з собою запитання. Різниця у вилучених знаках, 256, — це точно довжина шести запитань. Лишається уривок із відповідей, що починаються з «Yes, if your bike has carbon parts» і «No, not for long», без жодної вказівки, на що вони відповідають. Перевірка навички lost_faq_questions ловить це як високу: шість початків відповіді й жодного знака питання в уривку. Коли запитання в <summary>, знахідки немає.
Ми також хотіли змоделювати hreflang, що не посилається назад, і відмовилися. Ця перевірка завантажує кожну альтернативу, режим збереженої копії нічого не завантажує, а навичка навмисно відмовляє локальним адресам, тож симуляція була б нашим скриптом, а не навичкою.
Встановлення й запуск
Кожній навичці потрібен Node 20.18 або новіший і жодного npm install: скрипти зібрано заздалегідь. З skills CLI одна команда встановлює навичку для Claude Code, Codex, opencode та інших агентів, що завантажують навички SKILL.md:
npx skills add Olexan-art/getlooploop-skills --skill vectorscope
npx skills add Olexan-art/ai-search-audit
npx skills add Olexan-art/ai-search-audit-full
Далі попросіть агента звичайними словами: «прожени сторінку https://example.com/page через vectorscope» або «зроби AI search audit сторінки https://example.com/page». Для claude.ai і застосунку Claude для комп’ютера завантажте архів випуску (vectorscope.zip, ai-search-audit.zip або ai-search-audit-full.zip), увімкніть виконання коду й завантажте архів у Customize > Skills, не розпаковуючи. Пісочниці потрібен доступ до сайту, який вона читає; налаштування описано в кожному README.
Репозиторії, усі за ліцензією MIT: getlooploop-skills для Vectorscope, ai-search-audit для Lite і ai-search-audit-full для Full. Налаштування є також на сторінці Agent Skills для SEO, GEO і маркетингу. Під капотом агент запускає два скрипти, а між ними — власні файли суджень:
node dist/read.mjs https://example.com/page --out reading.json
# агент пише questions.json, brand.json і reviews.json
node dist/audit.mjs reading.json --questions questions.json \
  --brand brand.json --reviews reviews.json --html report.html

# без мережі: аудит збереженої копії
node dist/read.mjs https://example.com/page --html page.html \
  --robots robots.txt --out reading.json

# лише Full: до 50 сторінок, потім звіт по сайту
node dist/read.mjs --urls urls.txt --out-dir readings
node dist/audit.mjs --site readings/site.json --questions-dir questions --out-dir report
Чого вони не роблять
- Жодної оцінки. Жодна з трьох не ранжує сторінку й не ставить їй бал зі 100. Вони повідомляють знахідки, кожну з доказом і правилом, на яке вона спирається.
- Жодних прогнозів. Вони не кажуть, що відповість про вас ChatGPT, Gemini чи Perplexity. Читання бренду й відгуків — це знання однієї моделі на момент її навчання, позначені назвою цієї моделі, а не вимірювання будь-якого асистента.
- Жодного розпізнавання тексту, написаного ШІ. Перевірки стилю рахують шаблонні фрази й повторювану будову речень із позиціями. Це сигнали для редактора, а не вирок про те, хто написав сторінку.
- Шари суджень — це читання одного агента. Тематичні групи, запитання, вердикти про те, чи відповідає на них уривок, і план переписування пише агент, який запускає навичку. Скрипти їх перевіряють (кожна цитата має бути дослівною зі свого уривка), і звіт їх позначає, але інша модель могла б згрупувати ті самі уривки інакше.
- Ні польових даних, ні статусу в індексі. Core Web Vitals і «чи є сторінка в індексі Google» завжди позначено як не виміряні: для них потрібні дані реальних користувачів і Search Console.
- Лише публічні сторінки. Без входу, без cookies, без локальних і приватних адрес. Кожен ліміт (30 посилань, 20 зображень, 10 мовних версій, 50 сторінок) названо у звіті, і жоден не застосовується мовчки.
Де живий продукт іде далі
Навички відповідають на питання, чим є сторінка сьогодні для машини, яка її читає. Вони не можуть сказати, що насправді відповідають асистенти, якими користуються люди, і як це змінюється. Це й робить GetLoopLoop: за розкладом ставить справжнім асистентам запитання ваших покупців і записує, які бренди й сторінки вони цитують, тож ви бачите свою частку відповідей тижнями, а не думку однієї моделі один раз. Вебверсія Vectorscope додає мапу на основі ембедингів, яку навичка свідомо не робить, а Brandscope і Reviewscope питають трьох асистентів замість одного. Як ми вимірюємо, описано в методології.
Але почніть зі сторінки. Запустіть одну з навичок на сторінці, яка для вас найважливіша, подивіться, куди дівається її текст, і виправте першу знахідку. Якщо судити з наших власних сторінок, щось знайдеться.
Продукт
Стежте за кожною сторінкою щодня
Одне зчитування каже, де сторінка стоїть сьогодні. Продукт ставить ті самі питання тим самим асистентам постійно — тож про зміну вам повідомляють, а не ви йдете її шукати.
Попросити запрошенняЗа запрошеннями, поки ми тримаємо зчитування чесними
На цю тему
Чи готова моя сторінка до пошуку зі ШІ?
Щодня Краулінг із прочитанням Vectorscope біля кожної сторінки і повторна перевірка після кожного виправлення. Як працює продукт
Автор
Olexandrавтор
15+ років у маркетингу та SEO. Десятки продуктів, переважно американський ринок. Дослідження і заміри.
LinkedInPass it on
Read in your language
Opens a browser translation of this English article. The original source stays in English.