

Усі сценарії/ Розробник
Сайт на JavaScript: що бачить пошуковик до рендеру і після
Сайт переїхав на React, Vue чи інший фреймворк, і частина сторінок випала з індексу або показується з чужим title. У браузері все гаразд, бо браузер виконує JavaScript. Пошуковик спершу читає сирий HTML, і треба знати, що в ньому немає і що JavaScript змінює.
- Хто
- Фронтенд-розробник, техлід, технічний SEO
- Сайт
- SPA або сайт із рендерингом на клієнті, частково чи повністю
- Що болить
- Сторінки поза індексом, порожні сніпети, посилання, яких пошуковик не бачить
- Що треба
- Перелік сторінок, де HTML і відрендерена версія розходяться, і що саме відрізняється
Кроки в Molfar
Увімкніть рендеринг для всіх сторінок
«Рендеринг JavaScript» у налаштуваннях сканування має три режими. «Авто» рендерить лише сторінки, у сирому HTML яких мало тексту, тож сторінку з текстом, але зі зміненим через JavaScript canonical, він не порівняє. Для сайту на фреймворку оберіть «Усі сторінки»: це повільніше, зате кожна сторінка буде прочитана двічі.
Налаштування · Сканування — документація (англійською)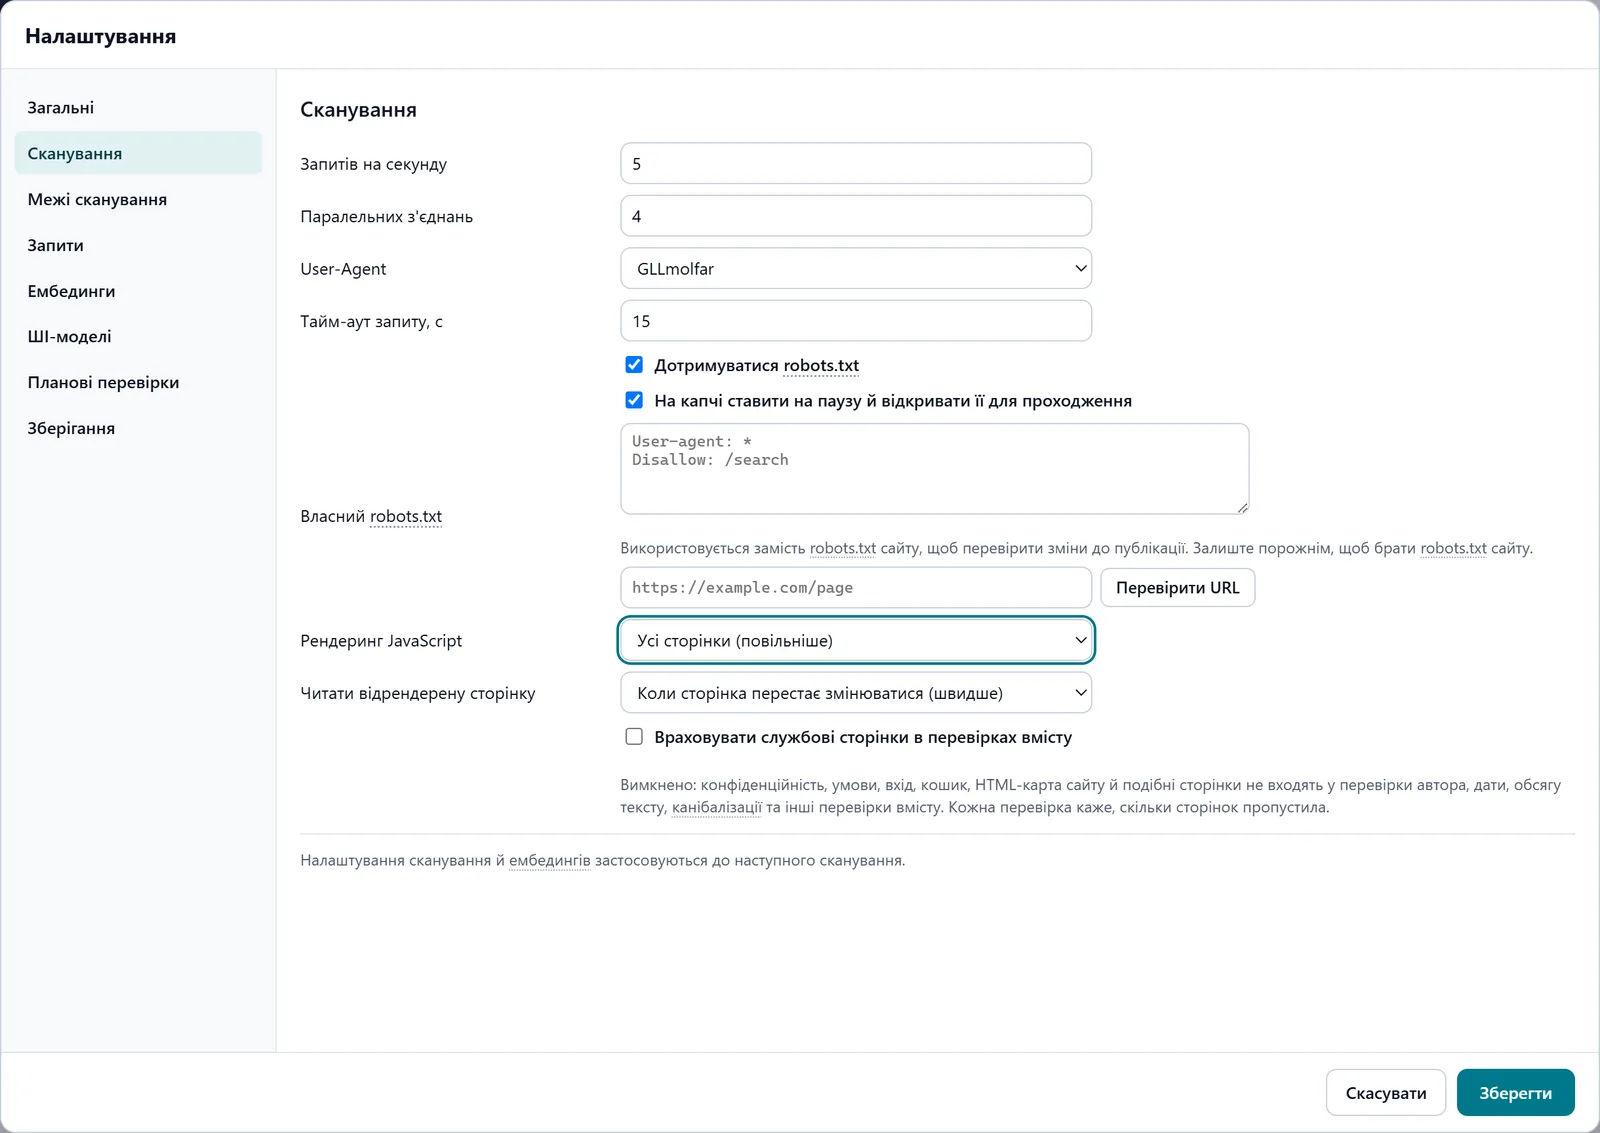
На знімку: Налаштування рендерингу JavaScript Дочекайтеся контенту, що вантажиться пізно
«Читати відрендерену сторінку» вирішує, коли сторінку вважати готовою: коли вона перестала змінюватися або коли ще й мережа затихла. Другий варіант для сторінок, що підтягують текст запитами після завантаження, наприклад каталогів і відгуків.
Налаштування · Сканування — документація (англійською)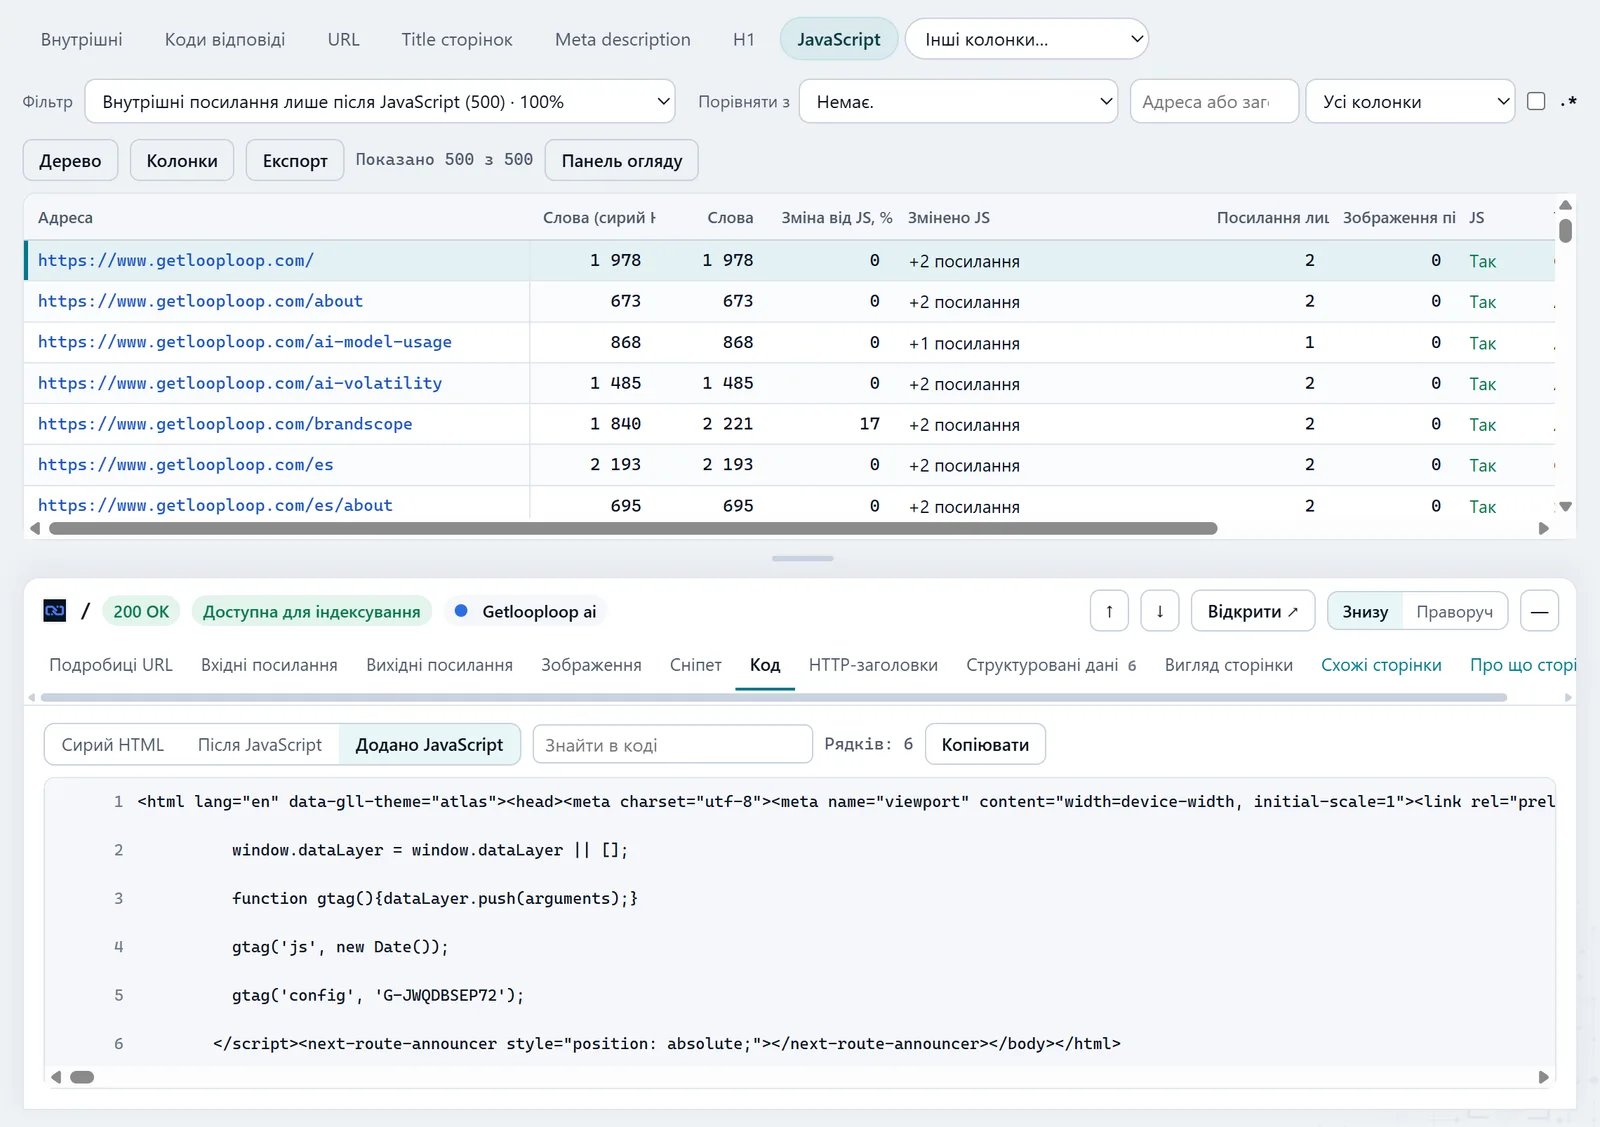
На знімку: Вкладка JavaScript Знайдіть текст, якого немає в HTML
У вкладці JavaScript фільтр «Текст лише після JavaScript» показує сторінки, де сирий HTML майже порожній, а після рендеру текст є. «JavaScript змінює текст понад 20%» знаходить сторінки, де HTML і відрендерена версія суттєво розходяться. Колонки «Слова (сирий HTML)» і «Зміна від JS, %» кажуть, наскільки. Фільтр «Зображення, що з'являються лише після прокручування» знаходить зображення, адресу яких скрипт вписує, лише коли вони потрапляють у видиму область, без запасного варіанта в HTML.
JavaScript — документація (англійською)На знімку: Вкладка JavaScript Перевірте, що JavaScript змінює в head
Найнебезпечніше — коли JavaScript переписує сигнали для індексу. Фільтри «Canonical змінюється після JavaScript», «Meta robots змінюється після JavaScript», а також title, H1 і description показують такі сторінки, а колонка «Canonical: HTML → JS» — обидва значення. Google пише, що noindex у сирому HTML може зупинити рендеринг, тож прибрати його скриптом не вийде. Поруч фільтр «Внутрішні посилання лише після JavaScript»: такі посилання пошуковик бачить лише після рендеру.
JavaScript — документація (англійською)На знімку: Вкладка JavaScript Відкрийте одну сторінку в трьох видах
В інспекторі сторінки панель джерела має три вкладки: «Сирий HTML», «Після JavaScript» і «Додано JavaScript». Остання показує лише те, чого в HTML не було, — це конкретний фрагмент, який треба віддавати з сервера.
Інспектор сторінки — документація (англійською)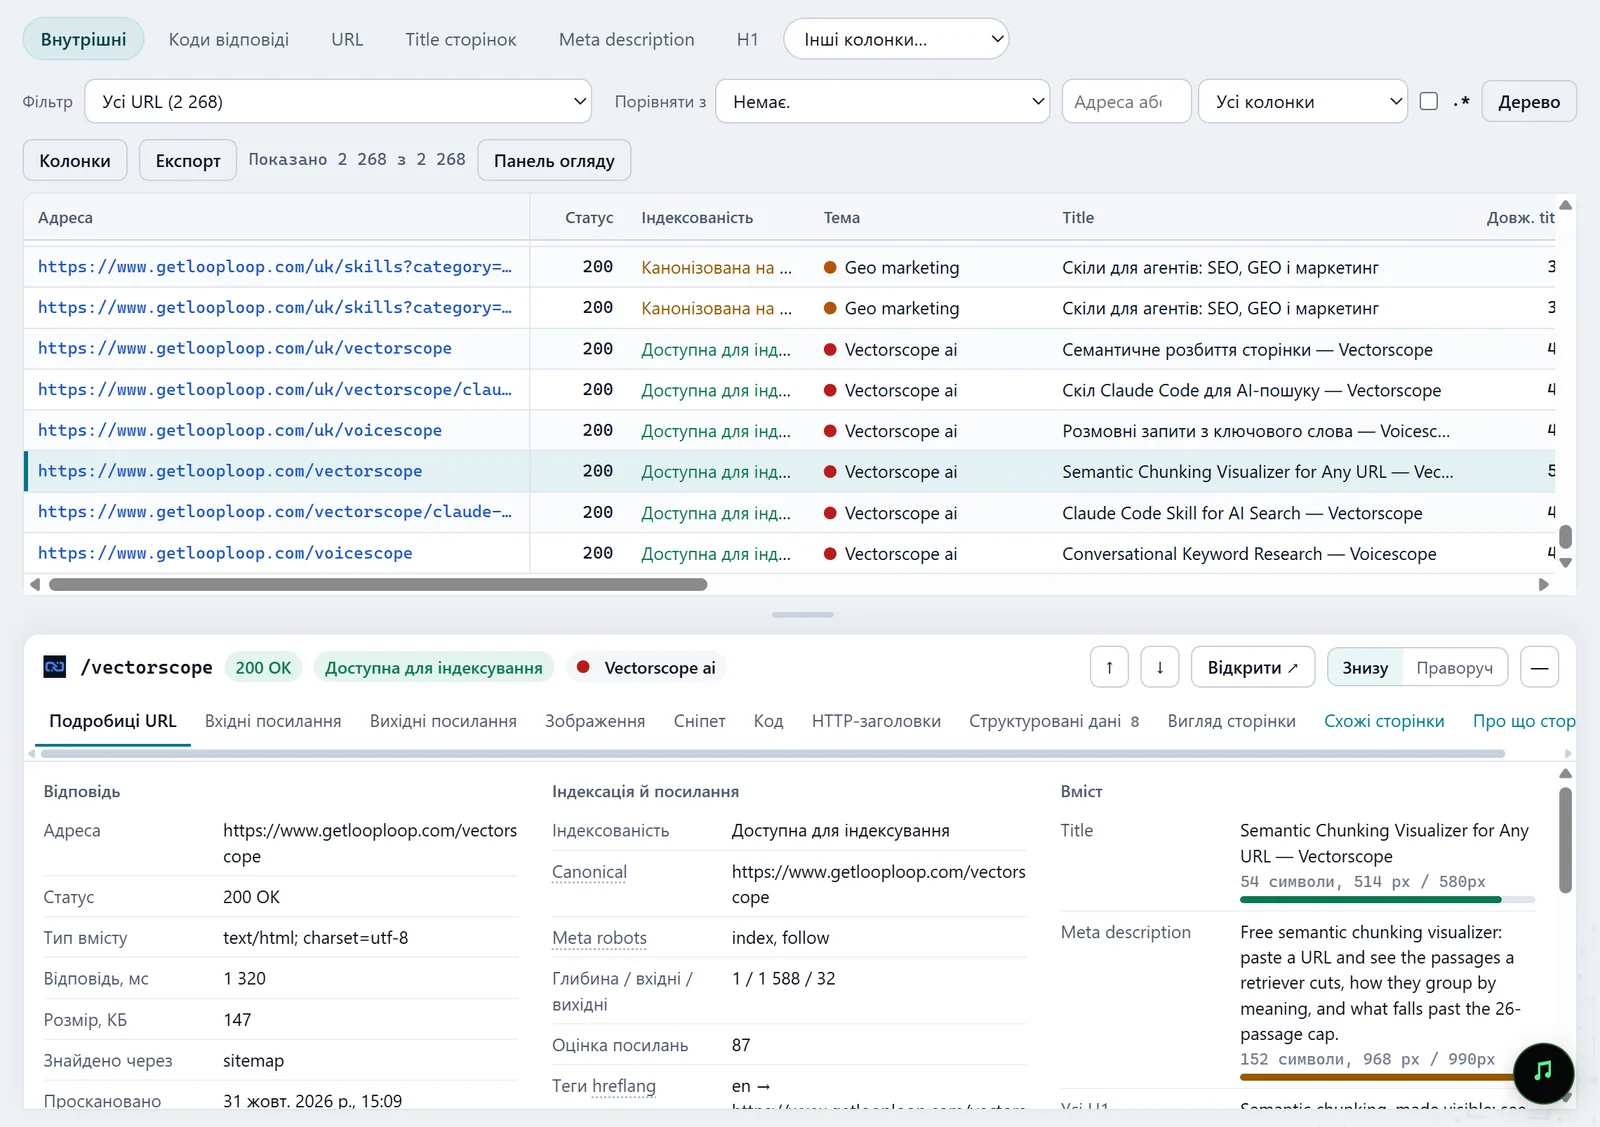
На знімку: Таблиця всіх сторінок з інспектором Перевірте після релізу
Коли сервер почне віддавати текст, canonical і посилання в HTML, проскануйте з тими самими налаштуваннями й порівняйте в «Історії»: сторінки мають зникнути з фільтрів вкладки JavaScript.
Історія — документація (англійською)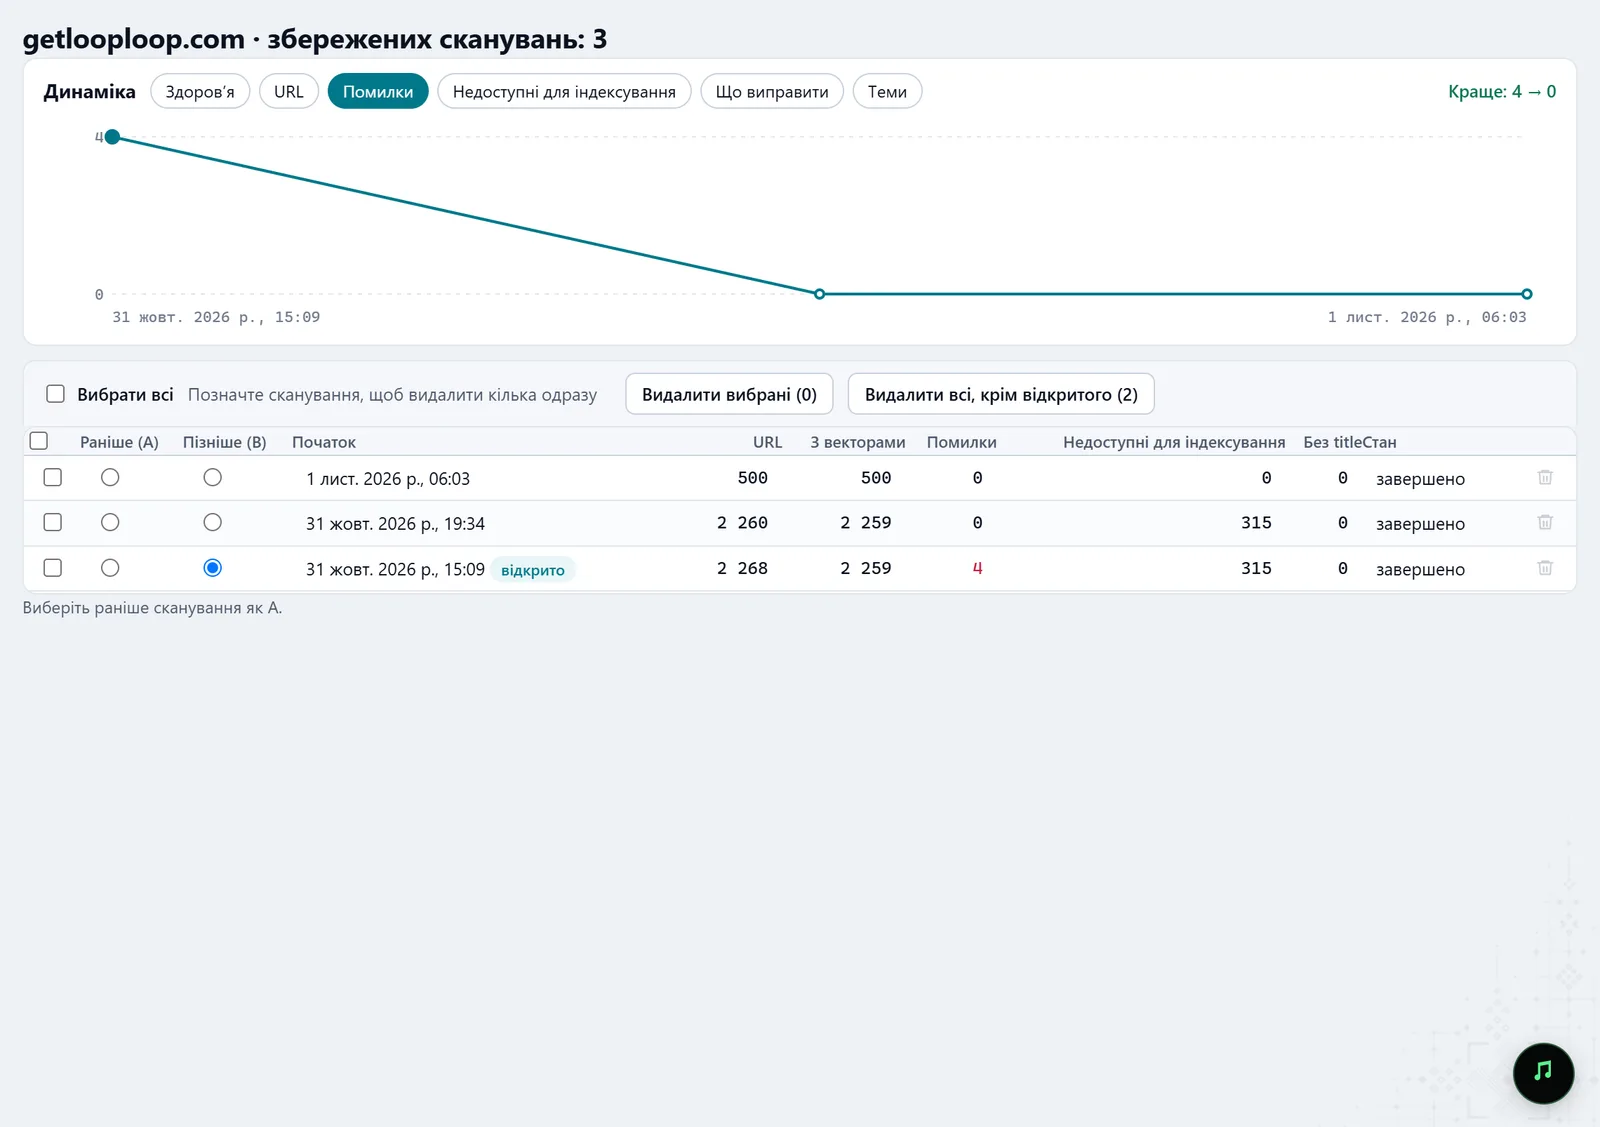
На знімку: Історія сканувань
Що ви отримаєте
Сторінки, порожні без JavaScript
Список сторінок, текст яких існує лише після рендеру, зі словами до і після.
Сигнали, які змінює JavaScript
Canonical, meta robots, title, H1 і description, що в HTML одні, а після рендеру інші.
Посилання й зображення для сервера
Внутрішні посилання, що з'являються лише після JavaScript, зображення без запасного варіанта в HTML і фрагменти, які варто рендерити на сервері.
Що варто знати
- Molfar рендерить сторінки власним вбудованим Chromium. Google теж рендерить у Chromium, але з власними обмеженнями часу й ресурсів, тож результат близький, а не однаковий.
- У режимі «Авто» порівнюються лише сторінки, які були відрендерені; повне порівняння дає режим «Усі сторінки».
- Прокручування для пошуку зображень відбувається лише на відрендерених сторінках: на сторінці без рендеру такі зображення не шукаються. Вбудований loading="lazy" — це нормально, і його не рахують.
- Рендеринг помітно повільніший за читання HTML; на великому сайті почніть зі зразка розділів.
Питання
- Який режим обрати для SPA?
- «Усі сторінки» і «коли ще й мережа затихла» в «Читати відрендерену сторінку»: так кожна сторінка буде прочитана двічі і з контентом, що приходить запитами.
- Чи можна перевірити одну сторінку без сканування?
- Так, URL audit показує, чи змінює JavaScript сторінку, разом з рештою перевірок для однієї адреси.
- Агент може це перевірити?
- Так. Через MCP можна почати сканування з потрібним режимом рендерингу, а аудит однієї адреси повертає обидві версії сторінки.