

AI Search Audit Full: SEO-аудит, який цитує свої правила
Безкоштовна відкрита Agent Skill, що перевіряє одну сторінку або до 50 сторінок для Google, Bing і ШІ-асистентів і підкріплює кожну знахідку правилом, процитованим із джерела. Ми запустили її на власному сайті; ось що вона знайшла і як це читати.
Переклад з англійського оригіналу.
Коротка відповідь
- what
- AI Search Audit Full 2.111, відкрита Agent Skill: 122 коди проблем, перевірені за 83 дослівними цитатами правил і 39 правилами, які вона позначає як власні, карта відповідей, теплова карта, звіт по сайту до 50 сторінок, порівняння «до і після» та локальна історія.
- why
- Бо знахідка аудиту корисна рівно настільки, наскільки зрозуміла її причина. Список проблем без опублікованого правила запрошує до суперечки; список із процитованим правилом і посиланням на нього запрошує до виправлення.
- who
- SEO-фахівці, яким на кожну знахідку треба відповісти «хто це сказав?», власники контенту, чиї сторінки мають цитувати ШІ-асистенти, і розробники, яким дістаються завдання на виправлення.
- where
- На GitHub за ліцензією MIT. Працює в Claude Code, Codex, opencode, Hermes Agent та інших агентах, що завантажують навички SKILL.md, або архівом у claude.ai і застосунку Claude.
- when
- Випущена 18 жовтня 2026 року. Наведений тут приклад аудиту прочитав три сторінки getlooploop.com наживо 17 жовтня 2026 року; цитати правил звірено з їхніми сторінками того самого дня.
- how
- Зібрані скрипти Node завантажують, читають і перевіряють сторінки без жодного виклику моделі чи ембедингів; частини-судження пише агент, що запускає навичку, і звіт підписує їх назвою його моделі. Нічого не надсилається в GetLoopLoop.
Просте пояснення
Щоб Google чи ШІ-асистент показав вашу сторінку, мають збігтися три речі: пошукового робота мають впустити, сторінка має чітко казати, що вона таке, а слова мають пережити те, як робот їх читає. Цей безкоштовний інструмент перевіряє всі три на вашому комп’ютері й складає список того, що пішло не так. Про кожну проблему він каже простими словами, що не так; потім переписує точне речення з правил Google чи іншого офіційного джерела, яке пояснює чому; а потім підказує, як це виправити. Він може перевірити одну сторінку або п’ятдесят і пам’ятає минулі перевірки, тож наступного разу скаже, що стало краще.
Більшість аудитів закінчуються суперечкою. Інструмент каже, що зі сторінкою проблема, хтось питає, хто так сказав, а у відповідь — бал або думка постачальника. AI Search Audit Full зроблено навпаки. Кожна проблема, про яку вона повідомляє, несе правило, на якому тримається, процитоване слово в слово з джерела, що його опублікувало, з посиланням і датою перевірки цитати. Там, де правила ніхто не публікує, вона каже, що поріг її власний.
Ми представили цю навичку поруч із Vectorscope і Lite у статті ШІ читає сторінку шматками. Три безкоштовні навички показують, якими. Тут ідеться лише про Full, версії 2.111: що вона перевіряє, що знайшла на нашому власному сайті, які чотири речі додала після тієї статті і де її межі.
Що вона перевіряє
Щоб Google, Bing чи ШІ-асистент міг показати або процитувати сторінку, мають виконуватися три умови. Краулера мають впустити — robots.txt і власні теги robots сторінки. Сторінка має казати, що вона таке: заголовок, опис, canonical, структуровані дані, мовні версії. А текст має пережити машинне читання: що залишить чистильник, як текст поріжуть на уривки і що випаде за межу, на якій ретривер перестає читати.
Full перевіряє всі три умови за опублікованими правилами, а тоді додає три прочитання, які може зробити лише ШІ: питання, які люди поставили б про сторінку, як власна модель агента описує бренд і що вона вважає про відгуки на нього. Ці прочитання всюди позначено як оцінку моделі, з назвою моделі.
Приклад у репозиторії — аудит трьох сторінок getlooploop.com: сторінки Vectorscope англійською, українською та іспанською, прочитаних наживо 17 жовтня 2026 року.
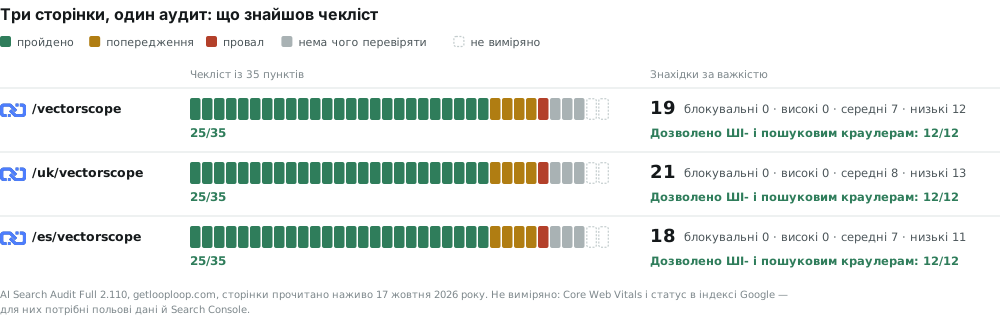
Спершу головне, бо заради цього аудит і запускають: ніщо не блокує ці сторінки. Усі дванадцять краулерів, яких перевіряє навичка, від Googlebot і Bingbot до OAI-SearchBot, Claude-SearchBot і PerplexityBot, мають доступ. Жодна знахідка не блокувальна і не висока. На кожній сторінці 25 із 35 пунктів чекліста пройдено без зауважень.
Єдиний провалений пункт — корисного ґатунку. Перевірка неробочих посилань знайшла в блоці «Читати далі» два посилання, що ведуть на сторінки 404: /notes/what-is-semantic-chunking і /notes/optimise-content-for-ai-search, на всіх трьох мовних версіях. Ми цього не помітили. Обидві статті були в планах, але так і не з'явилися; 23 жовтня, пишучи цей текст, ми спрямували блок на статті, які існують. Аудит, що знаходить щось справжнє на сторінках власних авторів і доводить це до виправлення того ж дня, робить свою роботу.
Кожна проблема приходить зі своїм правилом
Кожна знахідка у звіті Full розгортається на три шари, написані для трьох читачів.
Що не так — для менеджера чи початківця: прості слова, без порад. Для неробочих посилань: «Посилання на сторінці ведуть на сторінку помилки. Люди, які переходять за ними, потрапляють у глухий кут, а пошукові системи вилучають такі адреси зі свого індексу».
Що каже правило — для того, хто питає «хто це сказав?»: коротка цитата з офіційного джерела, посилання і дата перевірки. Для цієї самої знахідки навичка цитує сторінку Google про коди стану HTTP:
У випадку Пошуку Google Google не індексує URL-адреси, що повертають код стану 4xx, а вже проіндексовані URL-адреси, що повертають код стану 4xx, вилучаються з індексу.
Google Crawling Infrastructure, HTTP status codes; цитата з навички, перевірена 17 жовтня 2026 року (переклад з англійської)
Напрям виправлення — для розробника, стисло й технічно, згорнутий у «Подробиці для фахівців», щоб ніколи не тіснити простий шар: «Оновіть або приберіть href, що повертають 4xx чи 5xx; для перенесених цілей налаштуйте 301 на нову адресу».
Так само пояснено й знахідки, які зовсім не є помилками. Сторінки мають розмітку FAQPage, і аудит позначає це як низьку важкість: розмітка «не шкодить, але вже не дає розширеного результату, заради якого її колись додали», бо, словами, які навичка цитує з журналу оновлень документації Google, «розширений результат FAQ більше не показується в результатах Пошуку Google». Напрям виправлення чесно лишає вибір: для Google нічого не потрібно; залиште, якщо її читає інший споживач, або приберіть, щоб полегшити сторінку.
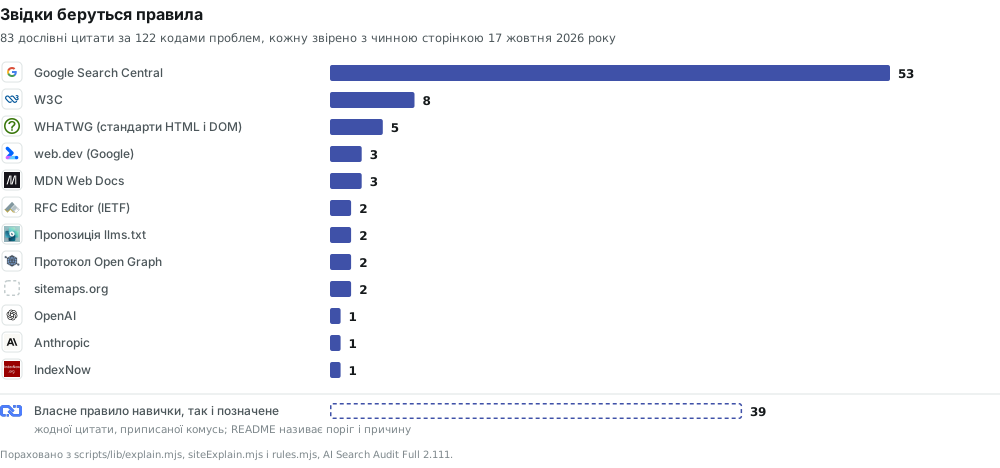
Якщо порахувати за власною таблицею правил навички (explain.mjs і rules.mjs), 122 коди проблем спираються на 83 цитати і 39 власних правил. Google Search Central дає 53 цитати, чого й варто чекати від аудиту для пошуку. Решта — від організацій зі стандартів (W3C, WHATWG, RFC 9309 від IETF для robots.txt), MDN і власних сторінок ШІ-компаній про краулери: цитата OpenAI — саме та, від якої залежить, чи може сайт узагалі з’явитися в пошукових відповідях ChatGPT.
39 власних правил важать не менше, ніж 83 цитати. Уривок, що починається з середини речення; розділ, тонший за поріг навички; llms.txt, що перелічує одну мову на сайті з трьома: для цього ніхто не публікує правил, тож звіт пише «Правило цієї навички», а README називає поріг. Нічого не приписано Google, чого Google не писав. І цитати — не знімок, зроблений раз: npm run verify-rules знову завантажує кожне джерело й звіряє кожну цитату слово в слово.
Карта відповідей: на які питання сторінка може відповісти
Нове після нашої першої статті: карта відповідей зводить в одну таблицю питання, які люди поставили б про сторінку, — чи відповідає на кожне сторінка, якість зі 100 і чого бракує. Питання й вердикти — судження агента; якість — фіксована сума, яку рахує скрипт, тож ті самі файли завжди дають те саме число. Повна відповідь дає 50, часткова — 25; відповідь, яку можна процитувати окремо, — ще 25; відповідь на початку свого уривка, що її вимірює скрипт, — останні 25. Часткова відповідь ніколи не сягне 100.
Спробуйте на власній сторінці
Подивіться, що Voicescope знайде на вашій сторінці
Усе, що написано вище, можна зміряти на власній роботі, і перевірка займає близько хвилини. Вставте одну адресу і прочитайте, що повернеться.
Відкрити VoicescopeБезкоштовно · без акаунта · по одній за раз
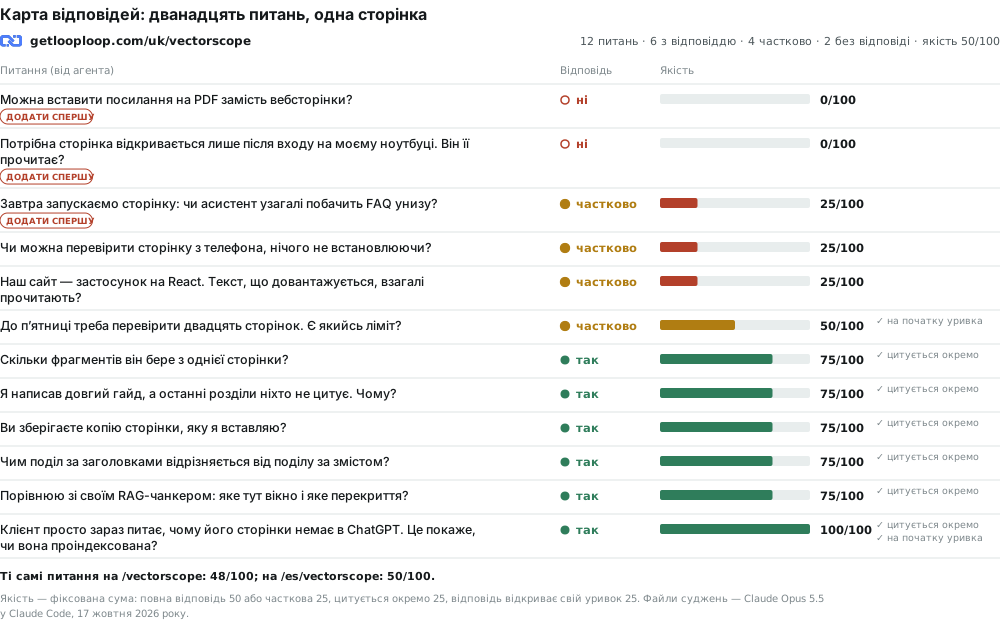
Якщо читати знизу, сторінка в доброму стані: половина з дванадцяти питань отримує повну відповідь, яку можна процитувати окремо, а одне — «чи скаже це, чи сторінку проіндексовано?» — отримує ідеальну відповідь на початку свого уривка: «Це не доводить, що будь-який асистент проіндексував сторінку». Якщо читати згори, це бриф для автора. Ніщо на сторінці не каже, чи спрацює посилання на PDF і що буде зі сторінкою за входом, а питання дня запуску про FAQ нижче межі має лише часткову відповідь. Три позначки «додати спершу» — це три наступні абзаци, які варто написати, уже впорядковані.
Якість навмисно сувора. П’ять повних відповідей зупиняються на 75, бо відповідь стоїть посеред уривка, а не на його початку. Асистенти цитують уривки, і найімовірніше процитують перше речення уривка, тож бал винагороджує відповідь, що стоїть першою.
Тепло: де на сторінці сидять проблеми
Список із дев’ятнадцяти знахідок не каже, з чого почати. Карта сторінки каже: вона малює сторінку як схему, від <head> і robots.txt до підвалу, і прикріплює кожну знахідку до місця, де її знайдено. Від 2.111 кожне місце ще й затінено теплом — його знахідки, зважені за важкістю (блокувальна 8, висока 4, середня 2, низька 1), відносно найгарячішого місця. Сітку сторінок і проблем у звіті по сайту затінено так само.
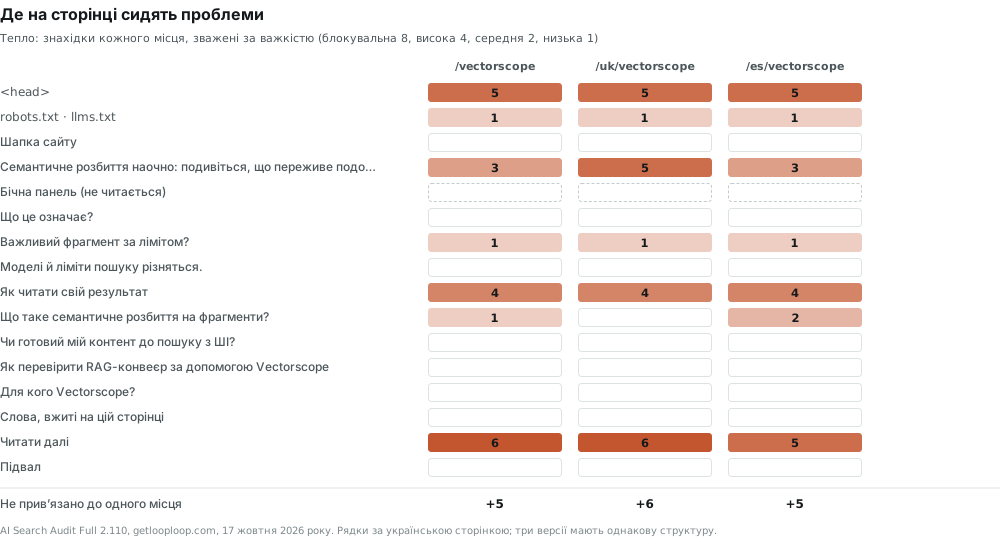
Картина водночас заспокійлива і конкретна. Дев’ять чи десять із чотирнадцяти місць на кожній сторінці не мають жодної знахідки. Тепло зосереджене в трьох: блок «Читати далі» внизу (неробочі посилання, уривок із середини речення, повторювана будова речень, часткова відповідь), <head> (бракує обов’язкового поля в структурованих даних, два розширені результати, яких більше немає, вага сторінки) і розділ «Як читати свій результат», достатньо довгий, щоб його розрізало посеред речення. Три виправлення, у трьох відомих місцях, на трьох сторінках з одного шаблону: одне завдання, а не дев’ятнадцять.
Перший екран української сторінки — єдине місце, де мовні версії відрізняються: тут 5, а деінде 3, бо перевірка ключової фрази знайшла, що головна фраза української сторінки зосереджена в небагатьох розділах. Саме такі відмінності й показує звіт по сайту.
Наскільки текст звучить як згенерований
Від 2.109 унизу кожного звіту про сторінку є блок «Наскільки текст звучить як згенерований». Він ставить поруч три прочитання: бал шаблонності за шаблонами письма (заяложені фрази й повторювана будова речень, пораховані з позиціями), слова, які мовні моделі відомо надуживають, і тест підміни від агента — вердикт для кожного уривка, чи можна вставити його на сторінку конкурента без змін. Де агент і скрипт не згодні, показано обидва, ніколи не усереднено. Це не детектор авторства, і блок так і каже.
| Сторінка | Бал шаблонності | Слова-маркери | Загальні уривки (тест підміни) |
|---|---|---|---|
| /vectorscope | 1 зі 100 | 0 | 4 із 17 |
| /uk/vectorscope | 2 зі 100 | 0 | 4 із 17 |
| /es/vectorscope | 0 зі 100 | 0 | 5 із 18 |
Низькі бали всіма трьома мовами і жодного слова-маркера. Уривки, які тест підміни називає загальними, — це застереження («Це не доводить, що будь-який асистент проіндексував сторінку») і абзац «для кого це»: речення, які могла б мати сторінка будь-якого інструмента, і це слушна примітка для редактора. Цінність — у позиціях: кожен сигнал вказує на уривок і слово, тож рецензент перевірить твердження за секунди, а не повірить на слово.
Історія, що переживає чат
Кожен запуск зберігається як знімок, а кожен звіт показує, що змінилося від попереднього: заголовок, опис, canonical, h1, кількість слів, типи схеми, robots.txt і кожен бот, hreflang, уривки нові, втрачені й змінені, знахідки виправлені, нові й незмінні. Від 2.110 історія живе у власній теці користувача, ~/.ai-search-audit/history, яку не скидає ні новий чат, ні нова робоча тека, ні нова версія навички. А оскільки пісочниця чату, як-от claude.ai, може забути свій диск, кожен звіт ще й несе всю історію в собі: --history-from report.html повертає її під час наступного запуску.
Закомічений приклад показує, як уважно читається зміна. Перший запуск /vectorscope, 16 жовтня, читав збережену копію і знайшов 18 проблем; живий запуск 17 жовтня знайшов 19. Нічого не погіршилося. Збережений файл не має HTTP-заголовків відповіді, тож перший запуск позначив перевірку заголовків безпеки як не виміряну; живий запуск виміряв її і знайшов, що бракує трьох заголовків. Зміна фіксує, що кількість слів зросла з 2463 до 2469 і що змінився рівно один із 17 уривків. /es/vectorscope, прочитана наживо двічі з різницею менш як у хвилину, показує 18 і 18 і жодних змін — саме те, що має сказати стабільний аудит.
Що змінилося після 2.106
П’ять випусків за два дні, з історії комітів репозиторію:
| Версія | Дата | Що додано |
|---|---|---|
| 2.107 | 17 жовт. 2026 | Знак GetLoopLoop у фірмовому синьому |
| 2.108 | 17 жовт. 2026 | Відмова перевіряти російський домен, російський хостинг або сторінку, що оголошує російськомовну версію |
| 2.109 | 18 жовт. 2026 | «Наскільки текст звучить як згенерований»; звіти польською |
| 2.110 | 18 жовт. 2026 | Історія переживає чат, теку і версію |
| 2.111 | 18 жовт. 2026 | Карта відповідей; тепло на карті сторінки й матриці сайту; синхронізовано Vectorscope 2.111 |
Встановлення і запуск
Навичці потрібен Node 20.18 або новіший і жодного npm install: скрипти вже зібрано. Для Claude Code склонуйте репозиторій і скопіюйте теку навички до своєї теки навичок (Codex, opencode і Hermes Agent беруть ту саму теку у своїх шляхах, перелічених у README):
gh repo clone Olexan-art/ai-search-audit-full
mkdir -p ~/.claude/skills
cp -r ai-search-audit-full/skills/ai-search-audit-full ~/.claude/skills/
Потім попросіть агента звичайними словами: «AI search audit для https://example.com/page» або «перевір ці сторінки мого сайту». Для claude.ai і застосунку Claude завантажте ai-search-audit-full.zip із випусків репозиторію, увімкніть виконання коду і завантажте архів у Customize > Skills, не розпаковуючи його. Під капотом агент запускає два скрипти, а між ними пише власні файли суджень:
# одна сторінка
node dist/read.mjs https://example.com/page --out reading.json
# агент пише questions.json, style.json, brand.json і reviews.json
node dist/audit.mjs reading.json --questions questions.json --style style.json \
  --brand brand.json --reviews reviews.json --html report.html --json export.json

# сайт, щонайбільше 50 сторінок
node dist/read.mjs --sitemap https://example.com/sitemap.xml --out-dir readings
node dist/audit.mjs --site readings/site.json --questions-dir questions \
  --style-dir style --brand brand.json --reviews reviews.json --out-dir report

# до і після: додайте старіший експорт до команди для однієї сторінки
#   --compare old-export.json
Аудит сайту ввічливий за будовою: сторінки читаються по одній, щонайменше за секунду одна від одної, довше, коли robots.txt задає затримку, і лише там, куди robots.txt пускає. У прикладі на три сторінки пішов 81 запит, а ще на 39 відповіла пам’ять, бо robots.txt, sitemap і спільні посилання завантажуються один раз.
Чого вона не робить
- Не ставить сторінці бал. Знахідки, кожна зі своїм доказом і своїм правилом; ніколи не число зі 100 для сторінки загалом. Якість у карті відповідей рахується для кожного питання окремо.
- Без польових даних і статусу індексу. Core Web Vitals і «чи є це в індексі Google» завжди позначено як не виміряне: для них потрібні дані реальних користувачів і Search Console.
- Не передбачає, що відповідять асистенти. Прочитання бренду й відгуків — це знання однієї моделі, підписане її назвою. На наших сторінках модель, Claude Opus 5.5, не знала GetLoopLoop, і аудит саме так і каже.
- Не краулер усього сайту. Щонайбільше 50 сторінок; перевірки по сайту бачать лише перевірений набір, і звіт попереджає, що сторінка-сирота в ньому ще може мати посилання ззовні.
- Лише публічні сторінки. Без входу, без cookies, без приватних адрес і без рендерингу JavaScript, якщо його не попросити. Кожен ліміт названо у звіті, жоден не застосовано мовчки.
Що питають про AI Search Audit Full
AI Search Audit Full безкоштовна?
Так. Вона відкрита за ліцензією MIT і працює у вашому агенті на вашому комп’ютері. Нічого не надсилається в GetLoopLoop.
Чим Full відрізняється від AI Search Audit Lite?
Full виконує кожну перевірку Lite і додає до кожної проблеми просте пояснення, процитоване правило й напрям виправлення, перевіряє до 50 сторінок зі звітом по сайту, порівнює запуски і веде локальну історію.
Вона викликає ШІ-модель чи API ембедингів?
Скрипти не викликають жодної моделі й жодного API ембедингів. Частини-судження, як-от питання і прочитання бренду, пише агент, що запускає навичку, і звіт підписує їх назвою його моделі.
Звідки беруться правила?
83 правила процитовано слово в слово з їхніх джерел, 53 з них — з Google Search Central, кожне з посиланням і датою перевірки. 39 правил — власні правила навички, і їх так і позначено.
Чи може вона перевірити сторінку без доступу до мережі?
Так. Збережіть сторінку як HTML і, якщо можете, її robots.txt та дайте обидва файли агентові; кожну перевірку, якій потрібна мережа, буде позначено як не виконану.
Висновок
На трьох справжніх сторінках аудит зробив те, що має робити аудит. Він зняв, із доказами, те, що могло б бути серйозним: усі краулери мають доступ, жодних блокувальних чи високих знахідок, 25 із 35 перевірок пройдено. Він знайшов справжню ваду, яку пропустили власні автори, — два мертві посилання — і пояснив її реченням, яке прочитає менеджер, правилом, яке перевірить фахівець, і виправленням, яке застосує розробник. Він перетворив дванадцять питань на впорядкований список із трьох абзаців, які варто написати, а дев’ятнадцять знахідок — на три гарячі місця в одному шаблоні. І кожне з цих тверджень можна перевірити: правила — за їхніми джерелами, числа — за файлами в репозиторії.
Ось чому її варто запускати перед публікацією і ще раз після виправлень. Встановіть її з GitHub, спрямуйте на сторінку, що важить найбільше, і прочитайте першу знахідку. Решта налаштувань — на сторінці Agent Skills для SEO, GEO і маркетингу, а те, що асистенти насправді кажуть про ваш бренд, виміряне впродовж тижнів, а не один раз, — це те, для чого існує GetLoopLoop. Більше про те, як ШІ-пошук обирає джерела, — у глосарії: AI Overviews і генеративна пошукова оптимізація.
Продукт
Стежте за кожною сторінкою щодня
Одне зчитування каже, де сторінка стоїть сьогодні. Продукт ставить ті самі питання тим самим асистентам постійно — тож про зміну вам повідомляють, а не ви йдете її шукати.
Попросити запрошенняЗа запрошеннями, поки ми тримаємо зчитування чесними
На цю тему
Чи готова моя сторінка до пошуку зі ШІ?
Щодня Краулінг із прочитанням Vectorscope біля кожної сторінки і повторна перевірка після кожного виправлення. Як працює продукт
Автор
Olexandrавтор
15+ років у маркетингу та SEO. Десятки продуктів, переважно американський ринок. Дослідження і заміри.
LinkedInPass it on
Read in your language
Opens a browser translation of this English article. The original source stays in English.