GLLmolfar 0.9.36: студія контенту і вбудовані моделі, що працюють на ноутбуці
Два експерименти в одному релізі: моделі Gemma 4, які завантажуються в застосунок і працюють без ключів та інтернету, і студія, що пише сторінки, статті й листи з ваших фактів. Виміряно на одному ноутбуці — зі скриншотами, часом і кожним вигаданим реченням, яке ми спіймали.
Переклад з англійського оригіналу.
Коротка відповідь
- what
- Дві експериментальні функції 0.9.36: вбудовані моделі Gemma 4 (завантажити, перевірити, видалити, для всіх задач) і студія контенту для шести видів сторінок з одинадцятьма дизайнами, перевірками без моделі й однією точковою правкою.
- why
- Обхід закінчується списком сторінок, які треба написати чи переписати. Досі для цього потрібен був акаунт у сервісі моделей; малі відкриті моделі стали достатньо добрими для чернеток, якщо слабкі місця бере на себе застосунок.
- who
- Ті, хто сканує сайти в GLLmolfar і хоче чернетки з того, що знайшов обхід, на власному комп'ютері.
- where
- На комп'ютері людини. Виміряно на ноутбуці з AMD Ryzen 9 8945HS, вбудованою графікою Radeon 780M і 28,8 ГБ пам'яті.
- when
- GLLmolfar 0.9.36 для Windows і Mac, реліз 11 листопада 2026 року; усі виміри зроблено того самого дня.
- how
- Шість локальних моделей на задачах самого застосунку; вбудована перевірка на Gemma 4 12B; шість видів сторінок, згенерованих по-старому і через студію, з заміром часу та читанням рядок за рядком.
Просте пояснення
GLLmolfar тепер уміє завантажити невелику ШІ-модель і запустити її просто на вашому комп'ютері, тож писати можна без жодного іншого акаунта. Вона повільніша за великих платних асистентів і частіше помиляється — застосунок чесно пише це в червоній рамці. А ще є нова студія: ви даєте факти про свій магазин чи сайт, і вона робить сторінку, статтю або лист. Модель пише лише слова; сторінку малює застосунок і перевіряє, що нічого не вигадано.
У GLLmolfar 0.9.36 дві нові частини, обидві позначені як експеримент і обидві доступні лише застосункам, у яких виконано вхід. Перша запускає ШІ-модель усередині застосунку: ви завантажуєте її один раз, і далі вона відповідає на вашому комп'ютері — без ключа, без акаунта деінде і без інтернету. Друга — студія контенту: вона перетворює факти, які ви їй даєте (каталог, знахідки обходу), на сторінку, статтю або HTML-лист.
Ця стаття показує обидві частини і міряє обидві. Усе запускали 11 листопада 2026 року на звичайному ноутбуці: AMD Ryzen 9 8945HS з вбудованою графікою Radeon 780M і 28,8 ГБ пам'яті, без окремої відеокарти. GLLmolfar — наш застосунок, тож читайте з урахуванням того, чий це інструмент; числа ті, що ми отримали, разом із тими, які йому не лестять.
Вбудовані моделі
«Налаштування › ШІ-моделі» тепер відкриваються розділом «Вбудовані моделі на цьому комп'ютері». Він показує знайдені пам'ять, відеокарту й вільне місце на диску і пропонує три моделі, кожну на окремій картці. Перше натискання завантажує ще й рушій — llama.cpp, близько 40 МБ, — який працює через Vulkan на Windows (графіка AMD, Intel і NVIDIA, зокрема вбудована) і через Metal на Apple Silicon. Якщо відеокарта не тягне модель, застосунок переходить на процесор і запам'ятовує це.
Завантаження можна зупинити й продовжити з того самого місця, а готовий файл звіряється з опублікованим розміром і SHA-256, перш ніж застосунок його використає. «Видалити» прибирає файл моделі; разом з останньою моделлю видаляється й рушій, тож у теці нічого не лишається.
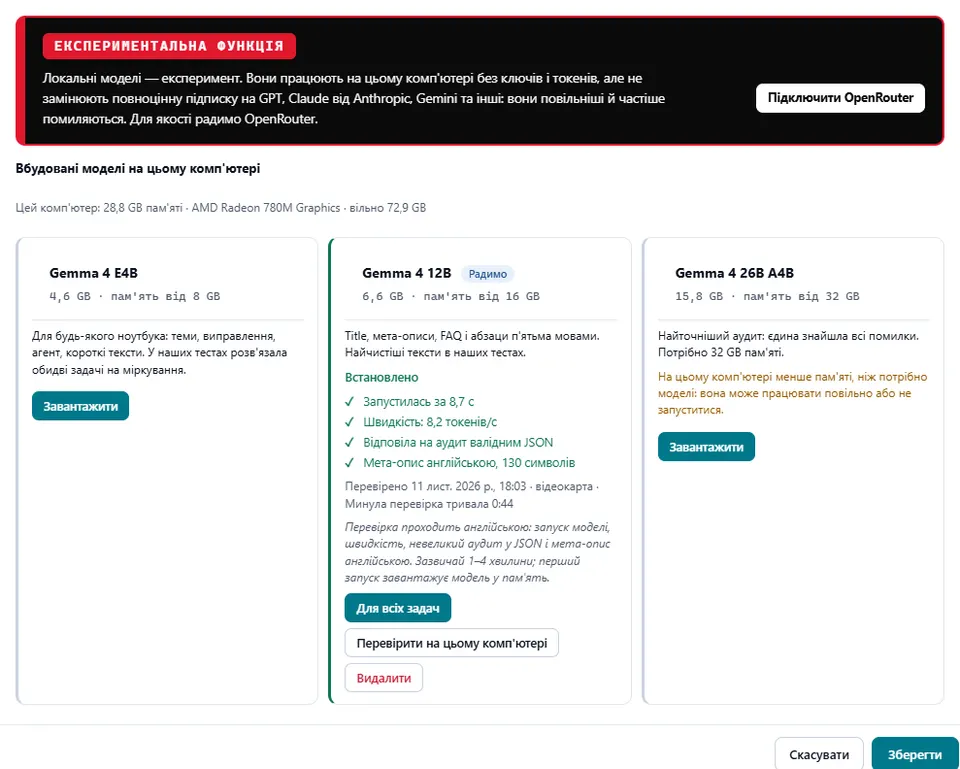
Червоно-чорна рамка вгорі стоїть навмисно і нікуди не зникає. Локальні моделі повільніші за великі хмарні й частіше помиляються; вони не замінюють підписку на GPT, Claude чи Gemini, і для роботи, де важлива точність, ми радимо підключити модель через OpenRouter — це одна кнопка в тій самій рамці. Вбудовані моделі — для чернеток, для роботи, яка не має покидати комп'ютер, і для того, щоб спробувати ШІ-функції застосунку, перш ніж вирішувати щось інше.
«Для всіх задач» одним натисканням ставить встановлену модель на всі вісім ШІ-ролей застосунку — теми, виправлення, аудит, запити до сторінок, агент, контент, перевірки й дописи для соцмереж — замість вибору в кожному списку окремо. Модель, яка пройшла «Перевірити на цьому комп'ютері», ще й ставиться на кожну роль, де моделі поки немає, не чіпаючи ролей, які ви вже налаштували інакше.
| Модель | Завантаження | Потрібна пам'ять | Для чого |
|---|---|---|---|
| Gemma 4 E4B | 4,6 ГБ | 8 ГБ | Будь-який ноутбук: теми, виправлення, агент, короткі тексти |
| Gemma 4 12B | 6,6 ГБ | 16 ГБ | Title, мета-описи, FAQ і абзаци п'ятьма мовами; радимо від 16 ГБ |
| Gemma 4 26B A4B | 15,8 ГБ | 32 ГБ | Найточніший аудит; потрібно 32 ГБ |
Чому Gemma 4: шість моделей на задачах застосунку
Перш ніж обрати, що вшити, ми прогнали шість сучасних відкритих моделей одним скриптом на тому самому ноутбуці — раз на процесорі, раз на вбудованій графіці. Задачі ті, які застосунок справді дає моделі: аудит восьми сторінок із сімома закладеними помилками, відповідь у JSON; title і мета-опис англійською, українською, іспанською, французькою і польською в межах довжини; дві невеликі задачі на міркування; і виклик інструментів у два кроки. Цей прогін ішов через Ollama, а не через рушій застосунку, тож його швидкості — для порівняння моделей між собою.
| Модель | Токенів/с, графіка (процесор) | Аудит, помилок із 7 | Вигадані помилки | Міркування, з 2 | Тексти в межах, з 5 мов |
|---|---|---|---|---|---|
| Gemma 4 E4B | 17,3 (10,1) | 4 · 8 с | 0 | 2 | 5 |
| Qwen3.5 4B | 19,1 (10,6) | 3 · 6 с | 0 | 2 | 2 |
| Qwen3.5 9B | 11,3 (6,3) | 2 · 9 с | 0 | 2 | 2 |
| Gemma 4 12B | 10,6 (9,6) | 6 · 16 с | 0 | 1 | 4 |
| Ministral 3 8B | 14,1 (6,6) | 5 · 20 с | 1 | 0 | 1 |
| Gemma 4 26B A4B | не запустилась (9) | 7 · 39 с | 0 | 2 | 2 |
Швидкість письма на вбудованій графіці, токенів за секунду
Аудит без міркування: знайдено закладених помилок із 7
Спробуйте на власній сторінці
Подивіться, що Voicescope знайде на вашій сторінці
Усе, що написано вище, можна зміряти на власній роботі, і перевірка займає близько хвилини. Вставте одну адресу і прочитайте, що повернеться.
Відкрити VoicescopeБезкоштовно · без акаунта · по одній за раз
Що вирішило:
- У Gemma 4 найкращі аудити. Gemma 4 12B знайшла 6 із 7 помилок за 16 секунд без міркування; 26B — усі 7. Ministral 3 8B знайшла 5 і одну вигадала. Qwen3.5 9B без міркування знайшла 2; з міркуванням — 6, але на це пішло 5,2 хвилини.
- Міркування надто повільне, щоб бути за замовчуванням. З ним Gemma 4 E4B, 12B і 26B теж дійшли до 6 із 7 — за 1,5, 2,3 і 3 хвилини. Застосунок просить відповідей без нього.
- Швидкість — не те вузьке місце, яким здається. Qwen3.5 4B писала найшвидше, 19,1 токена/с, але вклалася в межі лише у 2 текстах із 5 і плутала, про що сторінка.
- Тексти: Gemma 4 E4B вклалася в межі всіма п'ятьма мовами, Gemma 4 12B — чотирма; при читанні вручну тексти 12B граматично чисті всіма п'ятьма, тон трохи рекламний. Моделі Qwen і Ministral не вклалися в межі більшістю мов, а Qwen3.5 9B радила видалити сторінки-сироти, хоча задача була пов'язати їх посиланнями.
Два результати однакові для всіх шести. Кожна модель правильно виконала виклик інструментів у два кроки. І в жодній українській відповіді жодної моделі немає російських літер — ми перевіряємо це механічно в усьому, що пише застосунок, бо модель, яку просять писати українською, може зісковзувати в російське написання.
Перевірка на цьому комп'ютері
Тест на нашому ноутбуці мало що каже про ваш, тому на кожній картці є «Перевірити на цьому комп'ютері». Вона запускає модель, міряє, як швидко та пише, просить невеликий аудит у JSON і мета-опис і показує кожен крок у міру виконання — з годинником і власним журналом рушія (скільки шарів пішло на відеокарту, що він вантажить), щоб довгий перший запуск не виглядав як зависання. Перевірка завжди йде англійською, незалежно від мови інтерфейсу, щоб результати можна було порівнювати між комп'ютерами; про це написано під кнопкою.
На тестовому ноутбуці Gemma 4 12B пройшла всі чотири кроки на відеокарті: запустилась за 8,7 с, писала 8,2 токена за секунду, повернула валідний JSON і англійський мета-опис на 130 символів; уся перевірка тривала 44 секунди. Найперший запуск, коли моделі ще не було в пам'яті, тривав 33 с. Це власний рушій застосунку, llama.cpp на Vulkan, тож його швидкість не порівнюється напряму з прогоном в Ollama вище.
Gemma 4 12B у застосунку: секунд до запуску
Студія контенту
Студія — новий розділ у лівій панелі, теж експериментальний. Вона робить шість речей: статтю, головну, список товарів, сторінку товару, сторінку альтернатив і HTML-лист. Ви вказуєте сайт чи бренд, пошуковий запит, для якого сторінка, аудиторію, мету, мову і — найважливіше — факти, які модель може використати. Пише та модель, що стоїть на ролі «контент»: вбудована, Ollama чи LM Studio на тому самому комп'ютері або хмарна через OpenRouter.
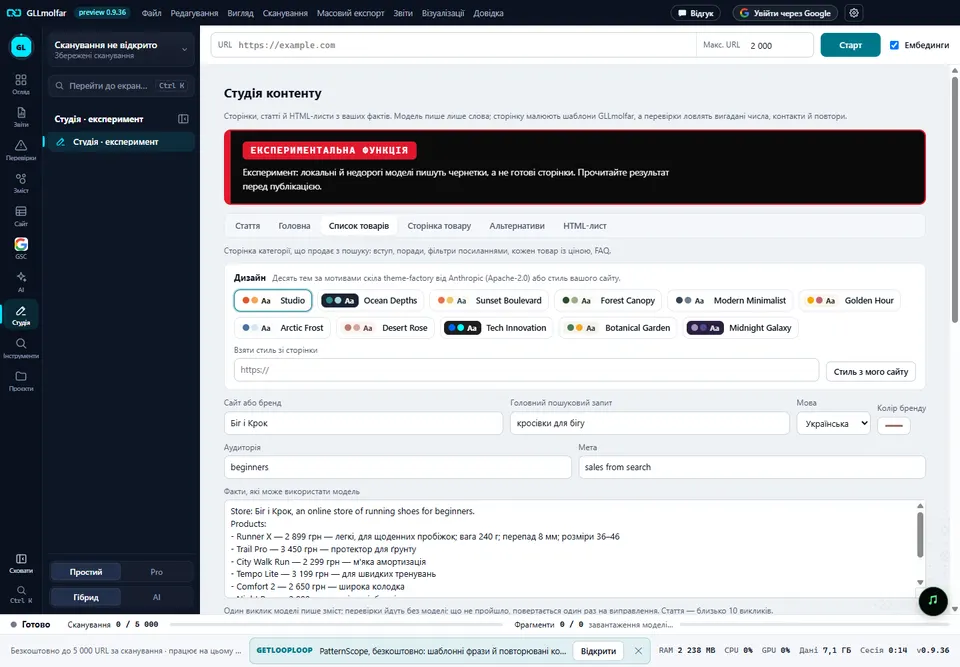
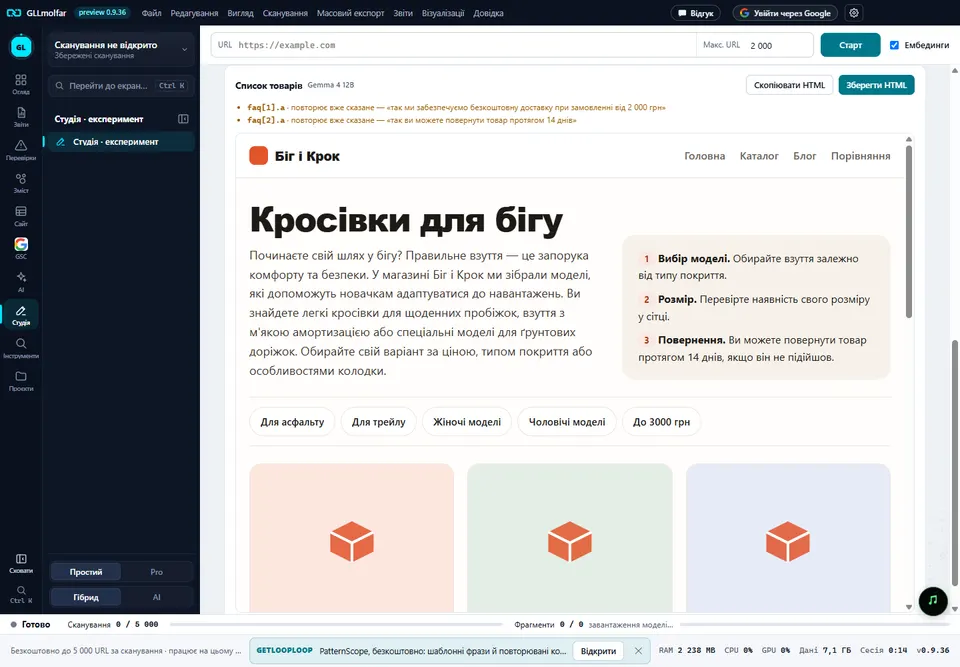
Головна зміна релізу — у тому, як це працює. Перша версія функції просила в моделі цілу HTML-сторінку, а малим моделям це вдається погано: дизайн гуляв від сторінки до сторінки, а у футер і текст потрапляло те, чого ніхто не давав. Тепер модель повертає лише зміст у JSON — заголовок, вступ, товари з підписами, FAQ, — а сторінку малюють шаблони GLLmolfar. Далі — перевірки, яким модель узагалі не потрібна:
- кожне число в тексті має бути у фактах («2 480» і «2,480» рахуються як одне число);
- кожен телефон, адреса пошти й рік мають бути у фактах;
- твердження про бізнес, яких немає у фактах, — «ми розробили», «наші спеціалісти», — позначаються;
- повтори знаходяться за спільними послідовностями з трьох слів;
- міряється довжина title і описів, а в українському тексті позначаються російські літери.
Знайдене повертається моделі один раз — як точкова правка лише цих полів, а не «перепиши все». Що лишилось неправильним, показується над результатом, тож чернетка приходить разом зі своєю перевіркою.
Статті мають ще один крок. Довгий текст, написаний малою моделлю за один виклик, губить лінію; написаний по розділах — кожен розділ повторює попередній. Студія пише план, потім кожен розділ, бачачи, що вже сказано, що буде далі і текст до цього місця, і наостанок FAQ.
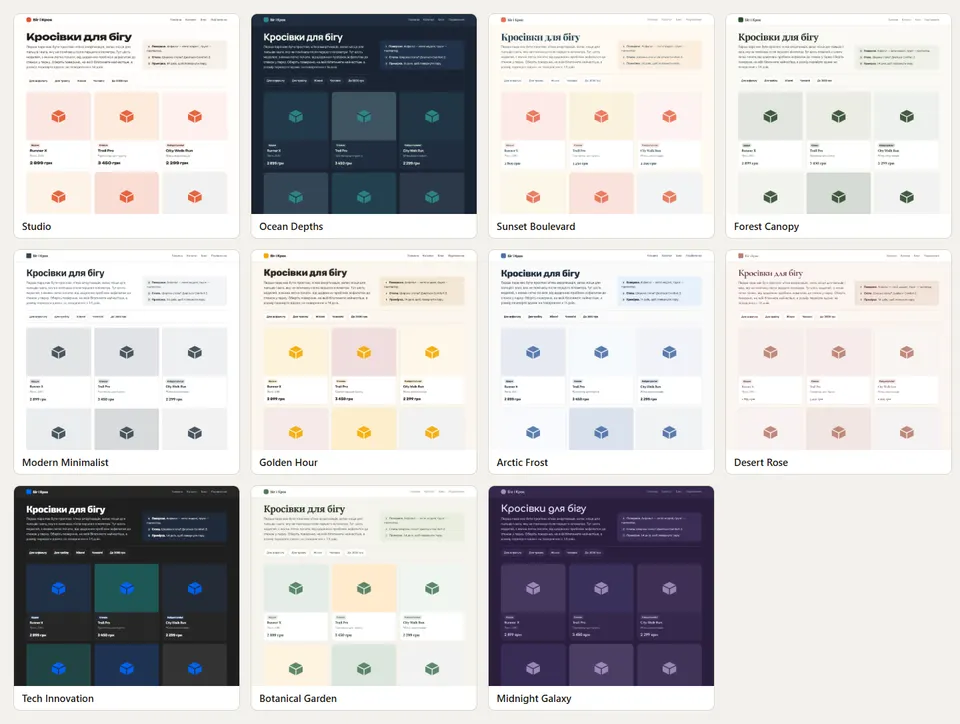
Дизайн — це вибір з одинадцяти тем. Одна — власна тема студії; десять адаптовано зі скіла theme-factory, який Anthropic публікує під Apache-2.0, зі шрифтами, що мають кирилицю. Або натисніть «Стиль з мого сайту»: застосунок відкриває вказану сторінку в прихованому вікні, читає кольори тла, тексту й кнопок, шрифти й заокруглення кнопок, затемнює чи освітлює колір тексту або акценту, якщо йому бракує контрасту, і пропонує результат як ще одну тему. HTML-лист має окремий шаблон — таблиці, ширина 600 пікселів, стилі в рядку, — бо поштові програми не малюють розмітку так, як браузер.
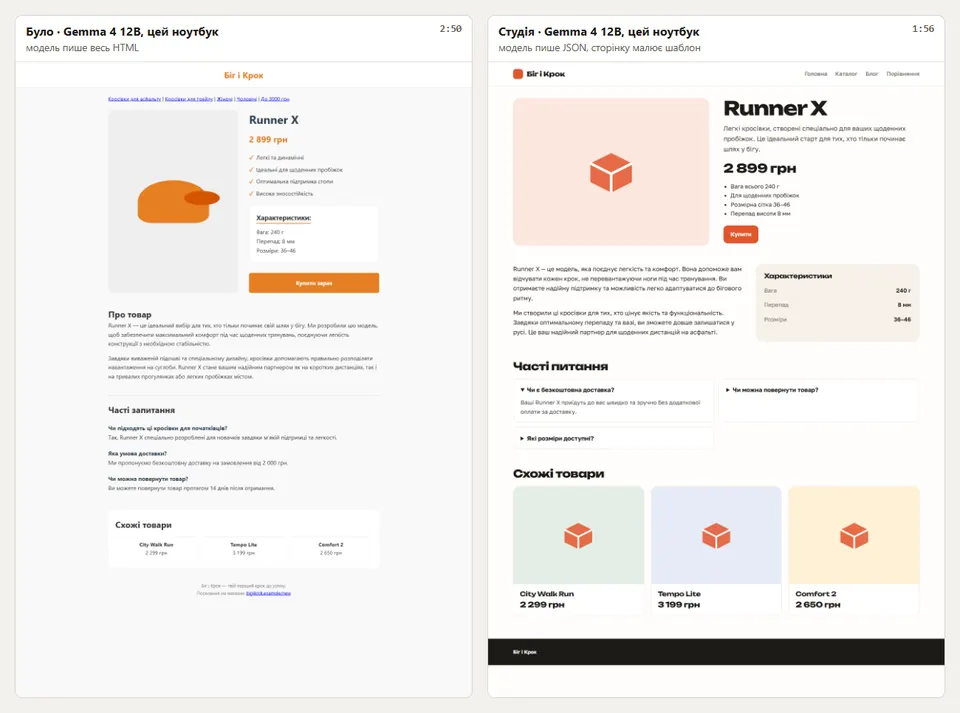
Було і стало на тій самій моделі
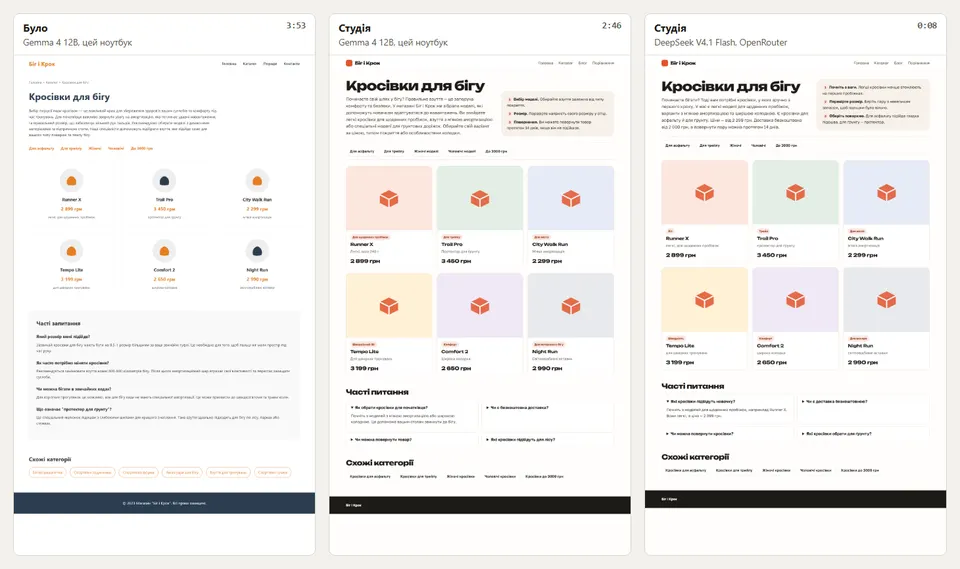
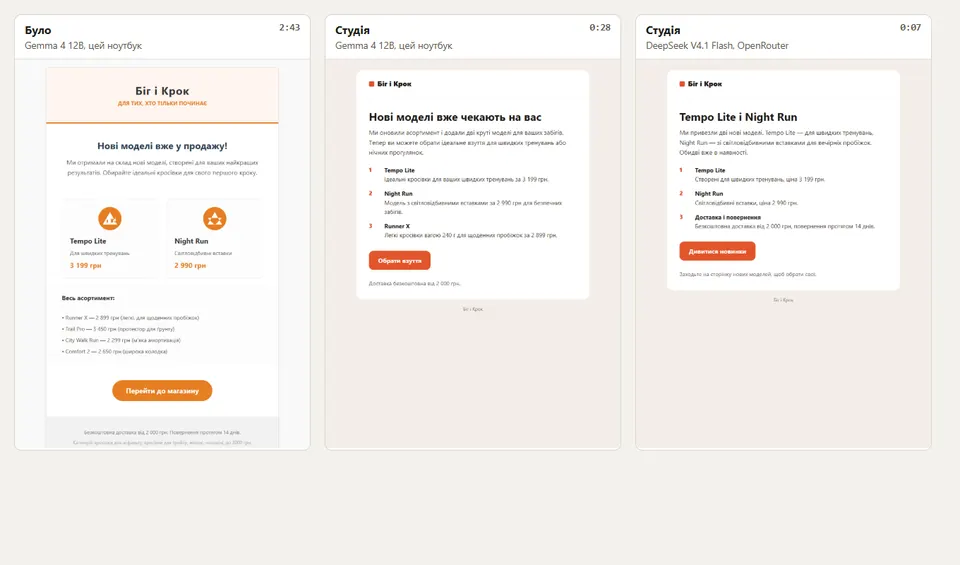
Щоб побачити, чого вартий конвеєр, ми згенерували всі шість видів двічі тією самою локальною моделлю, Gemma 4 12B, з тим самим брифом: раз по-старому, коли модель пише всю HTML-сторінку, і раз через студію. Потім ще раз прогнали студію на невеликій хмарній моделі, DeepSeek V4.1 Flash через OpenRouter, щоб показати, куди веде швидке з'єднання. Час — на сторінку, від першого виклику до готової сторінки, разом із правкою.
| Сторінка | Було: Gemma 4 12B пише HTML | Студія: Gemma 4 12B | Швидше | Студія: DeepSeek V4.1 Flash |
|---|---|---|---|---|
| Стаття | 4:36 | 3:39 | 1,3× | 0:45 |
| Головна | 3:33 | 2:21 | 1,5× | 0:16 |
| Список товарів | 3:53 | 2:46 | 1,4× | 0:08 |
| Сторінка товару | 2:50 | 1:56 | 1,5× | 0:22 |
| Альтернативи | 4:18 | 1:28 | 2,9× | 0:14 |
| HTML-лист | 2:43 | 0:28 | 5,8× | 0:07 |
У скільки разів студія швидше написала кожну сторінку на Gemma 4 12B
Швидкість — менша половина. Більша — те, що було на старих сторінках, хоча моделі цього ніхто не давав:
- рядок копірайту © 2023 на головній, у списку товарів і на сторінці альтернатив;
- «наші спеціалісти допоможуть» у списку товарів — у фактах магазину немає жодних спеціалістів;
- «Ми розробили цю модель» і «висока зносостійкість» на сторінці товару — магазин продає кросівки, а не робить їх, і про зносостійкість у фактах ані слова;
- три слова, яких немає в українській мові, у статті.
Через студію нічого з цього не лишилось. Одне проскочило на сторінці товару — «Ми створили», — і перевірка тверджень тепер ловить і таке формулювання. На головній правка переплутала питання FAQ із відповіддю, і список результатів цього не спіймав; це найслабше місце, яке ми знаємо, і наступна перевірка — що кожна відповідь стосується свого питання. DeepSeek через студію не вигадав нічого на жодній із шести сторінок.
Для чого тут годиться локальна модель
На цьому ноутбуці Gemma 4 12B через студію витрачає від однієї до чотирьох хвилин на сторінку і дає чернетку, яку треба прочитати: перевірки й одна правка ловлять більшість промахів, але не всі, а стиль тяжіє до офіційного. Це корисно, коли факти не мають покидати комп'ютер, коли треба двадцять чернеток за ніч або коли немає акаунта, який можна підключити. DeepSeek V4.1 Flash через OpenRouter написав ті самі шість сторінок у 10–20 разів швидше і нічого не вигадав, тож невелика хмарна модель — кращий щоденний вибір. Ми також дали Claude Opus один раз написати ті самі шість змістів для тих самих шаблонів — поза застосунком і без заміру часу: текст найщільніший і найчесніший (він написав «немає даних про вагу», де у фактах її не було), і він вартий того, де текст іде клієнту без редактора.
Студія не вирішує це за вас. Поруч із результатом видно, яка модель його написала, і той самий бриф можна запустити ще раз на іншій.
Як спробувати
Оновіть GLLmolfar до 0.9.36 на Windows або Mac і увійдіть; поки це експерименти, обидві функції доступні застосункам, у яких виконано вхід. Моделі — у «Налаштування › ШІ-моделі»; студія — у лівій панелі. Модель важить кілька гігабайтів, тож завантажуйте її там, де не шкода трафіку. Після завантаження вбудована модель працює без інтернету. Ми міряли лише на Windows; на Apple Silicon рушій — та сама збірка на Metal, а чисел із Mac у нас поки немає.
Одна зміна в тому, що надсилає застосунок: анонімна статистика використання тепер містить, які вбудовані моделі встановлено, лише назвами з каталогу (наприклад, gemma4-12b), щоб ми бачили, які розміри люди справді лишають. Екран налаштувань і сторінка GLLmolfar перелічують це разом з усім іншим, що надсилає застосунок; там ніколи немає адреси сайту, запиту чи того, що написала модель.
Questions people ask
Чи замінюють вбудовані моделі ChatGPT, Claude або Gemini?
Ні, і застосунок пише це в червоній рамці над моделями. Вони повільніші й частіше помиляються. Для роботи, де важлива точність, підключіть модель через OpenRouter; вбудовані — для чернеток і даних, які мають лишатися на комп'ютері.
Яку модель завантажити?
Gemma 4 12B, якщо в комп'ютері 16 ГБ пам'яті або більше: у наших тестах вона писала найчистіше п'ятьма мовами, і застосунок позначає її як рекомендовану. Gemma 4 E4B — на 8 ГБ. Gemma 4 26B A4B була найточнішою в аудиті, але просить 32 ГБ.
Чи щось покидає мій комп'ютер, коли працює вбудована модель?
Модель і рушій завантажуються один раз. Далі модель відповідає локально, і перевірки студії теж працюють локально. Статистика використання каже, які вбудовані моделі встановлено, назвою з каталогу, і нічого про те, що вони написали.
Чому перевірка йде англійською?
Щоб її результати означали одне й те саме на кожному комп'ютері й за будь-якої мови інтерфейсу. Писати вашою мовою модель потім буде в студії та інших функціях.
Чи можна публікувати написане студією, не читаючи?
Ми б не радили. Перевірки ловлять вигадані числа, контакти, роки, твердження і повтори, але не кожну помилку: на одній сторінці в наших тестах правка поміняла місцями питання й відповідь у FAQ. Вважайте результат чернеткою.
Як це міряли
Один ноутбук: AMD Ryzen 9 8945HS, вбудована графіка Radeon 780M через Vulkan, 28,8 ГБ пам'яті, Windows, 11 листопада 2026 року. Вибір моделей: Ollama, один скрипт, шість моделей, прогони на процесорі й графіці збережено в JSON для кожної моделі. Перевірка в застосунку: GLLmolfar 0.9.36, llama.cpp збірки b12284, значення, які зберегла перевірка і показує картка. Студія: один бриф для магазину кросівок із шістьма товарами, Gemma 4 12B Q4_K_M в Ollama на графіці і deepseek/deepseek-v4.1-flash через OpenRouter, повний час на сторінку. Вигадане знаходили, читаючи кожну сторінку поряд із фактами, і підтверджували пошуком у збереженому HTML. Скриншоти — GLLmolfar 0.9.36 з окремим профілем, де лежать справжній файл моделі й результат перевірки, і сторінки, які дали ці прогони.
Дивіться також: GLLmolfar.
Продукт
Стежте за кожною сторінкою щодня
Одне зчитування каже, де сторінка стоїть сьогодні. Продукт ставить ті самі питання тим самим асистентам постійно — тож про зміну вам повідомляють, а не ви йдете її шукати.
Попросити запрошенняЗа запрошеннями, поки ми тримаємо зчитування чесними
На цю тему
Чи готова моя сторінка до пошуку зі ШІ?
Щодня Краулінг із прочитанням Vectorscope біля кожної сторінки і повторна перевірка після кожного виправлення. Як працює продукт
Автор
Olexandrавтор
15+ років у маркетингу та SEO. Десятки продуктів, переважно американський ринок. Дослідження і заміри.
LinkedInPass it on
Read in your language
Opens a browser translation of this English article. The original source stays in English.