

Vectorscope як навичка агента: що ретривер залишає зі сторінки
Безкоштовна навичка Vectorscope проганяє будь-яку публічну сторінку через завантаження, очищення, нарізку і ліміт у 26 фрагментів — на вашому власному агенті. Три збережені приклади показують, що вона вимірює, що знаходить і як кожна знахідка стає виправленням.
Переклад з англійського оригіналу.
Коротка відповідь
- what
- Vectorscope 2.112 — відкрита навичка агента, що запускає завантаження, видобування тексту, нарізку і ліміт у 26 фрагментів GetLoopLoop на 1–5 публічних сторінках, перевіряє robots.txt для дванадцяти краулерів і складає один HTML-звіт із групуванням, перевіркою запитань і планом правок від агента.
- why
- Бо асистент цитує фрагменти, а не сторінки, і більшість того, що вирішує, які фрагменти взагалі існують, відбувається ще до того, як модель прочитає хоч слово. Сторінка може бути чудовою, а її найкращу відповідь однаково відріже ліміт, розітне посеред речення або вона так і не потрапить у текст.
- who
- Автори й редактори, яким треба знати, чи можна процитувати ключові абзаци сторінки; SEO-фахівці, що пояснюють, чому довга сторінка слабко виступає у відповідях ШІ; розробники, які хочуть побачити, що їхня розмітка робить із текстом.
- where
- На GitHub під ліцензією MIT, для Claude Code, Codex, opencode та інших агентів, що завантажують навички SKILL.md, а також як zip-архів для claude.ai і застосунку Claude.
- when
- Випущено 18 жовтня 2026 року. Наведені тут запуски окремих сторінок зроблено 18 жовтня 2026 року версією 2.111, порівняння — 17 жовтня 2026 року.
- how
- Детерміновані скрипти на Node виконують завантаження, очищення, нарізку, ліміт і перевірки без жодного виклику моделі чи ембедингів. Агент, що запускає навичку, читає фрагменти й пише оцінкові частини, а скрипти дослівно звіряють кожну його цитату.
Просте пояснення
ШІ-асистент не читає вашу сторінку цілком. Програма завантажує її, викидає код і меню, а решту ріже на шматки. Вона залишає щонайбільше 26 шматків, і асистент відповідає з них. Vectorscope — безкоштовний інструмент, який ви даєте своєму ШІ-помічникові. Він робить ті самі кроки з будь-якою сторінкою і показує шматки: які частини сторінки потрапили всередину, які ні, на які запитання шматки можуть відповісти і які речення переписати, щоб кожен шматок був зрозумілий сам по собі.
Минулого тижня ми представили три безкоштовні навички агента в одній статті — ШІ читає сторінку шматками. Це перший із докладних розборів, і починається він із навички, на якій збудовано дві інші: Vectorscope.
Її завдання вузьке і, як на нас, недооцінене. Вона не каже, наскільки сторінка добра. Вона показує, що ретривер із неї залишає. Асистент, відповідаючи на запитання, не читає вашу сторінку: він читає кілька фрагментів, вирізаних із неї, і те, що не пережило нарізки, процитувати неможливо, хоч яке воно добре. Навичка робить цю нарізку на вашому комп'ютері, з вашим агентом, і віддає звіт, який можна перевірити рядок за рядком.
Усе нижче взято з трьох прикладів, збережених у репозиторії: наша сторінка Vectorscope і стаття Вікіпедії про великі мовні моделі, обидві прочитані 18 жовтня 2026 року, та порівняння посібників MDN і web.dev про HTTP-кешування, прочитане 17 жовтня 2026 року. Ви можете відкрити ті самі файли й отримати ті самі числа.
Що робить навичка, крок за кроком
Навичка — це два скрипти, а між ними прочитання агента. Скрипти детерміновані: та сама сторінка дає ті самі фрагменти на будь-якому комп'ютері й із будь-якою моделлю. README репозиторію проводить межу одним рядком:
Вона не ранжує вашу сторінку, не визначає, хто її написав, і не передбачає, що про вас скаже будь-який асистент.
getlooploop-skills, README.md (переклад)
1. Читання (скрипт). read.mjs завантажує сторінку та її robots.txt, прибирає те, що прибирає очищувач ретривера (скрипти, стилі, меню, шапки, футери, прихований текст, елементи форм), ріже решту за заголовками h2 на вікна щонайбільше по 2000 символів із перекриттям 200 і зупиняється на 26 фрагментах. Ліміт — іменована константа CHUNKS_PER_PAGE = 26 у chunk.mjs. 2. Групування (оцінка). Агент читає кожен фрагмент і групує їх за темою. Вебверсія Vectorscope робить це за допомогою ембедингів; навичка не викликає ембединги, тож звіт позначає кожну групу як прочитання агента. 3. Лінза (скрипт). lens.mjs запускає перевірки, рахує фрази сторінки й будує звіт. 4. Оцінка (оцінка). Агент пише перевірку запитань, прочитання кожного фрагмента на предмет шаблонності й план правок. Скрипт відкидає будь-яку цитату, якої немає дослівно у фрагменті.
Кожне число у звіті має одну з трьох позначок: виміряне (що побачив парсер), похідне (фіксована формула над виміряним) або оцінка (прочитання агента). Знак «?» біля числа відкриває його формулу, одиницю, поріг і відомі обмеження. SKILL.md зобов'язує агента казати, що є що:
Скрипти не викликають жодної моделі й жодного API ембедингів. Прочитання — ваше; так і скажіть.
skills/vectorscope/SKILL.md, правило R6 (переклад)
Більша частина сторінки — не текст
Перше, що вимірює навичка, — яка частина завантаженого HTML узагалі варта читання. На чотирьох прикладах відповідь коливається від менш ніж третини до приблизно двох третин.
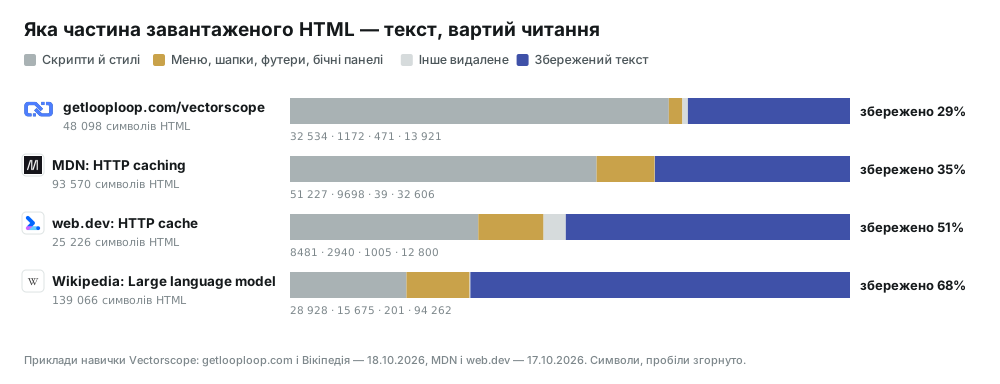
Скрипти й стилі переважають усюди. На нашій сторінці, застосунку на Next.js, це 32 534 із 48 098 символів; меню, футер і бічна панель додають лише 1172. Вікіпедія зберігає найбільше, 68%, бо вона здебільшого стаття, і найбільше, що вона втрачає після скриптів, — навігація: 14 208 символів. Саме по собі це не проблема. Ретривер і має це викидати. Рисунок потрібен для наступного запитання: яка частина збереженого тексту потрапляє у фрагмент?
Звіт відповідає на нього таблицею всіх видалених елементів, із CSS-шляхом і кількістю символів, від найбільшого. Саме в цій таблиці розробник знаходить випадки, які є проблемою: FAQ, чиї запитання сидять в елементах <button>, або основний текст усередині <aside>.
Вікіпедія: де спрацьовує ліміт у 26 фрагментів
Стаття Вікіпедії про великі мовні моделі має 13 718 слів і заповнює всі 26 місць. Навичка повідомляє про 55 001 символ за межею ліміту — це її єдина знахідка високої важливості, cap_overflow. Карта розділів показує, які саме це частини.
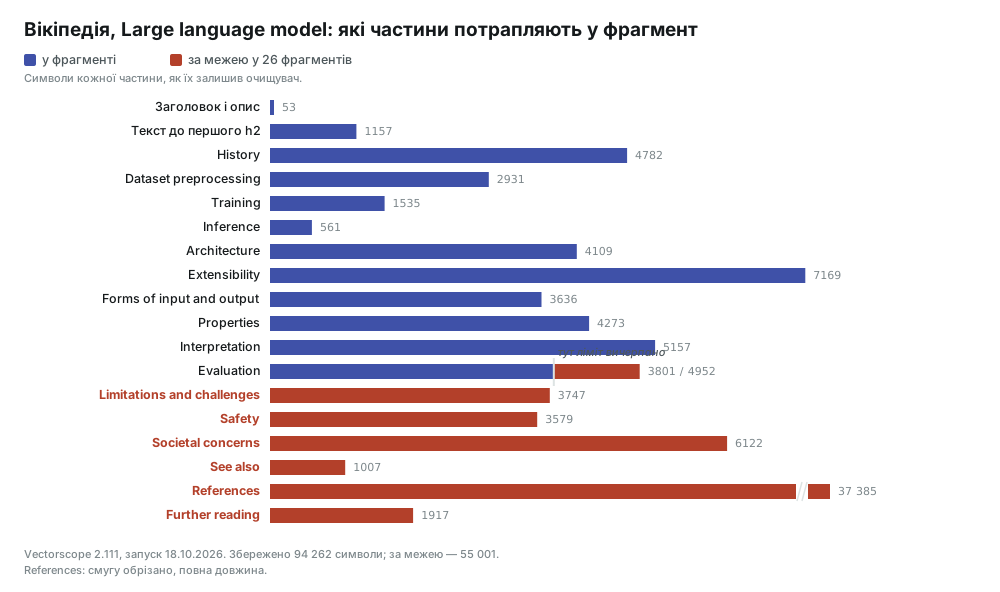
Тут важливо читати чесно. References — це 37 385 символів самі по собі, а цитувати список джерел ретриверу ні до чого. Але три з утрачених частин — це текст: Limitations and challenges, Safety і Societal concerns. Ретривер із лімітом, що читає цю статтю згори вниз, знатиме, як збудовано мовні моделі, і майже нічого про те, що з ними не так.
Перевірка запитань показує наслідок. Агент, Claude Opus 5.5 у Claude Code, склав вісім типових запитань і шукав фрагмент, що відповідає на кожне. На шість є відповідь, на п'ять — повна. На два немає жодного фрагмента: «how much energy do LLMs use» (скільки енергії споживають LLM) і «can LLMs reproduce copyrighted text» (чи можуть LLM відтворювати текст, захищений авторським правом). План правок агента називає місце цих відповідей — Societal concerns, за межею ліміту.
Саме для таких знахідок і існує інструмент: не оцінка, а місце на сторінці й причина. Перший пункт плану структурний: винести подробиці довгих середніх розділів в окремі статті, щоб пізніші розділи вмістилися в ліміт. Решта — правки рядків, кожна з початковим текстом і переписаним. У статті Вікіпедії немає метаопису, тож перший фрагмент містить лише двічі повторений заголовок:
Спробуйте на власній сторінці
Подивіться, що Vectorscope знайде на вашій сторінці
Усе, що написано вище, можна зміряти на власній роботі, і перевірка займає близько хвилини. Вставте одну адресу і прочитайте, що повернеться.
Відкрити VectorscopeБезкоштовно · без акаунта · по одній за раз
| Перевірка | До (дослівно з фрагмента) | Після (переписав агент) |
|---|---|---|
| meta_description_missing | Large language model - Wikipedia Large language model | Large language model - Wikipedia. A large language model (LLM) is a neural network trained on a vast amount of text to generate, summarise, translate and analyse language. |
| mid_sentence_start | used LSTM-based encoder-decoder architectures, as they preceded the invention of transformers. | Early neural machine translation used LSTM-based encoder-decoder architectures, because they preceded the invention of transformers. |
Другий рядок — найчастіша знахідка в прикладах. Розділ, довший за 2000 символів, розрізається вікном, і наступний фрагмент починається посеред речення, без підмета. У цій статті таких фрагментів 14. Процитоване окремо «used LSTM-based encoder-decoder architectures» не каже, хто саме їх використовував.
Наша сторінка: усе вміщується, а знахідок однаково чотири
Сторінка самого Vectorscope, прочитана того ж дня, має 2463 слова, потребує 17 фрагментів і нічого не втрачає через ліміт. Її robots.txt пускає всі дванадцять ШІ- і пошукових краулерів. Із восьми запитань, які склав агент, на шість є повна відповідь, на два — часткова. Це добра новина, і вона виміряна.
Проте вона не бездоганна, і ми навмисно залишили її такою в прикладі. Навичка знаходить чотири речі:
- Навігація всередині вмісту (середня). Порожній віджет результату стоїть усередині
main, тож його підписи кроків стають текстом фрагмента: «passages read», «slots used of the 26-passage cap». Ретривер зберігає їх як вміст. - Два фрагменти, що починаються посеред речення (середня). How to read your result — це один h2 на 2257 символів, тож вікно його розрізає, і фрагмент починається словами «to quote.».
- Тонкий розділ (низька). Під Important passage outside the cap? лише 139 символів, менше за поріг у 150.
- Фраза, що повторюється в групах (низька): одна фраза з чотирьох слів щонайменше в половині з шести груп.
До кожної є виправлення. У тонкому розділі відповідь трималася на заголовку. План перетворює «Move it earlier on the page, or split the page so that passage has a budget of its own.» на «If an important passage falls outside Vectorscope's 26-passage cap, move it earlier on the page, or split the page so that passage has a budget of its own.» Друге речення можна процитувати окремо, перше — ні. Ця одна зміна — більша частина того, що робить фрагмент придатним для цитування.
Вісім запитань до кожної сторінки
Перевірку запитань у звіті читають першою, бо вона відповідає на те, що людей справді цікавить: якщо хтось запитає ось це, чи є фрагмент із відповіддю і якими словами? На чотирьох прикладах це виглядає так.
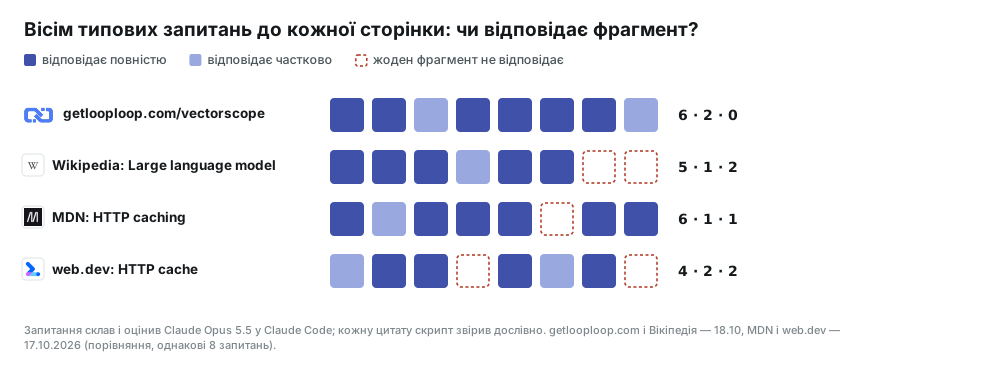
Вердикт — це оцінка агента, і звіт так і каже. Чесним його тримає цитата: вердикт «повна» мусить містити точні слова, які міг би повернути ретривер, і lens.mjs відхиляє файл, якщо цих слів немає у фрагменті. На нашій сторінці відповідь на «is Vectorscope free» — фрагмент, що починається словами «Is it really free? Yes, with a rate limit rather than a paywall.» Таке речення асистент може взяти як є.
Дві сторінки на одну тему
Режим порівняння читає 2–5 сторінок, просить агента скласти один спільний список тем і ставить сторінки поруч. У прикладі посібник MDN про HTTP-кешування змагається зі статтею web.dev про HTTP-кеш.
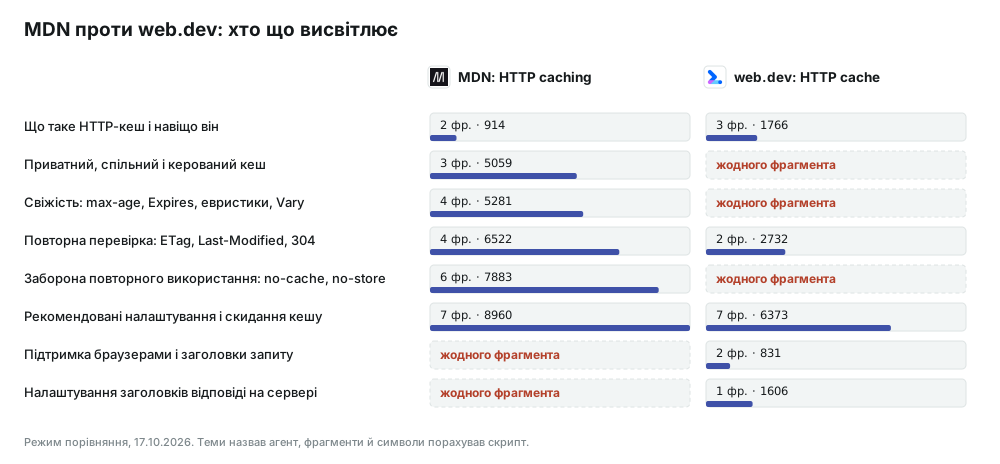
Ці дві сторінки не змагаються за одного читача, і таблиця показує це з першого погляду. MDN — довідник: шість тем, усі місця заповнено, за межею нічого. web.dev — практичний посібник: тем менше, зате лише в ньому є фрагмент про налаштування сервера. Перевірка запитань це підтверджує. У MDN немає фрагмента для «how to set caching headers in nginx»; у web.dev — для «what is a shared cache» і «does the browser revalidate when the user reloads». Якщо ви пишете третю сторінку на цю тему, ці прогалини — ваш план.
Те, що MDN точно вміщується в 26 фрагментів, — теж наслідок історії навички. До версії 2.103 заголовок h3, що повторював текст h2, розрізав розділ не в тому місці й виштовхував останній розділ MDN за ліміт. Виправлення є в журналі змін, а README каже, що тепер це місце займає останній розділ сторінки.
Що змінилося після 2.106
Огляд описував версію 2.106. Відтоді навичка читає більше і більше відмовляє, згідно з історією комітів:
| Версія | Що додано |
|---|---|
| 2.109 | Заголовки відповіді (X-Robots-Tag, Cache-Control) і перевірки доступності: зображення без alt, alt лише з назвою файлу, пропущені рівні заголовків, більше одного h1 |
| 2.110 | Відмова для російського домену, російського хостингу і сторінки, що оголошує російську версію |
| 2.111 | Наскільки згенерованим звучить текст: оцінка PatternScope, слова, якими зловживають мовні моделі, і тест на заміну від агента; звіт польською |
| 2.112 | Назва бренду з малої літери на початку фрагмента більше не вважається серединою речення; SKILL.md переписано контрольованою англійською |
Найбільший — 2.111, розділ Наскільки згенерованим звучить текст. Він проганяє детектори PatternScope по тексту сторінки, рахує слова, якими зловживають мовні моделі, і ставить агентові інше запитання про кожен фрагмент: чи пасував би він на сторінку конкурента, якщо змінити лише назву? Наша сторінка має 1 зі 100 і жодного маркерного слова, а агент вважає шаблонними 4 із 17 фрагментів, 13% тексту фрагментів. Вікіпедія має 10 зі 100 — майже все це повторювані формати цитувань у списку джерел — і 3 шаблонні фрагменти з 26. Де скрипт і агент не згодні, звіт показує обидва погляди; на нашій сторінці вони розходяться у двох фрагментах.
README прямо каже, чим цей розділ не є:
Це не детектор авторства, і блок так і каже.
getlooploop-skills, README.md, про розділ «Наскільки згенерованим звучить текст» (переклад)
Відмова з версії 2.110 — це принцип, а не технічне обмеження: сторінки російською або з російських сайтів навичка відхиляє, а не аналізує, хай що просить користувач. У прикладах це має видиму ціну. web.dev тепер оголошує російську версію, тож порівняння вище — запуск 17 жовтня, і README пояснює, чому його не перезапускали.
Встановлення і запуск
Навичці потрібен Node 20.18 або новіший і не потрібен npm install: скрипти зібрано разом з їхньою єдиною залежністю. Через skills CLI одна команда встановлює її для Claude Code, Codex, opencode та інших агентів, що завантажують навички SKILL.md:
npx skills add Olexan-art/getlooploop-skills --skill vectorscopeДалі попросіть агента звичайними словами: «запусти vectorscope на https://example.com/page» або «порівняй ці дві сторінки через vectorscope». Для claude.ai і застосунку Claude завантажте vectorscope.zip із релізів, увімкніть виконання коду і завантажте zip у розділі Customize > Skills, не розпаковуючи. Пісочниці потрібен доступ до мережі для сайту, який вона читає. Якщо мережі немає зовсім, збережіть сторінку як HTML і дайте файл агентові; звіт позначить кожну перевірку, що потребувала мережі, як неперевірену. Покрокова інструкція — на сторінці Vectorscope для Claude. Під капотом агент запускає:
node dist/read.mjs https://example.com/page --out reading.json
# агент читає фрагменти й пише groups.json
node dist/lens.mjs reading.json groups.json --html report.html
# агент пише queries.json, style.json і plan.json
node dist/lens.mjs reading.json groups.json --queries queries.json \
  --style style.json --plan plan.json --html report.html --md report.md --json export.json

# порівняння 2–5 сторінок
node dist/read.mjs <url1> <url2> --out-dir readings
Чого вона не робить
- Це не конвеєр жодного асистента. ChatGPT, Gemini, Perplexity та інші не публікують, як їхні краулери ріжуть сторінки і де зупиняються. Навичка відтворює типовий ретривер, а ліміт у 26 фрагментів — власний ліміт Vectorscope. Він робить вимірюваним запитання «яку частину ретривер із лімітом ніколи не прочитає»; він не стверджує, що якийсь асистент ріже саме на 26.
- Ні оцінки, ні прогнозу. Вона не ранжує сторінку і не каже, що асистент відповість про вас.
- Оцінкові частини — прочитання однієї моделі. Групи, вердикти запитань, шаблонні фрагменти і план пише агент, який запустив навичку. Скрипти перевіряють цитати, але інша модель може згрупувати трохи інакше.
- Без ембедингів. Згуртованість, самоподібність і карта потребують векторів, і навичка повідомляє їх порожніми замість того, щоб вигадувати. Карту ембедингів малює вебверсія Vectorscope.
- Лише публічні сторінки. Без входу, без cookies, без приватних адрес.
Висновок
Три речі роблять цю навичку вартою встановлення, і кожну видно у файлах прикладів, а не лише обіцяно.
Вона знаходить місце, а не ставить оцінку. На Вікіпедії вона не сказала «сторінка задовга». Вона сказала, що ліміт вичерпується посеред Evaluation, що Limitations and challenges, Safety і Societal concerns не потрапляють у жоден фрагмент і що через це два звичайні запитання лишаються без відповіді. З такою знахідкою редактор упорається за пообіддя.
Кожне виправлення можна перевірити. Кожна правка в плані цитує фрагмент як він є і дає його таким, яким він має бути, а скрипт відхиляє будь-яку цитату, що не збігається дослівно. Вам не треба вірити прочитанню агента на слово; його можна порівняти.
Вона працює там, де ваші сторінки. Без облікового запису, без завантаження файлів на сервер, без викликів моделей зі скриптів, і нічого не надсилається в GetLoopLoop. Та сама сторінка дає ті самі фрагменти на будь-якому комп'ютері. Сторінка, що вміщується в ліміт, відповідає на свої запитання реченнями, зрозумілими без контексту, і пускає потрібних краулерів, — це сторінка, яку асистент може процитувати, а наша власна сторінка показує, що шлях до цього — короткий список.
Запустіть її на сторінці, яка для вас найважливіша. Якщо приклади щось показують, перший звіт назве щось конкретне, що треба виправити, а другий покаже це виправленим. А коли захочете знати, що асистенти справді кажуть про вас тиждень за тижнем, — це те, що вимірює GetLoopLoop.
Questions people ask
Навичка Vectorscope безкоштовна?
Так. Вона відкрита під ліцензією MIT, працює на вашому власному агенті, а її скрипти не викликають жодної моделі й жодного платного сервісу.
Чи надсилає вона мою сторінку в GetLoopLoop?
Ні. Скрипти завантажують сторінку та її robots.txt, роблять один DNS-запит і один запит RDAP, щоб з'ясувати, де розміщено сайт, і пишуть звіт на вашому комп'ютері. HTML-звіт блокує будь-які мережеві запити з себе.
Чому саме 26 фрагментів?
Це ліміт Vectorscope, фіксована й іменована константа, а не число, яке публікує якийсь асистент. Відомий ліміт перетворює запитання, яку частину сторінки ретривер із лімітом ніколи не прочитає, на те, що можна виміряти.
Чим вона відрізняється від вебверсії Vectorscope?
Вебінструмент групує фрагменти за ембедингами і малює карту. Навичка не викликає ембединги: агент читає фрагменти й групує їх, а також додає перевірку запитань, план правок і прочитання того, наскільки шаблонний текст.
Чи можна порівняти мою сторінку зі сторінкою конкурента?
Так. Режим порівняння читає 2–5 сторінок і ставить їх в одну таблицю спільних тем, із прогалинами в темах, прогалинами у фактах і тим, яка сторінка відповідає на кожне запитання.
Які агенти можуть її запустити?
Claude Code, Codex, opencode, Hermes Agent та інші агенти, що завантажують навички SKILL.md, а також claude.ai і застосунок Claude з увімкненим виконанням коду.
Продукт
Стежте за кожною сторінкою щодня
Одне зчитування каже, де сторінка стоїть сьогодні. Продукт ставить ті самі питання тим самим асистентам постійно — тож про зміну вам повідомляють, а не ви йдете її шукати.
Попросити запрошенняЗа запрошеннями, поки ми тримаємо зчитування чесними
На цю тему
Чи готова моя сторінка до пошуку зі ШІ?
Щодня Краулінг із прочитанням Vectorscope біля кожної сторінки і повторна перевірка після кожного виправлення. Як працює продукт
Автор
Olexandrавтор
15+ років у маркетингу та SEO. Десятки продуктів, переважно американський ринок. Дослідження і заміри.
LinkedInPass it on
Read in your language
Opens a browser translation of this English article. The original source stays in English.