

Усі сценарії/ Агенція
Свої дані з кожної сторінки: правила витягу і питання до моделі
Клієнт хоче таблицю, якої немає в жодному стандартному звіті: у яких товарах немає ціни, на яких сторінках немає тегу аналітики, хто автор кожної статті, якому наміру відповідає кожна сторінка. Частину можна витягти з HTML правилом, частину може сказати лише той, хто сторінку прочитав.
- Хто
- Агенція або аналітик, що готує нестандартні звіти
- Сайт
- Магазин, медіа чи сайт послуг клієнта
- Що болить
- Потрібні дані, яких немає в жодній вкладці, і ручний перегляд сотень сторінок
- Що треба
- Своя колонка для кожної сторінки, яку можна відфільтрувати й вивантажити
Кроки в Molfar
Задайте правила до сканування
«Власний витяг і пошук…» в меню сканування (Ctrl+Shift+K) приймає правила п'яти видів: CSS-селектор, XPath (підмножина), регулярний вираз, «HTML містить» і «HTML не містить». Для кожного вибирається, що взяти: текст, внутрішній HTML, значення атрибута, кількість або так/ні. Так перевіряють, чи є на сторінці тег аналітики, чи вказана ціна, скільки на сторінці відгуків.
Власний витяг і пошук — документація (англійською)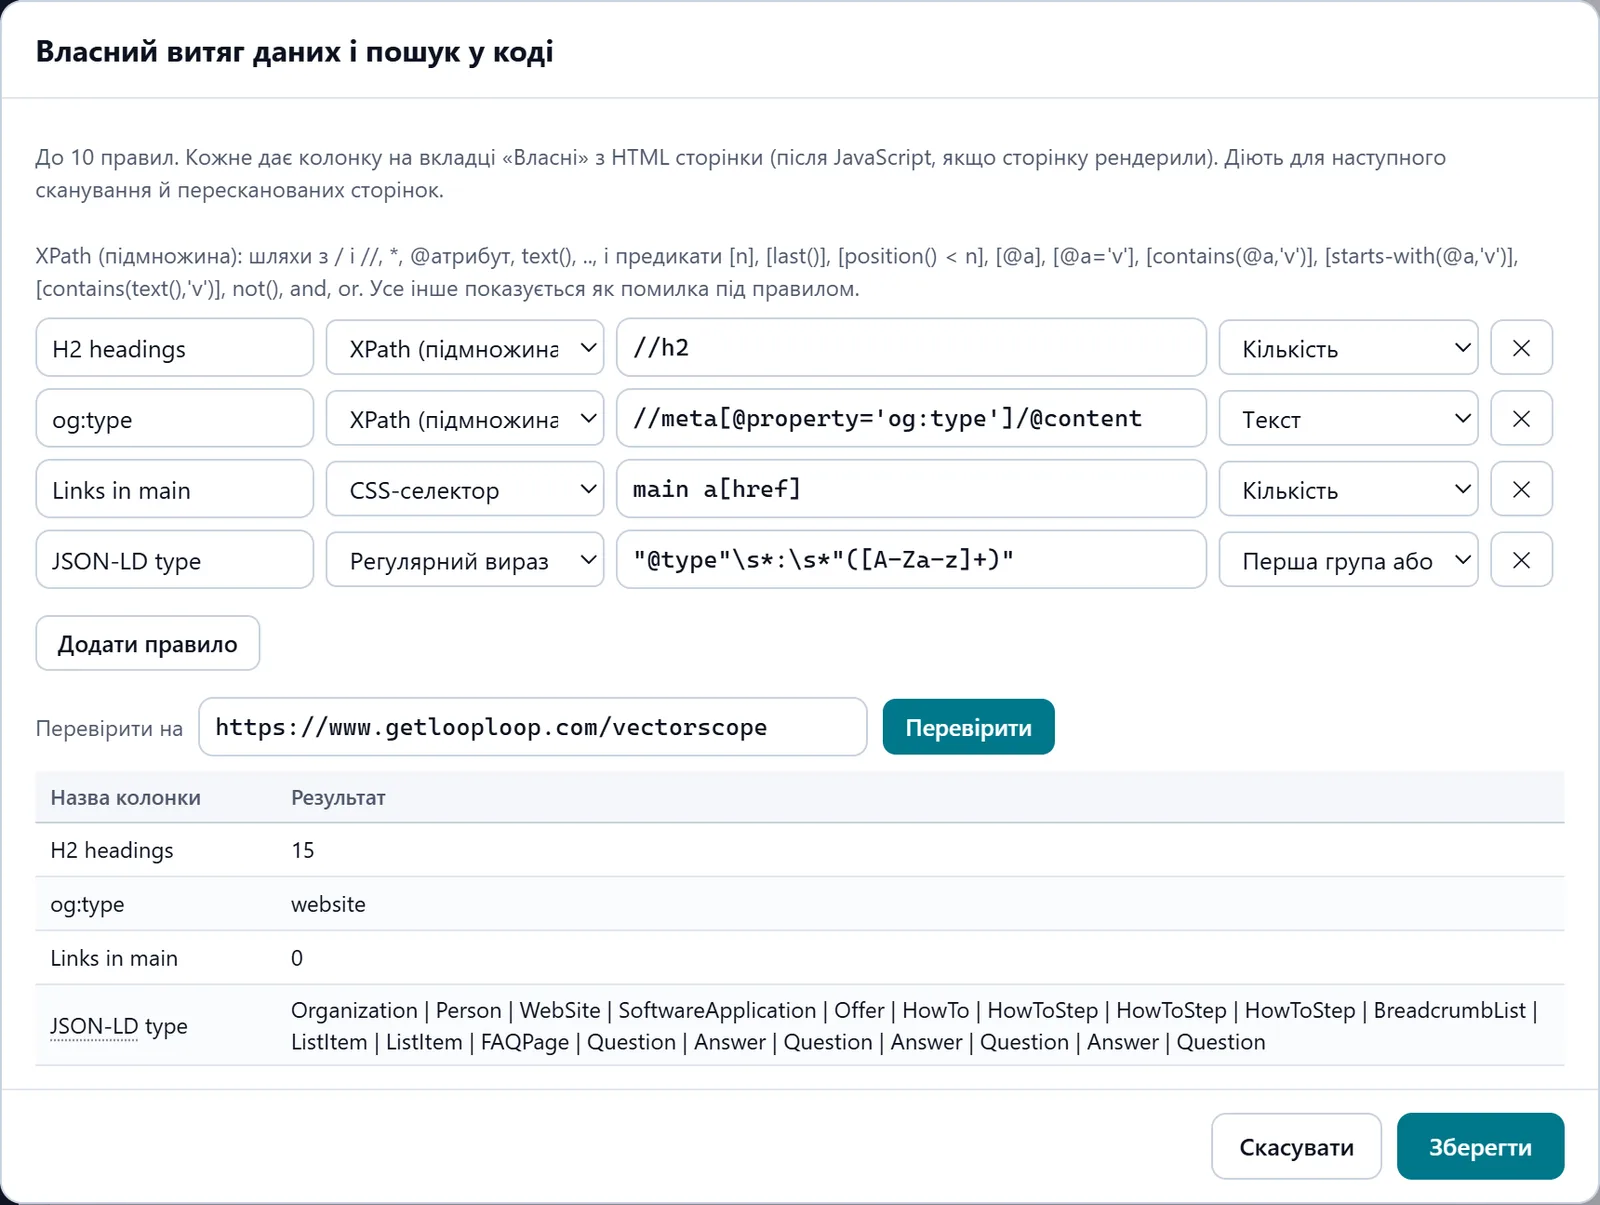
На знімку: Власний витяг Проскануйте й відкрийте «Власні»
Правила виконуються під час сканування, на відрендереному HTML там, де сторінку було відрендерено. Результат кожного правила — окрема колонка у вкладці «Власні», яку можна фільтрувати, сортувати й вивантажити разом з рештою таблиці.
Власні — документація (англійською)На знімку: Власний витяг Поставте питання там, де правило не дістане
«Агент · тест» › «Промпт по сторінках» ставить одне питання кожній сторінці: назва колонки, питання з підстановками {url}, {title}, {h1} і {meta}, і які сторінки — усі індексовані HTML-сторінки або сторінки однієї перевірки. Текст сторінки йде разом із питанням.
Агент · тест — документація (англійською)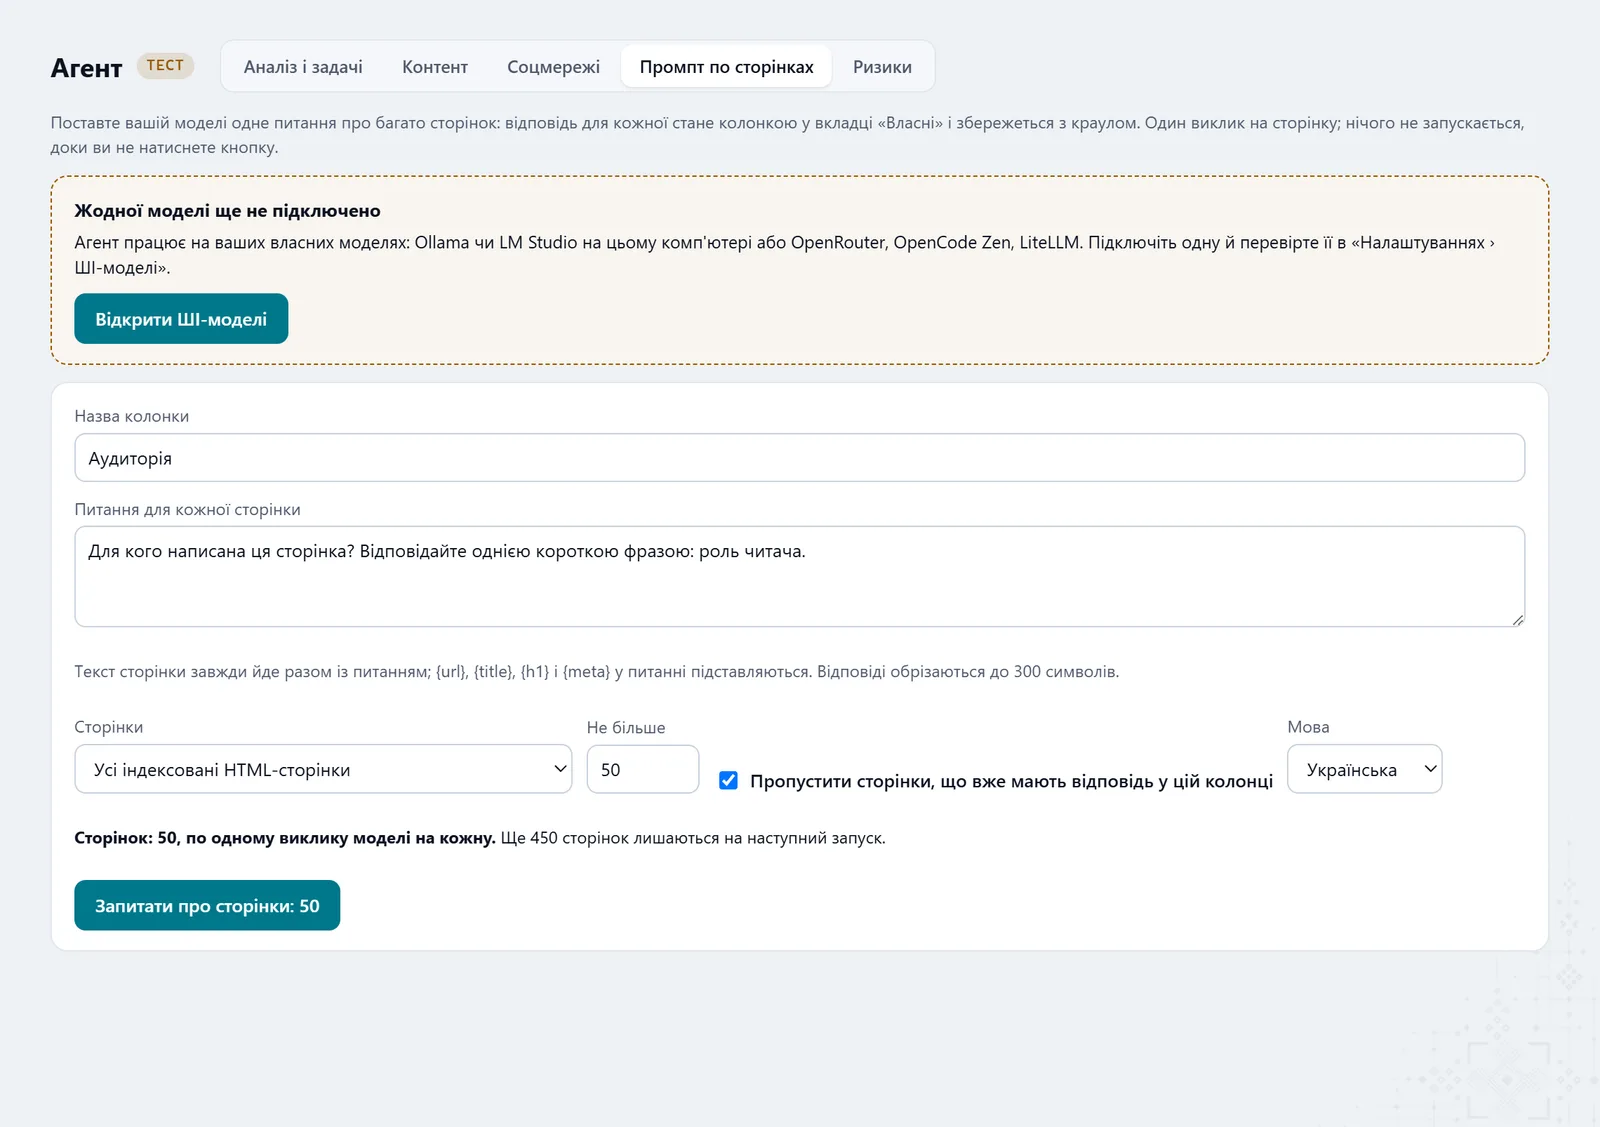
На знімку: Промпт по сторінках Побачте обсяг до запуску
Перед стартом кнопка каже, про скільки сторінок буде питання, а рядок під нею — що це по одному виклику моделі на сторінку. Питання йдуть до моделі, яку ви підключили в налаштуваннях моделей: локальної чи хмарної, на ваш вибір.
Агент · тест — документація (англійською)На знімку: Промпт по сторінках Читайте відповіді поруч з рештою даних
Відповіді лягають колонкою у вкладку «Власні» поруч із колонками правил. Наступний запуск може пропустити сторінки, що вже мають відповідь, тож колонку можна дозаповнювати частинами.
Власні — документація (англійською)На знімку: Промпт по сторінках Або доручіть це агентові
Через MCP агент може поставити ту саму колонку. Без підтвердження він лише рахує сторінки й виклики моделі і показує це вам; запуск відбувається тільки з явним підтвердженням.
Підключення агента (MCP) — документація (англійською)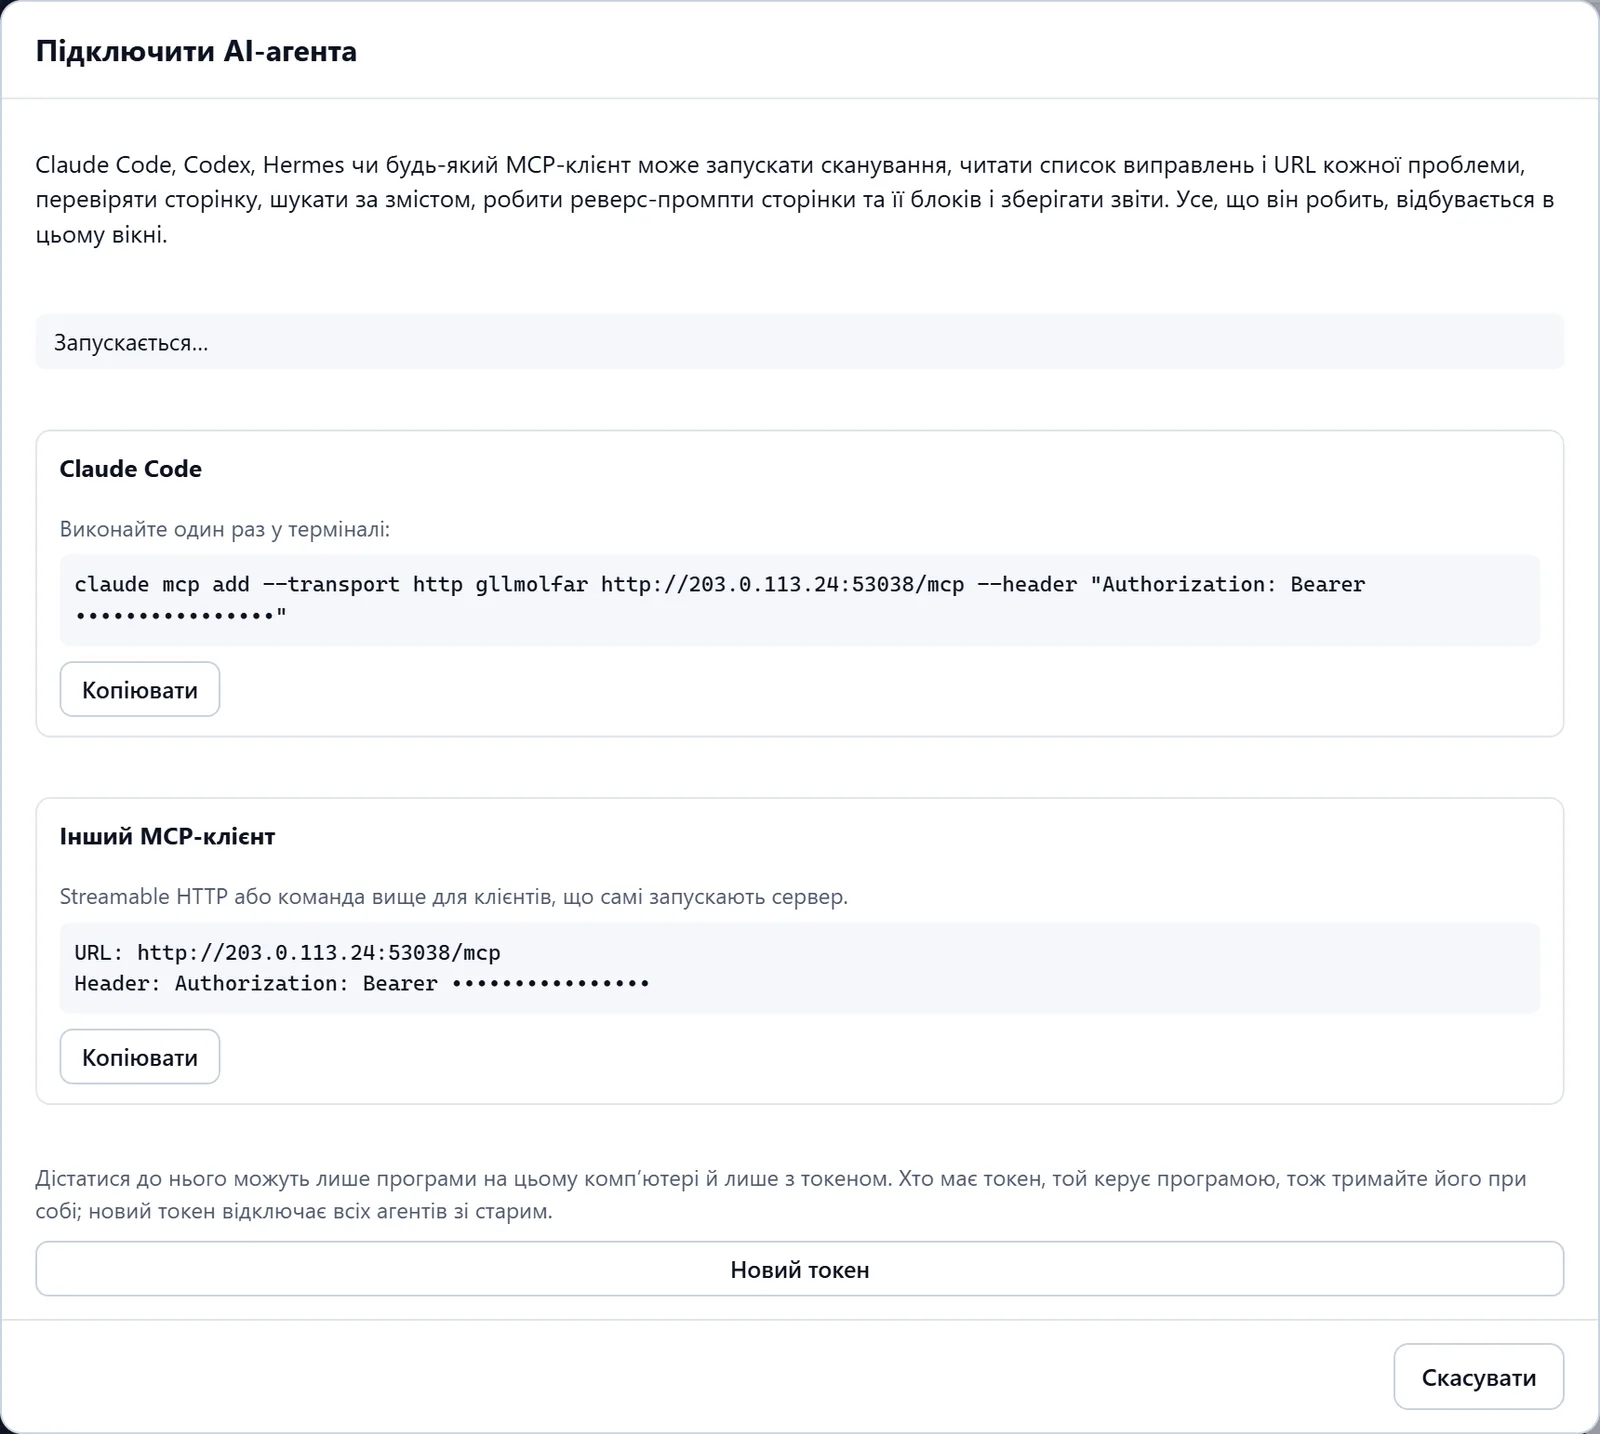
На знімку: Підключення AI-агента (MCP)
Що ви отримаєте
Колонки з HTML
Ціни, автори, наявність тегів і будь-що, що можна знайти правилом, для кожної сторінки.
Колонка від моделі
Відповідь на ваше питання для кожної сторінки: намір, тип, тон, будь-що, що треба прочитати.
Одна таблиця для звіту
Усе поруч із технічними даними сканування, з фільтрами й експортом.
Що варто знати
- XPath — це підмножина: шляхи, атрибути, text() і поширені предикати (contains, starts-with, позиція). Осі на кшталт ancestor::, об'єднання через | і функції на зразок count() не підтримуються: такий вираз показується як помилка під правилом, а не як порожня колонка.
- Відповіді моделі короткі й можуть помилятися: перегляньте вибірку, перш ніж нести колонку клієнту.
- Сторінка, що змінилася після відповіді, зберігає стару відповідь, доки ви не вимкнете пропуск сторінок з відповіддю.
- З хмарною моделлю текст сторінок іде до її провайдера; з локальною лишається на вашому комп'ютері.
Питання
- Яку модель використовує колонка?
- Ту, яку ви підключили в налаштуваннях моделей Molfar. Molfar не підставляє свою.
- Чи можна задати питання лише частині сторінок?
- Так: замість усіх індексованих сторінок оберіть сторінки однієї перевірки, наприклад тонкий контент чи сторінки без meta description.
- Правила працюють на сторінках з JavaScript?
- Так, якщо сторінку було відрендерено: тоді правило бачить HTML після JavaScript.